深度生成模型:要學什麼、怎麼量好壞、難在哪裡
在談 diffusion 之前,這一章先把「生成模型」這件事講清楚:手上只有一堆樣本,要學一個能產生新樣本的分佈;要用某種「散度」衡量模型和資料差多遠;而最大的技術障礙,是讓一個神經網路的輸出變成合法的機率密度時,冒出來的那個算不出來的歸一化常數。各家生成模型,其實都是在用不同方法繞過它。
讀完這頁你應該能夠
- 用白話說出生成模型想從資料學到什麼,以及「\(p_{\bm\phi^\times}\approx p_{\text{data}}\)」為什麼只能是概念上的近似。
- 推導「最小化 forward KL ⟺ 最大化 log-likelihood(MLE)」,並說明為什麼不知道 \(p_{\text{data}}\) 也能訓練。
- 說明 forward KL 的 mode covering 行為、Fisher divergence 為什麼不受歸一化常數影響,以及 \(f\)-divergence 和 Wasserstein 距離各自在比什麼。
- 解釋把網路輸出變成合法密度時,為什麼會卡在歸一化常數 \(Z(\bm\phi)\)。
- 說出 EBM、autoregressive、VAE、normalizing flow、GAN、diffusion 各自怎麼表示分佈、怎麼訓練、怎麼生成,以及顯式和隱式模型的差別。
前置知識
- 機率密度、期望值、條件機率、對數。
- 神經網路是一個帶參數的函數,用梯度下降訓練。
- 如果對 KL divergence 和 MLE 完全陌生,可以先看 CS236 第 4 講的 KL divergence 與 MLE 兩節(該頁的 B2、B3 節);這一章的內容是那幾節的濃縮版。
本頁照書的順序轉述,「書 §x.y」標出原文位置。灰框「轉述者補充」是書裡沒有、我加上的背景或解讀;藍框「推導」是書中省略或一筆帶過的步驟展開。記號沿用書的寫法:模型參數是 \(\bm\phi\),訓練完成、固定下來的參數記成 \(\bm\phi^\times\),最佳解記成 \(\bm\phi^*\)。
01問題設定:從資料學一個分佈書 §1.1.1
書一開頭引了 Feynman 的話:「What I cannot create, I do not understand.」生成模型想做的,就是讓機器「造得出來」。
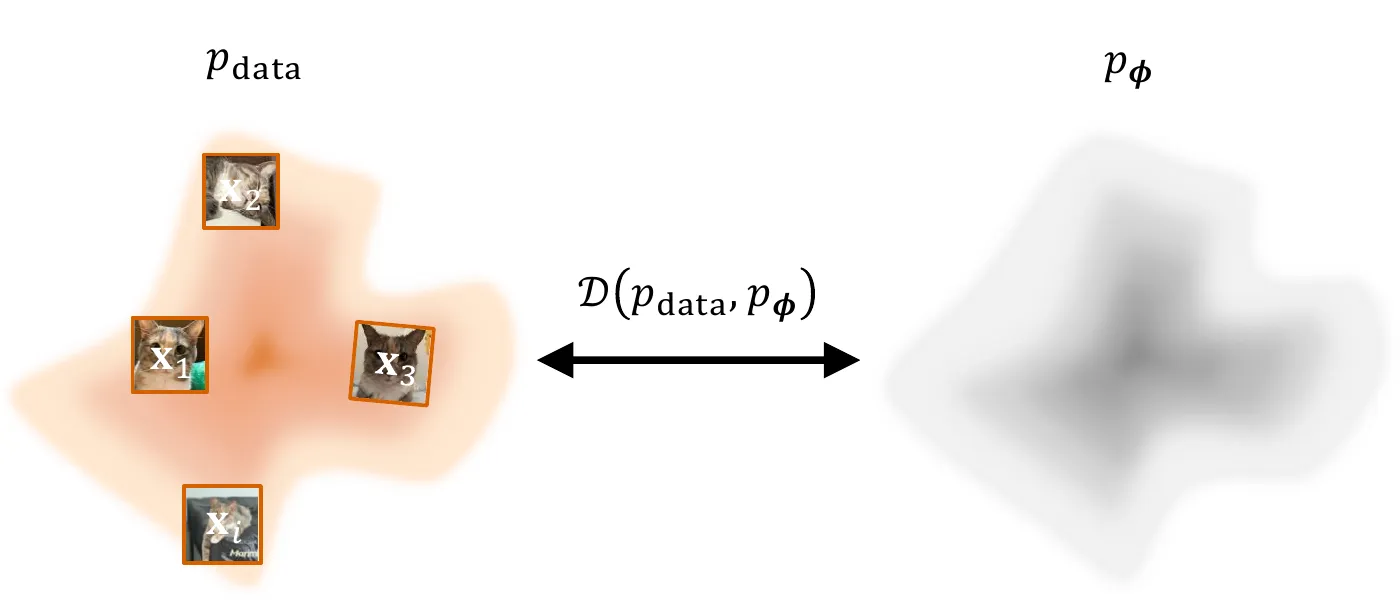
書在章首用一段話給出定義:深度生成模型是學習高維資料(圖片、文字、聲音)上機率分佈的神經網路,學好之後就能生成和資料集相像的新例子。模型分佈記作 \(p_{\bm\phi}\)、資料分佈記作 \(p_{\text{data}}\);用有限的資料集,最小化一個衡量兩者差距的損失來擬合 \(\bm\phi\)。訓練完成後,生成就是執行模型的抽樣程序得到 \(\mathbf x\sim p_{\bm\phi}\)(密度 \(p_{\bm\phi}(\mathbf x)\) 能不能直接算,要看模型家族)。模型好不好,是看生成的樣本和它們的統計摘要跟 \(p_{\text{data}}\) 對得多好,再加上針對任務或感知的指標。
具體來說:我們手上有一組有限的樣本 \(\{\mathbf x^{(i)}\}_{i=1}^N\),例如圖片、聲音、文字。我們假設它們是從某個資料分佈 \(p_{\text{data}}\) 抽出來的,但這個分佈本身我們不知道:沒有它的公式,也沒辦法向它要新的樣本。我們看得到的只有這 \(N\) 個例子。
生成模型的輸入是這堆樣本,輸出是一個訓練好的神經網路,它代表一個近似分佈 \(p_{\bm\phi}\)。目標有兩個:
- 逼真的生成:產生新的、和真實資料分不出來的樣本。
- 可控的生成:能細緻、可解釋地控制生成過程(例如指定類別、文字描述)。
訓練完成後,參數固定成 \(\bm\phi^\times\),我們希望在「和生成有關的方面」
$$p_{\bm\phi^\times}\approx p_{\text{data}}.$$書特別提醒:這個「約等於」是概念上的。資料有限、模型容量有限、最佳化也不完美,兩個分佈不可能真的一模一樣。我們要的是模型抓到足夠多的結構,能生出逼真而多樣的新例子。
訓練好之後,生成就是從模型抽一個新樣本:\(\mathbf x\sim p_{\bm\phi^\times}\)。不同家族的模型有不同的抽樣機制。有些模型還能告訴你某個樣本的密度 \(p_{\bm\phi}(\mathbf x)\) 是多少,有些模型只定義了「怎麼抽」,沒辦法算密度。這個差別在第 7 節的分類會再出現。
訓練:最小化一個「差距」
挑一個模型家族 \(\{p_{\bm\phi}\}\),再挑一個衡量兩個分佈差多遠的量 \(\mathcal D\)(稱為 discrepancy 或 divergence),然後解
$$\bm\phi^*\in\arg\min_{\bm\phi}\ \mathcal D(p_{\text{data}},p_{\bm\phi}).$$這裡有一個實務上的硬性要求:因為 \(p_{\text{data}}\) 未知,選來的 \(\mathcal D\) 必須能只用 \(p_{\text{data}}\) 的 i.i.d. 樣本有效率地估計。只要模型容量夠大,\(p_{\bm\phi^*}\) 就能很接近 \(p_{\text{data}}\)。下面幾節介紹最常見的幾種 \(\mathcal D\)。
02Forward KL 與最大概似估計(MLE)書 §1.1.1
怎麼挑參數,才能讓 \(p_{\bm\phi}\) 像 \(p_{\text{data}}\)?如果模型的密度算得出來,一個很自然的想法是:讓真實資料在模型下得到高密度。這就是最大概似估計(maximum likelihood estimation,MLE)。
名詞:固定一個觀測到的樣本 \(\mathbf x\),把 \(p_{\bm\phi}(\mathbf x)\) 看成參數 \(\bm\phi\) 的函數,就叫 likelihood(概似)。對連續資料,\(p_{\bm\phi}(\mathbf x)\) 是密度,不是「剛好觀測到 \(\mathbf x\)」的機率。
把這個想法寫嚴謹,要用 (forward) Kullback–Leibler divergence:
$$\mathcal D_{\mathrm{KL}}(p_{\text{data}}\Vert p_{\bm\phi}) := \int p_{\text{data}}(\mathbf x)\log\frac{p_{\text{data}}(\mathbf x)}{p_{\bm\phi}(\mathbf x)}\,d\mathbf x = \mathbb E_{\mathbf x\sim p_{\text{data}}}\big[\log p_{\text{data}}(\mathbf x)-\log p_{\bm\phi}(\mathbf x)\big].$$(書註明這裡的積分都是 Lebesgue 積分,對離散資料就變成加總。)KL 不對稱:一般來說 \(\mathcal D_{\mathrm{KL}}(p_{\text{data}}\Vert p_{\bm\phi})\neq\mathcal D_{\mathrm{KL}}(p_{\bm\phi}\Vert p_{\text{data}})\)。
不知道 \(p_{\text{data}}\) 也能用
乍看之下,forward KL 用不了,因為式子裡有未知的 \(p_{\text{data}}(\mathbf x)\)。但把它拆開:
$$\mathcal D_{\mathrm{KL}}(p_{\text{data}}\Vert p_{\bm\phi}) = -\mathbb E_{\mathbf x\sim p_{\text{data}}}\big[\log p_{\bm\phi}(\mathbf x)\big]-\mathcal H(p_{\text{data}}),\qquad \mathcal H(p_{\text{data}}) := -\mathbb E_{\mathbf x\sim p_{\text{data}}}\big[\log p_{\text{data}}(\mathbf x)\big].$$第二項是資料分佈的熵(entropy),和 \(\bm\phi\) 無關。所以就算算不出它,也不影響我們對 \(\bm\phi\) 做最佳化。
實務上,對 \(p_{\text{data}}\) 的期望值用手上的訓練樣本取平均(假設它們 i.i.d. 來自 \(p_{\text{data}}\)),得到經驗的負 log-likelihood:
$$\hat{\mathcal L}_{\text{MLE}}(\bm\phi) := -\frac1N\sum_{i=1}^N\log p_{\bm\phi}\big(\mathbf x^{(i)}\big),$$再用 minibatch 的隨機梯度去最小化它。重點是:MLE 只需要 \(p_{\text{data}}\) 的樣本,不需要算 \(p_{\text{data}}\) 的密度。
方向很重要:mode covering
KL 的方向決定了「差距是在誰的樣本上平均」。Forward KL 是對 \(p_{\text{data}}\) 取期望,所以資料會出現的地方,模型都得照顧到;reverse KL \(\mathcal D_{\mathrm{KL}}(p_{\bm\phi}\Vert p_{\text{data}})\) 則是對模型自己的樣本取平均。
書用一個例子說明後果。假設有一塊區域 \(A\),資料在那裡有正的機率,\(p_{\text{data}}(A)>0\),但模型在那裡的密度是 0。那麼在 \(A\) 上
$$\log\frac{p_{\text{data}}(\mathbf x)}{p_{\bm\phi}(\mathbf x)}=+\infty,$$forward KL 直接變成無限大。所以最小化 forward KL 會嚴厲懲罰「完全漏掉某一塊資料」的模型,模型寧可把機率攤開、把每個 mode 都蓋到。這種行為叫 mode covering。Demo A 可以直接看到它。
反過來的 reverse KL 會怎樣?
書在這裡只講了 forward KL。補一句對照:reverse KL \(\mathbb E_{\mathbf x\sim p_{\bm\phi}}[\log p_{\bm\phi}(\mathbf x)/p_{\text{data}}(\mathbf x)]\) 是在模型的樣本上平均,模型在資料沒有的地方放機率會被重罰,但漏掉某個資料 mode 卻幾乎不痛。所以它傾向於只抓住一個 mode、而且抓得很緊,稱為 mode seeking。Demo A 裡 reverse KL 的最佳解就落在左邊那個比較重的峰上。
03Fisher divergence:比的是斜率書 §1.1.1
另一個對 diffusion 特別重要的量,是 Fisher divergence:
$$\mathcal D_{\mathrm F}(p\Vert q) := \mathbb E_{\mathbf x\sim p}\Big[\big\Vert\nabla_{\mathbf x}\log p(\mathbf x)-\nabla_{\mathbf x}\log q(\mathbf x)\big\Vert_2^2\Big].$$它比的是兩個分佈的 score function \(\nabla_{\mathbf x}\log p(\mathbf x)\):對 \(\mathbf x\) 的梯度,是一個向量場,每一點的箭頭都指向機率變高的方向。它有幾個性質:
- \(\mathcal D_{\mathrm F}(p\Vert q)\ge0\),而且等號成立若且唯若 \(p=q\)(幾乎處處)。
- 不受歸一化常數影響:score 只依賴 log 密度的梯度,把密度乘上任何常數,log 只差一個常數,梯度不變。
- 它是 score matching 的基礎(第 3 章):拿 \(p=p_{\text{data}}\) 當目標,訓練模型 \(q=p_{\bm\phi}\) 的 score 場去對齊資料的 score 場。
為什麼 Fisher divergence 不在乎歸一化常數
設 \(q(\mathbf x)=\tilde q(\mathbf x)/Z\),其中 \(Z\) 是和 \(\mathbf x\) 無關的常數。則 \(\log q(\mathbf x)=\log\tilde q(\mathbf x)-\log Z\),對 \(\mathbf x\) 取梯度:
$$\nabla_{\mathbf x}\log q(\mathbf x)=\nabla_{\mathbf x}\log\tilde q(\mathbf x)-\underbrace{\nabla_{\mathbf x}\log Z}_{=\,0}=\nabla_{\mathbf x}\log\tilde q(\mathbf x).$$所以只要知道「沒歸一化」的 \(\tilde q\),score 就完全確定。這正是第 5 節那個算不出來的 \(Z(\bm\phi)\) 可以被繞開的原因。
04KL 以外的選擇書 §1.1.1
KL 最常用,但不是唯一的選擇。不同的散度代表不同的「接近」概念,會帶來不同的最佳化行為。
\(f\)-divergence 家族
給一個凸函數 \(f:\mathbb R_+\to\mathbb R\),而且 \(f(1)=0\),定義
$$\mathcal D_f(p\Vert q)=\int q(\mathbf x)\,f\!\left(\frac{p(\mathbf x)}{q(\mathbf x)}\right)d\mathbf x.$$它看的是兩個密度在每一點的比值。換不同的 \(f\) 就得到熟悉的散度:
| \(f(u)\) | 得到的散度 |
|---|---|
| \(u\log u\) | forward KL \(\mathcal D_{\mathrm{KL}}(p\Vert q)\) |
| \(\tfrac12\big[u\log u-(u+1)\log\tfrac{1+u}{2}\big]\) | Jensen–Shannon \(\mathcal D_{\mathrm{JS}}(p\Vert q)\) |
| \(\tfrac12\vert u-1\vert\) | total variation \(\mathcal D_{\mathrm{TV}}(p,q)\) |
寫開來就是
$$\mathcal D_{\mathrm{JS}}(p\Vert q)=\tfrac12\mathcal D_{\mathrm{KL}}\big(p\,\Vert\,\tfrac12(p+q)\big)+\tfrac12\mathcal D_{\mathrm{KL}}\big(q\,\Vert\,\tfrac12(p+q)\big),$$ $$\mathcal D_{\mathrm{TV}}(p,q)=\tfrac12\int_{\mathbb R^D}\vert p-q\vert\,d\mathbf x=\sup_{A\subset\mathbb R^D}\vert p(A)-q(A)\vert.$$直覺上,JS 是一個平滑、對稱的量,兩邊都照顧到,也不會像 KL 那樣出現無限大的懲罰(之後會看到它和 GAN 的關係);TV 則是兩個分佈對同一個事件給出的機率,最多能差多少。
驗證:\(f(u)=\tfrac12[u\log u-(u+1)\log\tfrac{1+u}{2}]\) 真的給出 JS
令 \(m=\tfrac12(p+q)\),代入 \(u=p/q\):
$$\int q\,f\!\left(\tfrac pq\right)=\tfrac12\int\Big[p\log\tfrac pq-(p+q)\log\tfrac{p+q}{2q}\Big]=\tfrac12\int\Big[p\log p-p\log q-(p+q)\log m+(p+q)\log q\Big].$$\(-p\log q\) 和 \(+p\log q\) 抵消,剩下
$$\tfrac12\int\Big[p\log\tfrac pm+q\log\tfrac qm\Big]=\tfrac12\mathcal D_{\mathrm{KL}}(p\Vert m)+\tfrac12\mathcal D_{\mathrm{KL}}(q\Vert m).$$另一種思路:Wasserstein 距離
來自 optimal transport(第 7 章)的 Wasserstein 距離,量的是「把一堆機率質量搬成另一堆,最少要花多少搬運成本」。和 \(f\)-divergence 比密度的比值不同,它看樣本空間的幾何:兩個分佈的支撐集完全不重疊時,它依然有意義。(轉述者註:這時搬得越遠成本越高;相比之下,KL 會是無限大,JS 會卡在常數 \(\log2\),都看不出兩者差多遠。)
每一種散度都代表一種「接近」的概念,因此會導致不同的學習行為。書說這些散度在後面各章遇到時還會再出現。
Demo A散度實驗室:同一個分佈,六種量法轉述者補充
灰色的 \(p\) 是兩個高斯的混合(權重 0.6 和 0.4,位置 \(-2\) 和 \(1.5\))。藍色的 \(q\) 是一個單一高斯,你可以調它的平均和標準差。下面即時算出六種散度。按「找最佳的 \(q\)」會在 \((\mu,\sigma)\) 的網格上搜尋,看每種散度各自偏好哪個 \(q\),點表格可以把 \(q\) 設成那個解。
值得注意的幾件事(按完「找最佳的 \(q\)」再對照):
- forward KL 的最佳解是一個很寬的高斯,橫跨兩個峰:mode covering。它剛好就是 \(p\) 的平均 \(-0.60\) 與標準差 \(1.83\)(表格裡是網格上最接近的 1.84)。
- reverse KL 的最佳解縮在左邊那個比較重的峰上(\(\mu\approx-2\)、\(\sigma\approx0.5\)):mode seeking。
- Fisher divergence 的最佳解也是平均 \(-0.60\)、標準差 \(1.83\),和 forward KL 一樣。
- 勾選 \(D^*\) 時,讀數會多一行:把最佳判別器代進 GAN 的目標函數,數值上恰好等於 \(2\mathcal D_{\mathrm{JS}}-\log4\)(見第 6 節)。
為什麼在高斯家族裡,Fisher divergence 和 forward KL 選到同一個 \(q\)
這不是一般性的結論,是高斯家族的巧合。對高斯 \(q\),score 是線性的:\(\nabla\log q(x)=-(x-\mu)/\sigma^2=ax+b\),其中 \(a=-1/\sigma^2\)、\(b=\mu/\sigma^2\)。展開 Fisher divergence,丟掉和 \(q\) 無關的項,再用分部積分把 \(\nabla\log p\) 消掉(這就是第 3 章的 score matching),要最小化的是
$$\mathbb E_{x\sim p}\big[(ax+b)^2+2a\big].$$對 \(b\) 微分得 \(a\,\mathbb E[x]+b=0\);對 \(a\) 微分得 \(a\,\mathbb E[x^2]+b\,\mathbb E[x]+1=0\)。聯立解出 \(-1/a=\mathrm{Var}_p(x)\)、\(-b/a=\mathbb E_p[x]\),也就是 \(\sigma^2=\mathrm{Var}_p\)、\(\mu=\mathbb E_p\):和 forward KL 一樣是「動差匹配」。換成更複雜的模型家族,兩者的解一般就不同了。
05真正的難題:歸一化常數書 §1.1.2
如果要用神經網路直接表示 \(p_{\bm\phi}\),它必須是合法的機率密度,滿足兩個條件:
- 非負:對所有 \(\mathbf x\),\(p_{\bm\phi}(\mathbf x)\ge0\)。
- 歸一化:在整個定義域上積分等於 1,\(\int p_{\bm\phi}(\mathbf x)\,d\mathbf x=1\)。
神經網路自然的輸出是一個實數 \(E_{\bm\phi}(\mathbf x)\in\mathbb R\),不保證滿足這兩點。書的做法是把它當成「沒歸一化」的密度,分兩步補救。
第一步,保證非負:套一個正值函數,例如 \(\vert E_{\bm\phi}\vert\)、\(E_{\bm\phi}^2\),最常用也最方便的是指數:
$$\tilde p_{\bm\phi}(\mathbf x)=\exp\big(E_{\bm\phi}(\mathbf x)\big).$$第二步,強制歸一化:除以它在整個空間上的積分,
$$p_{\bm\phi}(\mathbf x)=\frac{\tilde p_{\bm\phi}(\mathbf x)}{\int\tilde p_{\bm\phi}(\mathbf x')\,d\mathbf x'}=\frac{\exp\big(E_{\bm\phi}(\mathbf x)\big)}{\int\exp\big(E_{\bm\phi}(\mathbf x')\big)\,d\mathbf x'},\qquad Z(\bm\phi):=\int\exp\big(E_{\bm\phi}(\mathbf x')\big)\,d\mathbf x'.$$分母 \(Z(\bm\phi)\) 叫歸一化常數(normalizing constant),或 partition function。構造是合法的,但代價很大:在高維度,這個積分幾乎永遠算不出來。這個困難正是許多生成模型家族誕生的動機,接下來介紹的每一種模型,都是設計來繞開或降低計算 \(Z\) 的成本。
記號提醒:這裡是 \(\exp(E)\),下一節的 EBM 是 \(\exp(-E)\)
書在本節用 \(\tilde p=\exp(E_{\bm\phi})\),但在第 6 節介紹 EBM 時用的是物理慣例 \(p\propto\exp(-E_{\bm\phi})\),也就是「能量越低越可能」。兩者只差一個負號,把 \(E\) 換成 \(-E\) 就互通;後面第 3 章談 EBM 時沿用 \(\exp(-E)\) 的慣例。
Demo B為什麼歸一化常數算不出來轉述者補充
兩種最直接的估計 \(Z=\int\tilde p(\mathbf x)\,d\mathbf x\) 的方法,在高維度都會失效。
方法一:格點積分。每個維度切 \(n\) 格,要在 \(n^D\) 個點上算 \(\tilde p\)。方法二:抽樣估計(importance sampling)。從一個好抽的分佈 \(r\)(這裡用標準高斯)抽 \(M\) 個點,用 \(\tfrac1M\sum\tilde p(\mathbf x_j)/r(\mathbf x_j)\) 估計。這裡的目標是 \(\tilde p(\mathbf x)=\exp(-\Vert\mathbf x\Vert^2/0.5)\),真正的 \(Z=(0.5\pi)^{D/2}\) 已知,可以直接比對。
維度一高,抽樣估計的權重就被極少數樣本壟斷,有效樣本數掉到個位數,估計值可以差上好幾個數量級。真實的資料(例如一張 \(64\times64\) 的彩色圖片有 12,288 維)比這個例子難得多。
06主要的生成模型書 §1.2
生成模型的核心挑戰,是學到能捕捉高維資料豐富結構的機率模型。不同的策略在「好不好算」「表達力」「訓練效率」之間做不同的取捨。下面依書的順序逐一介紹,並先看一張把它們的計算圖並排的總覽。
Energy-Based Models(EBM)
EBM 用一個能量函數 \(E_{\bm\phi}(\mathbf x)\) 定義分佈,能量越低的點越可能:
$$p_{\bm\phi}(\mathbf x):=\frac1{Z(\bm\phi)}\exp\big(-E_{\bm\phi}(\mathbf x)\big),\qquad Z(\bm\phi)=\int\exp\big(-E_{\bm\phi}(\mathbf x)\big)\,d\mathbf x.$$訓練通常是最大化 log-likelihood,但這要處理算不出來的 \(Z(\bm\phi)\)。書預告:diffusion model 提供了另一條路,用 log 密度的梯度來生成資料,而梯度和歸一化常數無關(第 3 節的 Fisher divergence 就是這個性質),所以完全不必計算 partition function。
Autoregressive models(AR)
AR 模型建立在一個簡單但強大的觀察上:任何聯合分佈都可以用機率的連鎖律拆成一串條件分佈。對變數選一個順序 \(\mathbf x=(x_1,\dots,x_D)\):
$$p_{\text{data}}(\mathbf x)=\prod_{i=1}^D p_{\text{data}}(x_i\mid\mathbf x_{\lt i}),\qquad \mathbf x_{\lt i}=(x_1,\dots,x_{i-1}).$$這是恆等式,不是模型假設:任何分佈、任何順序都成立。困難在於真正的條件分佈不知道,所以 AR 模型用同樣形式的參數化,
$$p_{\bm\phi}(\mathbf x)=\prod_{i=1}^D p_{\bm\phi}(x_i\mid\mathbf x_{\lt i}),$$再用神經網路(例如 Transformer)去近似每個條件分佈:離散資料可以用 softmax 輸出類別分佈,連續資料可以輸出某個好處理的條件密度的參數。每個條件分佈都已歸一化,所以乘起來的聯合分佈自動歸一化,\(Z\) 的問題就這樣被繞開了。
訓練因此很簡單。log-likelihood 拆成一項項的和:
$$\log p_{\bm\phi}(\mathbf x)=\sum_{i=1}^D\log p_{\bm\phi}(x_i\mid\mathbf x_{\lt i}),$$可以直接用 MLE 訓練。訓練時前面的 \(\mathbf x_{\lt i}\) 都是已知的真實資料,所以很多條件預測可以平行算。但生成本質上是循序的:
$$x_1\sim p_{\bm\phi}(x_1),\quad x_2\sim p_{\bm\phi}(x_2\mid x_1),\quad\dots,\quad x_D\sim p_{\bm\phi}(x_D\mid\mathbf x_{\lt D}).$$所以 AR 模型有精確的 likelihood 和彈性的密度建模,但序列一長,取樣就很貴。它仍然是 likelihood-based 模型的基礎,也是許多現代序列模型和語言模型的骨幹。
Variational Autoencoders(VAE)
VAE 在傳統 autoencoder 上加了潛在變數 \(\mathbf z\),用來捕捉資料 \(\mathbf x\) 背後的隱藏結構,而且採取機率的觀點:學一個 encoder \(q_{\bm\theta}(\mathbf z\mid\mathbf x)\),近似「給定資料時潛在變數的分佈」;再學一個 decoder \(p_{\bm\phi}(\mathbf x\mid\mathbf z)\),從潛在變數重建資料。真正的 log-likelihood 算不出來,所以改最大化一個好算的下界,evidence lower bound(ELBO):
$$\mathcal L_{\text{ELBO}}(\bm\theta,\bm\phi;\mathbf x)=\mathbb E_{q_{\bm\theta}(\mathbf z\mid\mathbf x)}\big[\log p_{\bm\phi}(\mathbf x\mid\mathbf z)\big]-\mathcal D_{\mathrm{KL}}\big(q_{\bm\theta}(\mathbf z\mid\mathbf x)\,\Vert\,p_{\text{prior}}(\mathbf z)\big).$$第一項鼓勵準確重建資料,第二項讓潛在變數的分佈貼近一個簡單的先驗 \(p_{\text{prior}}(\mathbf z)\)(通常是高斯)。VAE 是把神經網路和潛在變數模型結合的一套有原則的做法,至今仍是最廣泛使用的 likelihood-based 方法之一,但也有實務問題:樣本不夠銳利、訓練病態(例如 decoder 乾脆忽略潛在變數)。它為後來的 diffusion model 打下了重要的基礎(第 2 章)。
Normalizing Flows(NF)
經典的 flow 模型包括 normalizing flow,以及它的連續時間版本 Neural ODE(NODE)。它們學一個在簡單潛在分佈 \(\mathbf z\) 和複雜資料分佈 \(\mathbf x\) 之間的可逆映射 \(\mathbf f_{\bm\phi}\):NF 用一串可逆轉換疊起來,NODE 則把轉換寫成一條常微分方程。它們靠密度的變數變換公式做 MLE 訓練:
$$\log p_{\bm\phi}(\mathbf x)=\log p(\mathbf z)+\log\left\vert\det\frac{\partial\mathbf f_{\bm\phi}^{-1}(\mathbf x)}{\partial\mathbf x}\right\vert,$$其中 \(\mathbf f_{\bm\phi}\) 把 \(\mathbf z\) 映到 \(\mathbf x\)(所以 \(\mathbf z=\mathbf f_{\bm\phi}^{-1}(\mathbf x)\))。NF 直接建模已歸一化的密度:歸一化常數透過變數變換公式被解析地吸收掉了,likelihood 可以精確計算。缺點是:NF 為了保證可逆,對架構限制很多;NODE 每次都要解 ODE,訓練成本高;兩者都不容易擴展到高維資料。之後(第 5 章)會看到 diffusion model 怎麼和這些經典 flow 方法連在一起。
變數變換公式的一維直覺
一維時,\(x=f(z)\) 把一小段 \([z,z+dz]\) 映到 \([x,x+dx]\)。機率質量守恆:\(p_X(x)\vert dx\vert=p_Z(z)\vert dz\vert\),所以 \(p_X(x)=p_Z(z)\vert dz/dx\vert=p_Z(f^{-1}(x))\,\vert(f^{-1})'(x)\vert\)。取 log 就是上式的一維版;高維時「長度的伸縮比」換成 Jacobian 行列式的絕對值。詳細推導在附錄 B(B34),也可以看 CS236 補充課 C。
Generative Adversarial Networks(GAN)
GAN 由兩個互相競爭的網路組成:生成器 \(\mathrm G_{\bm\phi}\) 把隨機雜訊 \(\mathbf z\sim p_{\text{prior}}\) 變成看起來真實的樣本 \(\mathrm G_{\bm\phi}(\mathbf z)\);判別器 \(D_{\bm\zeta}\) 試著分辨真樣本 \(\mathbf x\) 和假樣本。目標函數是
$$\min_{\mathrm G_{\bm\phi}}\max_{D_{\bm\zeta}}\ \underbrace{\mathbb E_{\mathbf x\sim p_{\text{data}}}\big[\log D_{\bm\zeta}(\mathbf x)\big]}_{\text{真}}+\underbrace{\mathbb E_{\mathbf z\sim p_{\text{prior}}}\big[\log\big(1-D_{\bm\zeta}(\mathrm G_{\bm\phi}(\mathbf z))\big)\big]}_{\text{假}}.$$GAN 不定義顯式的密度函數,所以完全繞過 likelihood 估計:不算歸一化常數,只專注於生成像資料的樣本。
從散度的角度看,判別器其實在隱含地量測 \(p_{\text{data}}\) 和生成分佈 \(p_{\mathrm G_{\bm\phi}}\)(\(\mathrm G_{\bm\phi}(\mathbf z)\) 的分佈)的差距。對固定的生成器,最佳判別器是
$$D^*(\mathbf x)=\frac{p_{\text{data}}(\mathbf x)}{p_{\text{data}}(\mathbf x)+p_{\mathrm G_{\bm\phi}}(\mathbf x)},$$代回去之後,生成器要最小化的變成
$$\min_{\mathrm G_{\bm\phi}}\ 2\,\mathcal D_{\mathrm{JS}}\big(p_{\text{data}}\Vert p_{\mathrm G_{\bm\phi}}\big)-\log4,$$也就是 GAN 隱含地在最小化 JS divergence。更廣地說,\(f\)-GAN 證明了對抗訓練可以最小化整個 \(f\)-divergence 家族,把 GAN 放進和其他生成模型同一個「最小化散度」的框架裡。
最佳判別器與 \(2\mathcal D_{\mathrm{JS}}-\log4\) 怎麼來
把兩個期望都寫成對 \(\mathbf x\) 的積分(第二項把 \(\mathbf z\) 換成 \(\mathbf x=\mathrm G(\mathbf z)\),分佈是 \(p_g:=p_{\mathrm G_{\bm\phi}}\)):
$$V(D)=\int\Big[p_{\text{data}}(\mathbf x)\log D(\mathbf x)+p_g(\mathbf x)\log\big(1-D(\mathbf x)\big)\Big]d\mathbf x.$$對每一個 \(\mathbf x\) 各自最大化 \(a\log y+b\log(1-y)\)(\(a=p_{\text{data}}\)、\(b=p_g\)):對 \(y\) 微分得 \(a/y-b/(1-y)=0\),解出 \(y=a/(a+b)\),就是 \(D^*\)。代回去,令 \(m=\tfrac12(p_{\text{data}}+p_g)\):
$$V(D^*)=\int p_{\text{data}}\log\frac{p_{\text{data}}}{2m}+\int p_g\log\frac{p_g}{2m}=\mathcal D_{\mathrm{KL}}(p_{\text{data}}\Vert m)+\mathcal D_{\mathrm{KL}}(p_g\Vert m)-2\log2=2\mathcal D_{\mathrm{JS}}(p_{\text{data}}\Vert p_g)-\log4.$$Demo A 勾選 \(D^*\) 後,讀數會用數值積分驗證這個等式。
雖然 GAN 能生出高品質的資料,但它的 min-max 訓練出了名的不穩定,常常需要精心設計的架構和工程技巧。不過後來 GAN 又以「輔助元件」的身分復活,被用來增強其他生成模型,特別是 diffusion model。
07分類:顯式模型與隱式模型書 §1.3
這麼多策略,有一個根本的分界:模型怎麼參數化分佈,是把 \(p_{\bm\phi}(\mathbf x)\) 顯式寫出來,還是只隱式地定義它(和訓練目標無關)。
- 顯式模型(explicit):直接參數化一個好算或近似好算的密度(或機率質量)函數。AR、NF、VAE、DM 都是,它們要嘛精確地、要嘛透過一個好算的下界定義 \(p_{\bm\phi}(\mathbf x)\)。
- 隱式模型(implicit):只透過抽樣程序定義分佈,通常是 \(\mathbf x=\mathrm G_{\bm\phi}(\mathbf z)\),\(\mathbf z\sim p_{\text{prior}}\)。這時 \(p_{\bm\phi}(\mathbf x)\) 沒有封閉形式,甚至可能根本沒有定義。
| 顯式:精確 likelihood | 顯式:近似 likelihood | 隱式 | |
|---|---|---|---|
| Likelihood | 好算 | 下界/近似 | 沒有直接建模/算不出來 |
| 訓練目標 | MLE | ELBO | 對抗式 |
| 例子 | NF、AR | VAE、DM | GAN |
依書中的表(§1.3)重排。
和 diffusion model 的關係
這些經典家族各自用互補的策略處理複雜分佈,也是理解 diffusion model 的指引。Diffusion 從其中幾個繼承了想法:
- 和 VAE 的關係在變分的訓練目標(第 2 章);
- 和 EBM 的關係在 score matching,也就是學 log 密度的梯度,而它和能量函數緊密相關(第 3 章);
- 和 NF 的關係在連續時間的轉換(第 5 章)。
所以書接下來聚焦在 VAE、EBM、NF 三個典範,作為 diffusion 的根。
08本章小結書 §1.4
- 目標:學一個好處理的模型分佈 \(p_{\bm\phi}\),近似未知而複雜的 \(p_{\text{data}}\)。核心困難是讓它成為合法密度所需的歸一化常數 \(Z(\bm\phi)\) 算不出來。
- 各家對策:EBM、AR、VAE、NF、GAN 各用一種策略繞過這個問題。依參數化方式可分成顯式(定義好算的密度)和隱式(只定義抽樣程序)兩類。
- 三條根:在這些經典框架裡,VAE、EBM、NF 是 diffusion 的概念源頭,接下來 Part B 依序追溯:
- 變分觀點(第 2 章):從(階層式)VAE 自然走到 DDPM。
- Score 觀點(第 3、4 章):從 EBM 和 score matching 出發,發展成 NCSN,再推廣到 Score SDE 框架。
- Flow 觀點(第 5 章):以 NF 的原則把生成看成連續的轉換,推廣成 flow matching。
理解了這些源頭,才能為 diffusion 五花八門的寫法建立一個一致的框架,看出把它們統一起來的深層原理。