從 energy-based model 到 score:只要知道往哪裡機率比較高,就能生成
第 2 章從 VAE 的變分觀點走到 DDPM。第 3 章換一個同樣根本的起點:energy-based model(EBM)。EBM 用一片「能量地形」描述分佈,但正規化常數算不出來。關鍵的觀察是:取樣只需要 log 密度的梯度,也就是 score,而 score 和正規化常數無關。這一頁講 EBM、score 的定義與好處、用 score matching 避開正規化常數、用 Langevin dynamics 取樣,最後跨出一步:乾脆用神經網路直接學 score。
讀完這頁你應該能夠
- 寫出 EBM 的定義,說明 partition function 為什麼讓最大概似訓練變難。
- 寫出 score function 的定義,說明它為什麼和正規化常數無關,以及為什麼它完整描述了分佈。
- 寫出 score matching 的目標,並用分部積分推出 Hyvärinen 的 tractable 形式;說出它的缺點(需要 Jacobian 的 trace)。
- 寫出離散與連續時間的 Langevin dynamics,說明為什麼要加雜訊、係數為什麼是 \(\sqrt2\),以及 mixing 慢的問題。
- 說明 score-based 生成模型的想法:直接用神經網路 \(\mathbf s_{\bm\phi}\) 學 score,再用 Langevin 取樣。
前置知識
- B01:最大概似估計(MLE)、EBM 在全書地圖裡的位置。
- 梯度、Jacobian、Hessian、trace、散度(divergence);多變數的分部積分。可以參考 CS236 補充課 A。
- MCMC 與 stationary distribution 的概念:補充課 D;布朗運動與 SDE、Euler–Maruyama:補充課 E;Fokker–Planck 與 Langevin:補充課 F。
「書 §」標出原文位置。灰框「轉述者補充」是書裡沒有的內容;藍框「推導」展開書中省略的步驟或附錄 D 的證明。本頁的 \(\bm\phi\) 是模型參數;\(\mathbf x_0\) 在第 3 節指「參考點」,不是 B04 的乾淨資料。
01第 3 章在做什麼書 第 3 章開頭
前兩章把 diffusion model 追溯到變分的源頭,看到它怎麼從 VAE 的框架裡長出來。這一章轉向第二個、同樣根本的觀點:Energy-Based Models(EBM;Ackley et al. 1985、LeCun et al. 2006)。EBM 用一片能量地形表示分佈:資料所在的地方能量低,其他地方能量高。從 EBM 取樣通常靠 Langevin dynamics,沿著這片地形的梯度把樣本推向高密度區域。這個梯度場叫做 score,它指向機率變高的方向。
核心觀察是:知道 score 就足以生成。它能把樣本推向可能的區域,卻不必計算算不出來的正規化常數。Score-based diffusion model 直接建立在這個想法上:不只看乾淨的資料分佈,而是考慮一串被高斯雜訊擾動過的分佈,它們的 score 比較容易近似。學會這些 score,就得到一族向量場,能一步步把帶雜訊的樣本帶回資料,把生成變成逐步去雜訊。
書列出本章的學習目標有三項:
- 理解 score-based 建模的核心想法:score function 是什麼,以及怎麼搭配 Langevin dynamics 生成。(本頁)
- 理解 denoising score matching 怎麼透過 conditioning trick 學單一雜訊等級的 score,以及 Tweedie 公式怎麼把 score 預測和去雜訊連起來。(B06)
- 理解 Noise Conditional Score Networks(NCSN)怎麼把 denoising score matching 推廣到多個雜訊等級、為什麼多個雜訊等級有用,以及 NCSN 的 score 預測和 DDPM 的雜訊預測有什麼關係。(B07)
書建議:已經熟悉 EBM 的讀者可以略讀 §3.1(本頁第 2–5 節),直接從 §3.2.1(本頁第 6 節)開始。
02Energy-based model書 §3.1.1
書說這一節是給熟悉 EBM 的讀者的簡短複習,也是通往 diffusion 的 score 觀點的橋。
用能量函數描述機率分佈
令 \(\mathbf x\in\mathbb R^D\) 是一筆資料。EBM 透過一個以 \(\bm\phi\) 為參數的能量函數 \(E_{\bm\phi}(\mathbf x)\) 定義機率密度,越可能出現的組態能量越低:
$$p_{\bm\phi}(\mathbf x):=\frac{\exp(-E_{\bm\phi}(\mathbf x))}{Z_{\bm\phi}},\qquad Z_{\bm\phi}:=\int_{\mathbb R^D}\exp(-E_{\bm\phi}(\mathbf x))\,d\mathbf x.$$\(Z_{\bm\phi}\) 叫做 partition function,它保證正規化:\(\int p_{\bm\phi}(\mathbf x)\,d\mathbf x=1\)。
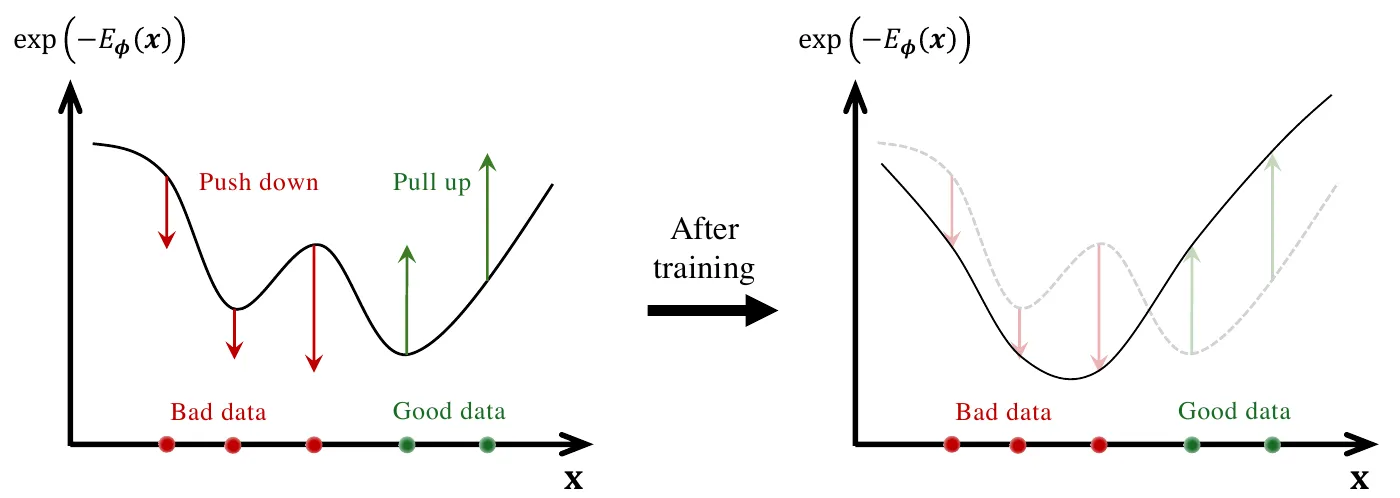
在這個觀點下,能量越低的點機率越高,就像球滾進山谷。因為 \(Z_{\bm\phi}\) 讓所有機率加起來等於 1,只有能量的相對值有意義:例如所有能量都加上同一個常數,分子分母乘上同一個因子,分佈完全不變。
而且,也正因為 \(Z_{\bm\phi}\) 強制機率總和為 1,數學上必然是:降低某個區域的能量會提高它的機率,同時其餘區域的機率跟著下降。所以 EBM 遵守嚴格的全域取捨:把一個山谷挖深,其他山谷必然變淺;機率質量是在整個空間重新分配,而不是各區域各自獨立指定。
最大概似訓練的困難
原則上 EBM 可以用最大概似訓練(B01 的 MLE),它自然地在「擬合資料」和「全域正規化」之間取得平衡:
$$\mathcal L_{\text{MLE}}(\bm\phi)=\mathbb E_{p_{\text{data}}(\mathbf x)}\!\left[\log\frac{\exp(-E_{\bm\phi}(\mathbf x))}{Z_{\bm\phi}}\right]=-\underbrace{\mathbb E_{p_{\text{data}}}[E_{\bm\phi}(\mathbf x)]}_{\text{降低資料的能量}}-\underbrace{\log\int\exp(-E_{\bm\phi}(\mathbf x))\,d\mathbf x}_{\text{全域正規化}}.$$第一項降低真實資料的能量,第二項透過 partition function 強制正規化。但在高維度,\(\log Z_{\bm\phi}\) 和它的梯度都算不出來,因為那需要對模型分佈取期望。這促成了兩類替代做法:近似這一項,例如 contrastive divergence(Hinton 2002);或者透過 score matching 完全避開它。
「需要對模型分佈取期望」是什麼意思
對 \(\bm\phi\) 微分第二項:
$$\nabla_{\bm\phi}\log Z_{\bm\phi}=\frac{1}{Z_{\bm\phi}}\int\exp(-E_{\bm\phi}(\mathbf x))\big(-\nabla_{\bm\phi}E_{\bm\phi}(\mathbf x)\big)d\mathbf x=-\mathbb E_{p_{\bm\phi}(\mathbf x)}\big[\nabla_{\bm\phi}E_{\bm\phi}(\mathbf x)\big].$$所以 MLE 的梯度是「資料上的能量梯度」減去「模型樣本上的能量梯度」:在資料處壓低能量、在模型自己生成的樣本處抬高能量,正是上圖的 push down/pull up。問題在於第二個期望需要從 \(p_{\bm\phi}\) 取樣,而從 EBM 取樣本身就要跑 MCMC(例如第 5 節的 Langevin),每一步訓練都要跑一次,代價很高。Contrastive divergence 就是只跑幾步 MCMC 來近似這個期望。CS236 第 11 講有完整的推導。
接下來先介紹 score function 的概念(第 3 節),再介紹繞過 partition function 的 score matching(第 4 節),最後介紹用 score 取樣的實用方法 Langevin dynamics(第 5 節)。
03什麼是 score書 §3.1.2
對 \(\mathbb R^D\) 上的密度 \(p(\mathbf x)\),score function 是 log 密度的梯度:
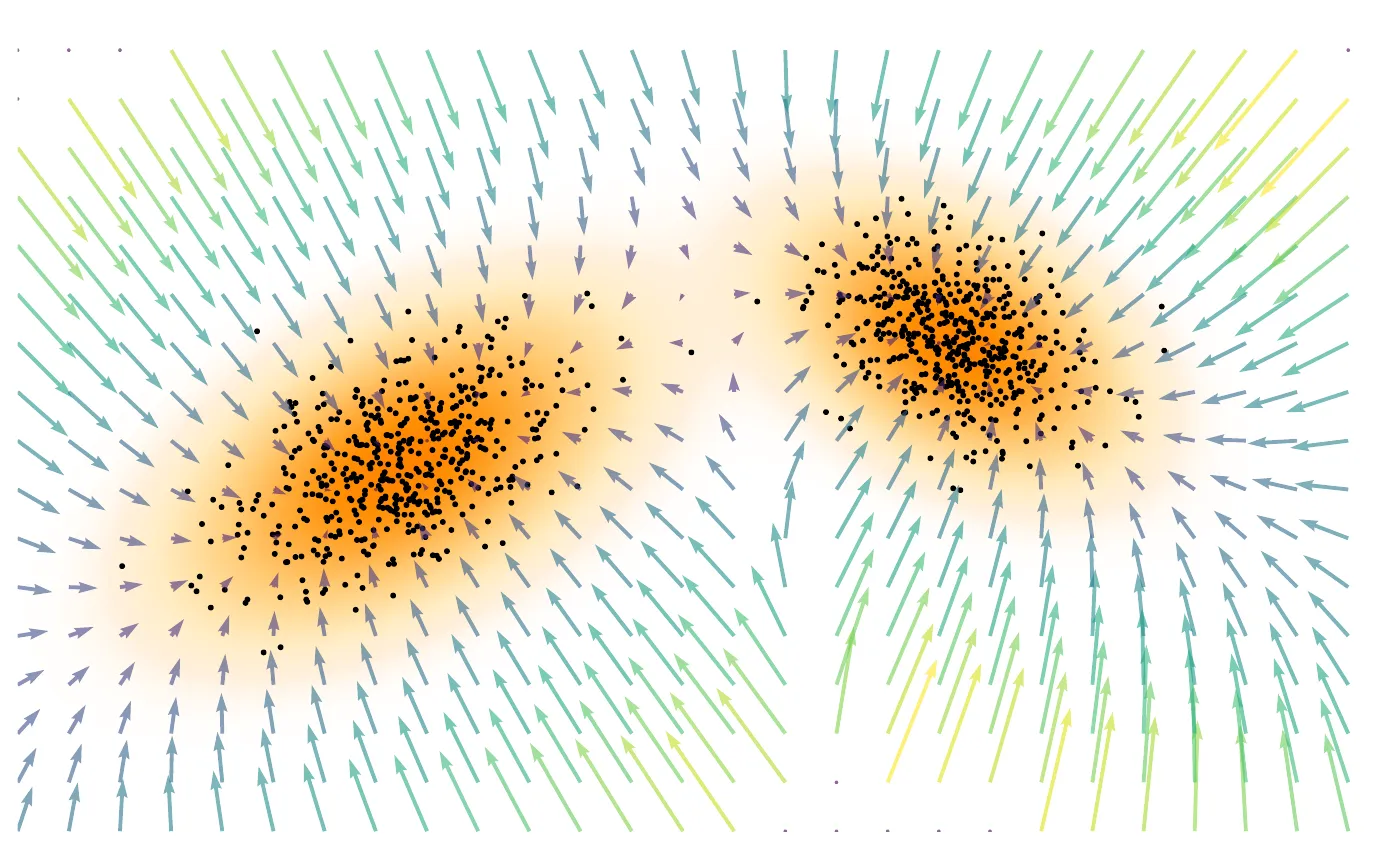
$$\mathbf s(\mathbf x):=\nabla_{\mathbf x}\log p(\mathbf x),\qquad\mathbf s:\mathbb R^D\to\mathbb R^D.$$直覺上,score 是一個向量場,每一點都指向機率比較高的方向,是「資料最可能在哪裡」的局部嚮導。
一維的例子:高斯的 score
\(p(x)=\mathcal N(x;\mu,\sigma^2)\):\(\log p(x)=-\frac{(x-\mu)^2}{2\sigma^2}+\text{常數}\),所以 \(s(x)=-\frac{x-\mu}{\sigma^2}\)。在 \(\mu\) 右邊 score 是負的(往左指),在左邊是正的(往右指),離中心越遠越大,\(\sigma\) 越小越陡。例如 \(\mu=0,\sigma=0.5\),在 \(x=1\) 的 score 是 \(-4\)。多維時 \(\mathbf s(\mathbf x)=-\bm\Sigma^{-1}(\mathbf x-\bm\mu)\)。
混合分佈的 score 是各成分 score 的加權平均,權重是「這一點屬於各成分的後驗機率」:\(\nabla\log\sum_kw_kp_k=\sum_k\frac{w_kp_k}{\sum_jw_jp_j}\nabla\log p_k\)。所以上圖兩團之間的分水嶺,就是兩個成分的後驗機率各半的地方。
為什麼建模 score 而不是密度
建模 score 有理論上和實務上的好處:
1. 不受正規化常數束縛。很多分佈只知道未正規化的密度 \(\tilde p(\mathbf x)\),例如 EBM 的 \(\exp(-E_{\bm\phi}(\mathbf x))\):
$$p(\mathbf x)=\frac{\tilde p(\mathbf x)}{Z},\qquad Z=\int\tilde p(\mathbf x)\,d\mathbf x.$$\(Z\) 算不出來,但 score 只依賴 \(\tilde p\):
$$\nabla_{\mathbf x}\log p(\mathbf x)=\nabla_{\mathbf x}\log\tilde p(\mathbf x)-\underbrace{\nabla_{\mathbf x}\log Z}_{=0}=\nabla_{\mathbf x}\log\tilde p(\mathbf x),$$因為 \(Z\) 對 \(\mathbf x\) 是常數。這完全繞過了 partition function。
2. 完整的表示。score 完整刻畫了背後的分佈。因為它是 log 密度的梯度,可以(差一個常數)把密度還原回來:
$$\log p(\mathbf x)=\log p(\mathbf x_0)+\int_0^1\mathbf s\big(\mathbf x_0+t(\mathbf x-\mathbf x_0)\big)^{\!\top}(\mathbf x-\mathbf x_0)\,dt,$$其中 \(\mathbf x_0\) 是一個參考點,\(\log p(\mathbf x_0)\) 由正規化決定。所以建模 score 和建模 \(p(\mathbf x)\) 本身一樣有表達力,而在生成建模上往往更好處理。
還原式的推導
沿著從 \(\mathbf x_0\) 到 \(\mathbf x\) 的直線 \(\bm\gamma(t)=\mathbf x_0+t(\mathbf x-\mathbf x_0)\) 看 \(g(t):=\log p(\bm\gamma(t))\)。連鎖律:\(g'(t)=\nabla\log p(\bm\gamma(t))^\top\bm\gamma'(t)=\mathbf s(\bm\gamma(t))^\top(\mathbf x-\mathbf x_0)\)。微積分基本定理 \(g(1)=g(0)+\int_0^1g'(t)\,dt\),就是上式。
「差一個常數」:只知道 score 時,\(\log p(\mathbf x_0)\) 不知道;但 \(p\) 必須積分為 1,這個條件恰好決定了它。
04用 score matching 訓練 EBM書 §3.1.3
EBM 的密度是 \(p_{\bm\phi}(\mathbf x)=\exp(-E_{\bm\phi}(\mathbf x))/Z_{\bm\phi}\),最大概似訓練需要算 \(Z_{\bm\phi}\),一般做不到。關鍵的觀察是:由上一節的式子,模型的 score 化簡成
$$\nabla_{\mathbf x}\log p_{\bm\phi}(\mathbf x)=-\nabla_{\mathbf x}E_{\bm\phi}(\mathbf x),$$和 \(Z_{\bm\phi}\) 無關。Score matching(Hyvärinen 2005)利用「score 只依賴能量函數」這一點:不去擬合正規化的機率,而是讓模型的 score 對齊(未知的)資料 score:
$$\mathcal L_{\text{SM}}(\bm\phi)=\tfrac12\,\mathbb E_{p_{\text{data}}(\mathbf x)}\big\Vert\nabla_{\mathbf x}\log p_{\bm\phi}(\mathbf x)-\nabla_{\mathbf x}\log p_{\text{data}}(\mathbf x)\big\Vert_2^2.$$資料的 score 拿不到,但分部積分給出一個只含能量和它的導數的等價式子(細節在第 6 節的命題):
$$\mathcal L_{\text{SM}}(\bm\phi)=\mathbb E_{p_{\text{data}}(\mathbf x)}\Big[-\operatorname{Tr}\big(\nabla_{\mathbf x}^2E_{\bm\phi}(\mathbf x)\big)+\tfrac12\Vert\nabla_{\mathbf x}E_{\bm\phi}(\mathbf x)\Vert_2^2\Big]+C,$$其中 \(\nabla_{\mathbf x}^2E_{\bm\phi}(\mathbf x)\) 是 \(E_{\bm\phi}\) 的 Hessian,\(C\) 是和 \(\bm\phi\) 無關的常數。
從第 6 節的命題得到這個式子
第 6 節的命題說,對任意向量場 \(\mathbf s_{\bm\phi}\),\(\mathcal L_{\text{SM}}=\mathbb E\big[\operatorname{Tr}(\nabla_{\mathbf x}\mathbf s_{\bm\phi})+\tfrac12\Vert\mathbf s_{\bm\phi}\Vert^2\big]+C\)。代入 \(\mathbf s_{\bm\phi}=-\nabla_{\mathbf x}E_{\bm\phi}\):Jacobian \(\nabla_{\mathbf x}\mathbf s_{\bm\phi}=-\nabla_{\mathbf x}^2E_{\bm\phi}\),所以 trace 變成 \(-\operatorname{Tr}(\nabla_{\mathbf x}^2E_{\bm\phi})\);\(\Vert\mathbf s_{\bm\phi}\Vert^2=\Vert\nabla_{\mathbf x}E_{\bm\phi}\Vert^2\)。
這個寫法很吸引人:它消掉了 partition function,訓練時也不必從模型取樣。主要缺點是需要二階導數:雖然只要 Hessian 的 trace \(\operatorname{Tr}(\nabla_{\mathbf x}^2E_{\bm\phi})\),不需要整個 Hessian 矩陣,但精確計算這一項一般要把每個輸入座標的二階導數資訊加起來,所以代價通常隨輸入維度 \(D\) 增加。書說本章稍後會回來處理這個限制(B06 的 sliced 與 denoising score matching)。
為什麼 trace 的代價隨 \(D\) 增加
\(\operatorname{Tr}(\nabla^2E)=\sum_{i=1}^D\partial^2E/\partial x_i^2\)。自動微分一次反向傳播能拿到整個梯度 \(\nabla E\)(\(D\) 個數),但對角線的每一個 \(\partial^2E/\partial x_i^2\) 都要對梯度的第 \(i\) 個分量再做一次反向傳播,總共 \(D\) 次。影像的 \(D\) 動輒數萬到數十萬,這就太貴了。
05用 score 做 Langevin 取樣書 §3.1.4
由能量函數 \(E_{\bm\phi}(\mathbf x)\) 定義的 EBM,可以用 Langevin dynamics 取樣。下面先給離散時間的 Langevin 更新,再給它的連續時間極限(一條隨機微分方程,SDE),最後討論 Langevin dynamics 為什麼能有效探索複雜能量地形的物理直覺。
離散時間的 Langevin dynamics
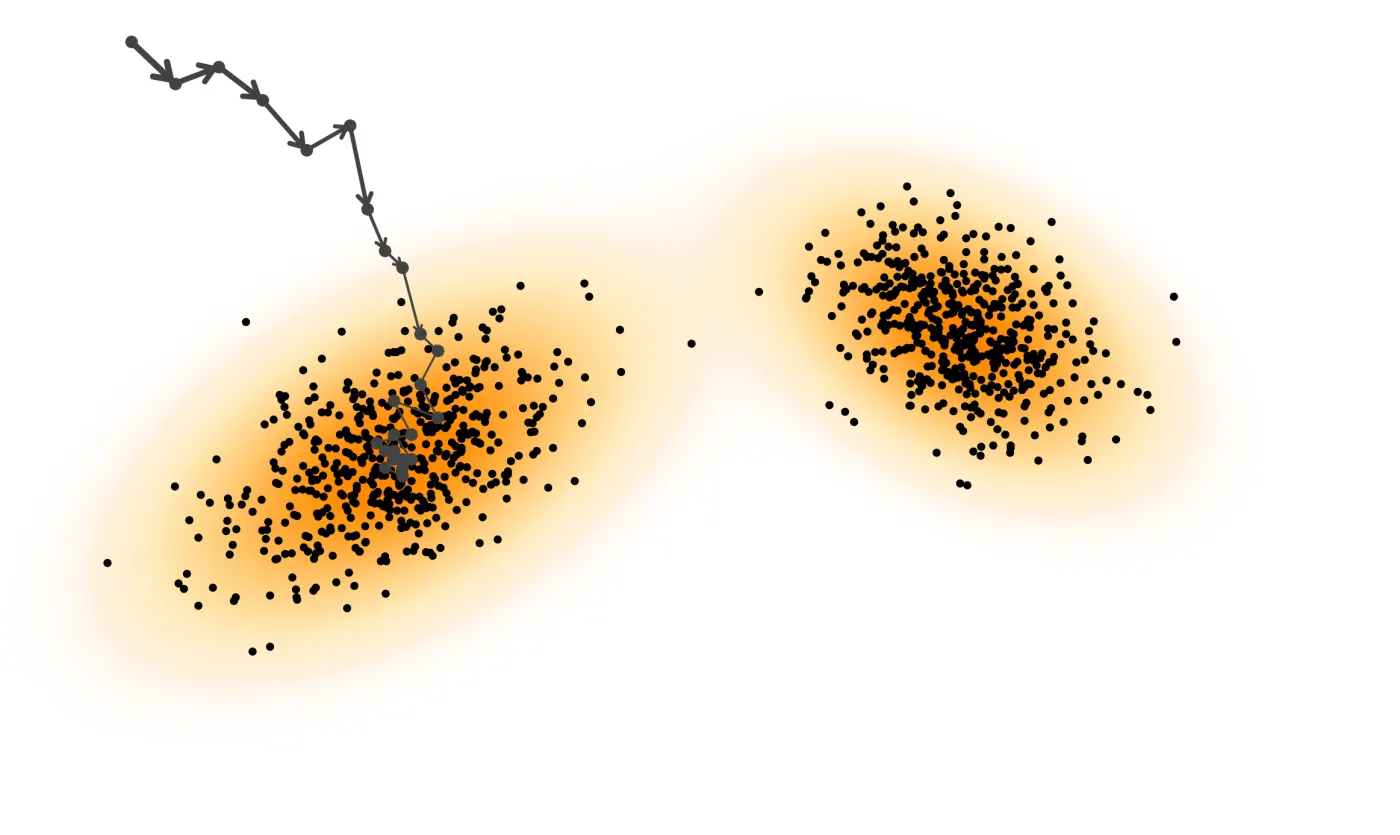
$$\mathbf x_{n+1}=\mathbf x_n-\eta\nabla_{\mathbf x}E_{\bm\phi}(\mathbf x_n)+\sqrt{2\eta}\,\boldsymbol\epsilon_n,\qquad n=0,1,2,\dots$$\(\mathbf x_0\) 從某個分佈初始化(常用高斯),\(\eta>0\) 是步長,\(\boldsymbol\epsilon_n\sim\mathcal N(\mathbf 0,\mathbf I)\) 是高斯雜訊。雜訊加入隨機性,讓取樣能跳出局部極小。因為 score 就是 \(\nabla_{\mathbf x}\log p_{\bm\phi}(\mathbf x)=-\nabla_{\mathbf x}E_{\bm\phi}(\mathbf x)\),更新可以等價地寫成
$$\mathbf x_{n+1}=\mathbf x_n+\eta\nabla_{\mathbf x}\log p_{\bm\phi}(\mathbf x_n)+\sqrt{2\eta}\,\boldsymbol\epsilon_n,$$score 把樣本導向高密度區域。書說這個寫法是 diffusion model 的核心,後面會詳談。
連續時間的 Langevin dynamics
當步長 \(\eta\to0\),離散的 Langevin 更新自然收斂到一個連續時間的過程,由 Langevin SDE 描述:
$$d\mathbf x(t)=\nabla_{\mathbf x}\log p_{\bm\phi}(\mathbf x(t))\,dt+\sqrt2\,d\mathbf w(t),$$\(\mathbf w(t)\) 是標準布朗運動(也叫 Wiener process)。重要的是:離散的更新式正是這條連續 SDE 的 Euler–Maruyama 離散化。
書的註腳一:布朗運動的增量滿足 \(\mathbf w(t+\eta)-\mathbf w(t)\sim\mathcal N(\mathbf 0,\eta\mathbf I)\),所以 Euler–Maruyama 每一步的雜訊是 \(\sqrt2\,[\mathbf w(t+\eta)-\mathbf w(t)]=\sqrt{2\eta}\,\boldsymbol\epsilon_n\)。這就是 \(\sqrt\eta\) 這個根號尺度的來源。布朗運動與 SDE 的詳細介紹在書的附錄 A(B33)。
在標準的正則性假設下(例如 \(p_{\bm\phi}\propto e^{-E_{\bm\phi}}\),且 \(E_{\bm\phi}\) 是「把粒子關住」(confining)、夠平滑的函數),\(\mathbf x(t)\) 的分佈會在 \(t\to\infty\) 時(指數快速地)收斂到 \(p_{\bm\phi}\);所以可以靠模擬(求解)這條 SDE 來取樣。(轉述者註:書的原句寫到「thus」就中斷了,分號後的半句是轉述者依上下文補上的。)
書的註腳二:有了係數 \(\sqrt2\),Langevin dynamics 讓 \(p_{\bm\phi}\) 在時間中保持不變,也就是 \(p_{\bm\phi}\) 是 stationary 的:若 \(\mathbf x(0)\sim p_{\bm\phi}\),則對所有 \(t\ge0\),\(\mathbf x(t)\sim p_{\bm\phi}\)。等價地,\(p_{\bm\phi}\) 是 Fokker–Planck 方程 \(\partial_t\rho=-\nabla\cdot(\rho\nabla\log p_{\bm\phi})+\tfrac{\sigma^2}2\Delta\rho\) 的穩態解(\(\sigma\) 是雜訊係數)。代入 \(\rho=p_{\bm\phi}\) 得到 \((\tfrac{\sigma^2}2-1)\Delta p_{\bm\phi}=0\),只有 \(\sigma=\sqrt2\) 時成立。
註腳二的那一步
代入 \(\rho=p_{\bm\phi}\)。漂移項:\(p_{\bm\phi}\nabla\log p_{\bm\phi}=\nabla p_{\bm\phi}\),所以 \(-\nabla\cdot(p_{\bm\phi}\nabla\log p_{\bm\phi})=-\nabla\cdot\nabla p_{\bm\phi}=-\Delta p_{\bm\phi}\)。加上擴散項 \(\tfrac{\sigma^2}2\Delta p_{\bm\phi}\),右邊是 \((\tfrac{\sigma^2}2-1)\Delta p_{\bm\phi}\)。穩態要求左邊 \(\partial_tp_{\bm\phi}=0\),所以右邊必須為 0;一般的 \(p_{\bm\phi}\) 的 \(\Delta p_{\bm\phi}\) 不恆為 0,因此 \(\sigma^2=2\)。
直覺:漂移把機率質量往高密度處推、擴散把它攤開,係數 \(\sqrt2\) 恰好讓兩股力量在 \(p_{\bm\phi}\) 處平衡。Fokker–Planck 方程見補充課 F 或書的附錄 B(B34)。
為什麼用 Langevin 取樣
一個自然的理解方式來自物理:能量函數 \(E_{\bm\phi}(\mathbf x)\) 定義一片位能地形,決定粒子的行為。依牛頓力學,粒子在由這片能量導出的力場下的運動由常微分方程(ODE)描述:
$$d\mathbf x(t)=-\nabla_{\mathbf x}E_{\bm\phi}(\mathbf x(t))\,dt,$$它確定性地把粒子推下坡,走到某個能量的局部極小。但這種確定性的動態會卡在局部極小,沒辦法探索完整的資料分佈。
為了克服這點,Langevin dynamics 加入隨機擾動,得到 SDE
$$d\mathbf x(t)=-\nabla_{\mathbf x}E_{\bm\phi}(\mathbf x(t))\,dt+\underbrace{\sqrt2\,d\mathbf w(t)}_{\text{注入的雜訊}}.$$雜訊讓粒子能越過能量障礙、逃出局部極小,軌跡變成一個隨機過程,它的 stationary distribution 收斂到 Boltzmann 分佈 \(p_{\bm\phi}(\mathbf x)\propto e^{-E_{\bm\phi}(\mathbf x)}\)。
從這個角度看,EBM 可以理解成在學一個「把樣本推向高機率區域」的力場。Langevin 取樣對 EBM 特別有用,因為它提供了一個不必明確計算 partition function、就能從 \(p_{\bm\phi}(\mathbf x)\) 生成樣本的實用方法:反覆套用 Langevin 更新,得到的樣本就近似目標分佈。
Langevin 取樣天生的困難
Langevin dynamics 是一種廣泛使用的 MCMC 取樣器,但在高維空間有嚴重的限制。它的效率對步長 \(\eta\)、雜訊尺度、以及準確近似目標分佈所需的迭代次數都非常敏感。
這種低效率的核心是 mixing time(混合時間)很差:在有許多分隔開的峰(mode)的複雜資料分佈裡,Langevin 取樣常常要花極長的時間才能在高機率區域之間轉移。維度越高,問題越嚴重,收斂慢到不可行。
可以把取樣想成在一片廣大、崎嶇、有許多遙遠山谷的地形上探索,每個山谷是資料的一個峰。Langevin dynamics 只靠局部的隨機更新,很難有效率地在山谷之間移動,結果常常抓不到分佈完整的多樣性。這個低效率暗示:需要更有結構、更有引導的取樣方法,比純粹的隨機探索更能有效地在複雜的資料流形上前進。
Demo ALangevin dynamics 與 mixing轉述者補充
二維資料是兩團各占一半的高斯(形狀仿照書中的圖),score 有封閉形式(上面「一維的例子」裡的混合公式)。400 個粒子同時跑 Langevin 更新。可以調:兩團的距離、步長 \(\eta\)、要不要加雜訊(關掉就是只沿 score 走的梯度上升,也就是上面的 ODE)、以及粒子從哪裡出發。
瀏覽器實測(固定種子,全部從左團出發,\(\eta=0.05\),數字是右團的粒子比例,真值 50%):
| 距離 | 100 步 | 500 步 | 1000 步 | 2000 步 | 4000 步 |
|---|---|---|---|---|---|
| 2 | 44% | 53% | 56% | 51% | 55% |
| 3 | 20% | 49% | 51% | 50% | 53% |
| 4 | 3% | 15% | 23% | 35% | 48% |
| 5 | 0% | 2% | 2% | 6% | 10% |
- mixing time:兩團越遠,粒子越難越過中間的低密度區。距離 2、3 時幾百步就接近各半(之後在 50% 上下 ±5 個百分點波動,400 個粒子的抽樣誤差約 ±2.5);距離 5 時跑了 4,000 步,右團還只有 10%。score 本身完全正確,慢的是取樣器。
- 沒有雜訊就會卡住:關掉雜訊、從左團出發,4,000 步後右團仍是 0%,所有粒子縮到左團的中心(局部極大)就停了。從大範圍出發也一樣,粒子只會各自滑進最近的那一團中心(距離 3 時右團 55%),得到的是兩個點,不是一個分佈。
- 步長敏感:距離 3、\(\eta=0.15\) 時右團 52%,仍然正常。\(\eta=0.25\) 時卻變成 84%:左團在最窄方向的變異數約 0.106,那個方向的曲率(score 的斜率)約 9.4,\(\eta\times9.4\approx2.4\gt2\),離散更新在這個方向不穩定,粒子留不住、被彈出左團;右團最大的曲率約 6.4,\(\eta\times6.4=1.6\lt2\),仍然穩定,於是粒子越積越多在右團。所以步長太大不一定「炸掉」,也可能安靜地取到錯的分佈。
06直接學 score:score matching書 §3.2、§3.2.1
EBM 告訴我們:生成只依賴 score(它指向機率較高的方向),而不依賴完整的正規化密度。Score matching 雖然避開了 partition function,但透過能量來訓練仍然需要昂貴的二階導數。關鍵的想法是:既然 Langevin 取樣只需要 score,就直接用神經網路學 score。從「建模能量」轉向「建模 score」,就是 score-based 生成模型的基礎。
Score matching
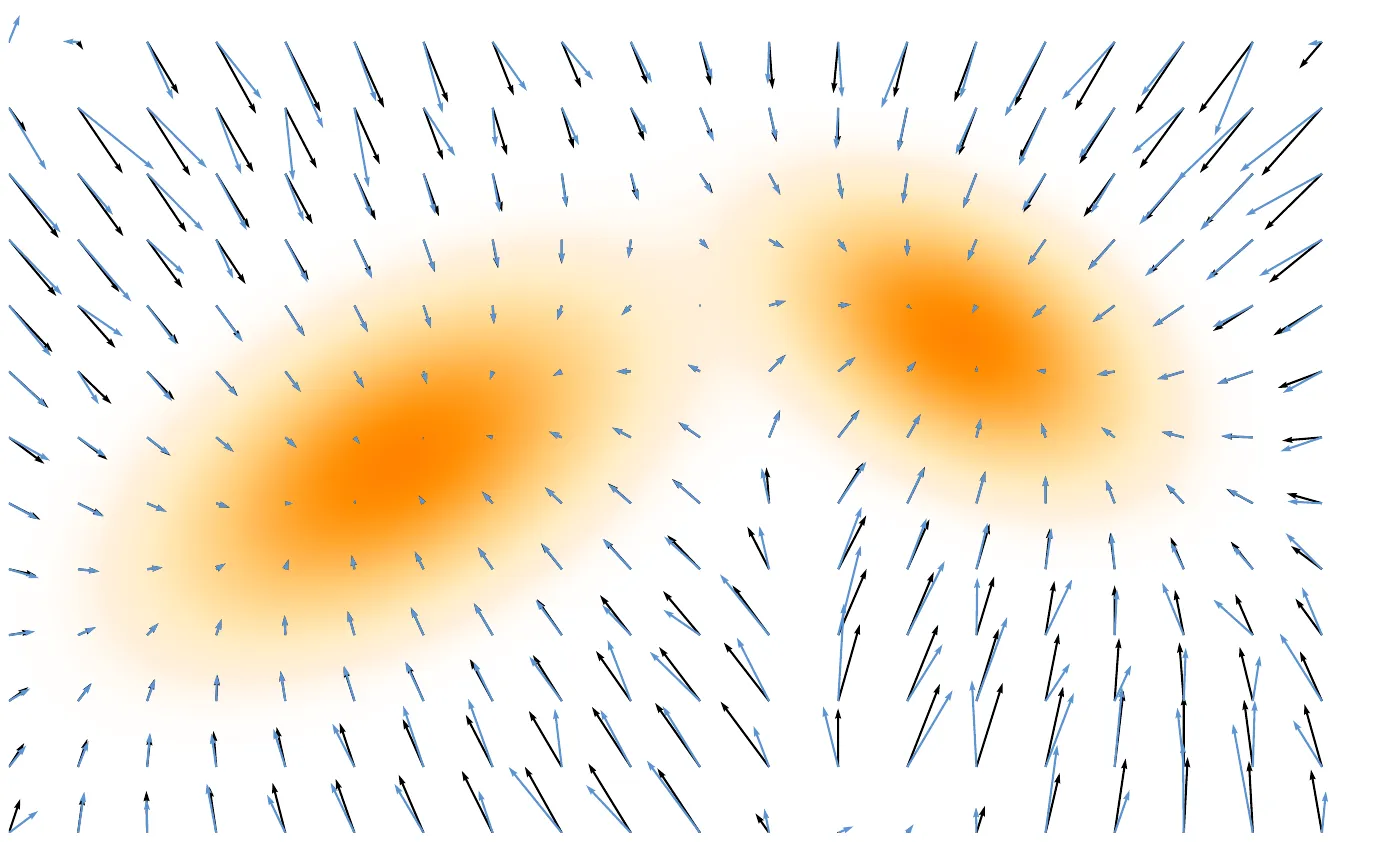
為了從 \(p_{\text{data}}\) 的樣本近似 score \(\mathbf s(\mathbf x)=\nabla_{\mathbf x}\log p_{\text{data}}(\mathbf x)\),直接把它當成一個向量場,用神經網路 \(\mathbf s_{\bm\phi}(\mathbf x)\) 參數化:\(\mathbf s_{\bm\phi}(\mathbf x)\approx\mathbf s(\mathbf x)\)。Score matching 最小化真正的 score 和估計的 score 之間的均方誤差(MSE):
好處理的 score matching
乍看之下這個目標做不到,因為回歸的目標,真正的 score \(\mathbf s(\mathbf x)\),是未知的。幸好 Hyvärinen (2005) 證明:分部積分給出一個等價的目標,只依賴模型 \(\mathbf s_{\bm\phi}\) 和資料樣本,完全不需要真正的 score:
證明(書的附錄 D.2)
1. 展開平方。
$$\mathcal L_{\text{SM}}=\tfrac12\mathbb E\Vert\mathbf s_{\bm\phi}\Vert^2-\mathbb E\langle\mathbf s_{\bm\phi},\mathbf s\rangle+\tfrac12\mathbb E\Vert\mathbf s\Vert^2,\qquad\text{期望都對 }p_{\text{data}}.$$最後一項只和資料有關,就是 \(C\)。問題只剩交叉項。
2. 交叉項裡的 \(p_{\text{data}}\) 消掉一個。用 \(\nabla\log p_{\text{data}}=\nabla p_{\text{data}}/p_{\text{data}}\)(在 \(p_{\text{data}}>0\) 的地方):
$$\mathbb E\langle\mathbf s_{\bm\phi},\mathbf s\rangle=\int\mathbf s_{\bm\phi}(\mathbf x)^\top\frac{\nabla p_{\text{data}}(\mathbf x)}{p_{\text{data}}(\mathbf x)}\,p_{\text{data}}(\mathbf x)\,d\mathbf x=\sum_{i=1}^D\int s_{\bm\phi}^{(i)}(\mathbf x)\,\partial_{x_i}p_{\text{data}}(\mathbf x)\,d\mathbf x.$$3. 分部積分。在半徑 \(R\) 的球 \(\mathbb B(\mathbf 0,R)\) 上,\(\int u\,\partial_{x_i}v=-\int v\,\partial_{x_i}u+\oint_{\partial\mathbb B}uv\,\nu_i\,dS\)(\(\nu\) 是球面的外法向量)。取 \(u=s_{\bm\phi}^{(i)}\)、\(v=p_{\text{data}}\),並假設 \(R\to\infty\) 時 \(|uv|\to0\)(資料密度在無窮遠消失得夠快),邊界項消失:
$$\mathbb E\langle\mathbf s_{\bm\phi},\mathbf s\rangle=-\sum_{i=1}^D\int\partial_{x_i}s_{\bm\phi}^{(i)}(\mathbf x)\,p_{\text{data}}(\mathbf x)\,d\mathbf x=-\mathbb E\big[\operatorname{Tr}(\nabla_{\mathbf x}\mathbf s_{\bm\phi}(\mathbf x))\big].$$(\(\sum_i\partial_{x_i}s^{(i)}\) 就是 Jacobian 對角線的和,也就是散度 \(\nabla\cdot\mathbf s_{\bm\phi}\)。)
4. 代回去。\(\mathcal L_{\text{SM}}=\mathbb E\big[\operatorname{Tr}(\nabla_{\mathbf x}\mathbf s_{\bm\phi})+\tfrac12\Vert\mathbf s_{\bm\phi}\Vert^2\big]+\underbrace{\tfrac12\mathbb E\Vert\mathbf s\Vert^2}_{C}\)。最小化解:\(\mathcal L_{\text{SM}}\ge0\),在 \(\mathbf s_{\bm\phi}=\mathbf s\) 時等於 0;兩個目標只差常數,所以最小化解相同。
用這個等價目標,score 模型 \(\mathbf s_{\bm\phi}(\mathbf x)\) 只需要 \(p_{\text{data}}\) 的觀測樣本就能訓練,完全不需要真正的 score function。
直覺:兩項各在做什麼
\(\widetilde{\mathcal L}_{\text{SM}}\) 可以從它的兩項來理解。範數項 \(\tfrac12\Vert\mathbf s_{\bm\phi}\Vert^2\) 懲罰大的 score,尤其是在 \(p_{\text{data}}\) 大的地方。散度項 \(\operatorname{Tr}(\nabla_{\mathbf x}\mathbf s_{\bm\phi})\) 以正號出現在損失裡,所以最小化目標也偏好局部收縮的行為。兩者合起來,母體最佳的 score 場是 \(\mathbf s^*(\mathbf x)=\nabla_{\mathbf x}\log p_{\text{data}}(\mathbf x)\)。
大小項的作用。因為 \(\widetilde{\mathcal L}_{\text{SM}}\) 的期望是對 \(p_{\text{data}}\) 取的,資料密度高的地方對損失的貢獻比較大,所以大小項 \(\tfrac12\Vert\mathbf s_{\bm\phi}\Vert^2\) 在這些地方對大的 score 懲罰得比較重。但單靠這一項,並不表示在每個高密度點都有 \(\mathbf s_{\bm\phi}(\mathbf x)=\mathbf 0\);在母體最佳解,\(\mathbf s^*(\mathbf x)=\nabla_{\mathbf x}\log p_{\text{data}}(\mathbf x)\),它只在 log 密度的駐點才是 0。
當向量場(近似)是梯度時的凹性。因為散度項以正號進入損失,最小化會偏好在資料分佈強調的區域有負的散度。負散度代表淨的局部收縮,雖然單靠它並不保證駐點是匯聚點(sink)。為了說清楚,假設 \(\mathbf s_{\bm\phi}=\nabla_{\mathbf x}u\),\(u:\mathbb R^D\to\mathbb R\) 是純量函數(匹配一個 log 密度時這很自然)。那麼 \(\nabla_{\mathbf x}\mathbf s_{\bm\phi}=\nabla_{\mathbf x}^2u\)(Hessian),\(\nabla\cdot\mathbf s_{\bm\phi}(\mathbf x)=\operatorname{Tr}(\nabla_{\mathbf x}^2u(\mathbf x))\)(散度)。
在駐點 \(\mathbf x_\star\),\(\mathbf s_{\bm\phi}(\mathbf x_\star)=\nabla_{\mathbf x}u(\mathbf x_\star)=\mathbf 0\),二階 Taylor 展開給出
$$u(\mathbf x)=u(\mathbf x_\star)+\tfrac12(\mathbf x-\mathbf x_\star)^\top\nabla_{\mathbf x}^2u(\mathbf x_\star)(\mathbf x-\mathbf x_\star)+o(\Vert\mathbf x-\mathbf x_\star\Vert^2).$$如果 Hessian \(\nabla_{\mathbf x}^2u(\mathbf x_\star)\) 是負定的,\(u\) 在 \(\mathbf x_\star\) 局部是凹的,log 密度在那裡取得嚴格的局部極大。因為 Hessian 的所有特徵值都是負的,trace 也是負的:\(\operatorname{Tr}(\nabla_{\mathbf x}^2u(\mathbf x_\star))\lt0\)。所以在這種情況下,駐點在 score 場下是局部吸引的:小擾動會被拉回 \(\mathbf x_\star\)。
書的註腳:嚴格的凹性(也就是 log 密度的嚴格局部極大)需要整個 Hessian 負定,不只是 trace 為負。trace 為負只保證特徵值的和是負的,有些特徵值仍可能是正的,那就是鞍點而不是極大。
一維時兩項怎麼互相拉扯
一維時 \(\widetilde{\mathcal L}_{\text{SM}}=\mathbb E[s_{\bm\phi}'(x)+\tfrac12s_{\bm\phi}(x)^2]\)。只看大小項,最好的是 \(s\equiv0\);但 \(s\equiv0\) 時散度項也是 0,損失是 0。如果讓 \(s\) 在資料的峰附近是「左正右負」的形狀(往峰指),斜率 \(s'\) 是負的,散度項變成負的、讓損失低於 0;代價是 \(s\) 不能是 0,大小項變成正的。最佳的折衷恰好是 \(s=(\log p_{\text{data}})'\)。例如資料是 \(\mathcal N(0,\sigma^2)\)、模型取 \(s(x)=-ax\):\(\widetilde{\mathcal L}=-a+\tfrac12a^2\sigma^2\),對 \(a\) 微分得 \(a=1/\sigma^2\),正是真正的 score \(-x/\sigma^2\)。最小值 \(-\tfrac1{2\sigma^2}\) 等於 \(-C\)(\(C=\tfrac12\mathbb E[x^2/\sigma^4]=\tfrac1{2\sigma^2}\)),所以 \(\mathcal L_{\text{SM}}=0\)。Demo B 會看到同樣的事:\(\widetilde{\mathcal L}_{\text{SM}}\) 一路降到負值,而它和真正的 \(\mathcal L_{\text{SM}}\) 的差一直固定在 \(C\)。
07用學到的 score 取樣書 §3.2.2、§3.2.3
用 \(\widetilde{\mathcal L}_{\text{SM}}\) 訓練好之後,score 模型 \(\mathbf s_{\bm\phi^\times}(\mathbf x)\) 就可以取代 Langevin dynamics 裡的「神諭」score(\(\times\) 表示訓練完、參數凍結,和 B04 相同):
$$\mathbf x_{n+1}=\mathbf x_n+\eta\,\mathbf s_{\bm\phi^\times}(\mathbf x_n)+\sqrt{2\eta}\,\boldsymbol\epsilon_n,\qquad\boldsymbol\epsilon_n\sim\mathcal N(\mathbf 0,\mathbf I),$$\(n=0,1,2,\dots\),從 \(\mathbf x_0\) 開始。和 EBM 的情況一樣,這個遞迴正是連續時間 Langevin SDE
$$d\mathbf x(t)=\mathbf s_{\bm\phi^\times}(\mathbf x(t))\,dt+\sqrt2\,d\mathbf w(t)$$的 Euler–Maruyama 離散化,初始值是 \(\mathbf x(0)\)。所以在小步長的極限下,離散和連續的寫法一致。實務上可以跑離散的取樣器,也可以直接模擬 SDE。
序幕:score-based 生成模型
本章接下來要看 score function 在現代 diffusion model 裡的基礎角色。score 原本是為了有效率地訓練 EBM 而引入的,後來成了新一代生成模型的核心元件。在這個基礎上,接下來探討 score 怎麼塑造 score-based diffusion model 的理論形式和實際做法,提供一個透過隨機過程生成資料的、有原則的框架。
這一頁還沒解決的兩個問題(下兩頁的伏筆)
一是 \(\widetilde{\mathcal L}_{\text{SM}}\) 仍然要算 \(\operatorname{Tr}(\nabla_{\mathbf x}\mathbf s_{\bm\phi})\),高維時代價和第 4 節一樣高;B06 用 sliced score matching 和 denoising score matching 解決。二是損失只在 \(p_{\text{data}}\) 的樣本上計算,所以在資料很少的低密度區域,學到的 score 沒有受到約束、可能很不準(書中的圖和 Demo B 都看得到),而 Langevin 從遠處出發時正好要經過這些區域;B07 的 NCSN 用多個雜訊等級解決。
Demo B用 Hyvärinen 的目標訓練一個 score 網路轉述者補充
一維資料:兩個高斯的混合(左:中心 \(-2\)、標準差 0.5、權重 0.3;右:中心 1.5、標準差 0.7、權重 0.7)。網路是兩層、每層 32 個神經元的 MLP,輸入 \(x\)、輸出 \(s_{\bm\phi}(x)\)。訓練只用資料樣本和 \(\widetilde{\mathcal L}_{\text{SM}}=\mathbb E[s_{\bm\phi}'(x)+\tfrac12s_{\bm\phi}(x)^2]\),完全不碰真正的 score;導數 \(s_{\bm\phi}'(x)\) 用很小的中央差分 \((s_{\bm\phi}(x+h)-s_{\bm\phi}(x-h))/2h\) 計算。訓練 3,000 步後,用學到的 score 跑 Langevin(2,000 個粒子,從 \(\mathcal N(0,3^2)\) 出發,\(\eta=0.01\),3,000 步)。
因為這是 toy 資料,真正的 score 已知,所以可以另外算出真正的 \(\mathcal L_{\text{SM}}\) 來對照(訓練不使用它)。兩條損失都用數值積分精確計算母體值,不是小批次的估計。
瀏覽器實測(固定種子):
- 命題的數值驗證:\(\widetilde{\mathcal L}_{\text{SM}}\) 從 8.26 一路降到 \(-1.20\)(可以是負的),真正的 \(\mathcal L_{\text{SM}}\) 從 9.52 降到 0.05。兩者的差在整個訓練過程中(每 100 步記一次)都在 1.249–1.252 之間,而 \(C=\tfrac12\mathbb E\Vert s\Vert^2=1.251\)。剩下的微小誤差來自中央差分和數值積分。訓練時完全沒用到真正的 score,卻等於在最小化和它的均方誤差。
- 取樣:訓練約 4.7 秒。用學到的 score 跑 Langevin,左團的比例在 200 步時是 42.3%、1,000 步 35.5%、3,000 步 30.0%(真值 30%);直方圖和真密度吻合。一開始偏高是因為粒子從 \(\mathcal N(0,3^2)\) 出發,有 46% 在左邊,要花一段時間才在兩團之間重新分配,這正是第 5 節的 mixing 問題。
- 低密度區的 score 不準:在兩團中心,學到的 score 幾乎完全正確(\(x=1.5\):學到 \(-0.01\)、真值 0.00);但在兩團之間的 \(x=-0.25\)(密度只有 0.018),學到 1.11、真值 3.26,score 曲線在那裡被抹平了。損失對 \(p_{\text{data}}\) 取期望,資料少的地方幾乎不影響損失(第 7 節最後的伏筆)。
與 CS236 的對照
| 本頁 | CS236 複習頁 |
|---|---|
| EBM、partition function、MLE 梯度、contrastive divergence | 第 11 講 |
| Score matching、Hyvärinen 的分部積分、Langevin 取樣 | 第 12 講 |
| Score-based model、低密度區的 score 不準、sliced/denoising score matching(下兩頁) | 第 13 講 |
| Markov 鏈、stationary distribution、mixing | 補充課 D |
| 布朗運動、Euler–Maruyama | 補充課 E |
| Fokker–Planck、為什麼 Langevin 的穩態是 \(p\)、係數 \(\sqrt2\) | 補充課 F |