Denoising score matching:加一點雜訊,score 就有了答案
上一頁的 score matching 雖然不需要真正的 score,卻要算 Jacobian 的 trace,高維時太貴。這一頁先看 sliced score matching 怎麼用隨機投影估計 trace,再看本章真正的主角 denoising score matching(DSM):先給資料加一點已知的高斯雜訊,再以乾淨資料為條件,回歸目標就變成封閉解,和 B04 的 DDPM 是同一招 conditioning trick。接著用 Tweedie 公式說明「學 score」就是「學去雜訊」,最後是兩個選讀主題:只用帶雜訊資料評估去雜訊器的 SURE,以及統一這些目標的 generalized score matching。
讀完這頁你應該能夠
- 說明 sliced score matching 怎麼用 Hutchinson 恆等式避開 trace,以及它為什麼仍然脆弱。
- 寫出 DSM 的損失,證明它和「對加雜訊後的分佈做 score matching」只差一個常數,並寫出高斯雜訊時的簡化形式。
- 說明 DSM 學到的是 \(p_\sigma=p_{\text{data}}*\mathcal N(\mathbf 0,\sigma^2\mathbf I)\) 的 score,\(\sigma\) 大小各有什麼好壞,以及加雜訊的兩個好處。
- 寫出並證明 Tweedie 公式,用它說明 score 預測和去雜訊器是同一件事;知道高階 Tweedie 給出後驗變異數。
- (選讀)寫出 SURE,說明它為什麼是 MSE 的不偏估計、最佳解為什麼是 Tweedie 的去雜訊器,以及它和 score matching 的關係;說明 generalized score matching 的算子觀點。
前置知識
- B05:score、score matching \(\mathcal L_{\text{SM}}\) 與 Hyvärinen 的 \(\widetilde{\mathcal L}_{\text{SM}}\)、分部積分、Langevin 取樣。
- B04:conditioning trick(條件 KL 與邊際 KL 只差常數)、平方誤差的最佳解是條件期望、\(\boldsymbol\epsilon\)-prediction 與 \(\mathbf x\)-prediction。
- 卷積、後驗分佈、條件期望與條件變異數:CS236 補充課 A。
「書 §」標出原文位置。灰框「轉述者補充」是書裡沒有的內容;藍框「推導」展開書中省略的步驟或附錄 D 的證明。書把 §3.3.5(SURE)和 §3.3.6(generalized score matching)標為選讀,本頁照樣標示。本頁的 \(\mathbf x\) 是乾淨資料、\(\tilde{\mathbf x}\) 是加了雜訊的資料。
01動機:trace 太貴書 §3.3.1
B05 的替代目標
$$\widetilde{\mathcal L}_{\text{SM}}(\bm\phi)=\mathbb E_{\mathbf x\sim p_{\text{data}}}\Big[\operatorname{Tr}\big(\nabla_{\mathbf x}\mathbf s_{\bm\phi}(\mathbf x)\big)+\tfrac12\Vert\mathbf s_{\bm\phi}(\mathbf x)\Vert_2^2\Big]$$比較好處理,但仍然要算 Jacobian 的 trace \(\operatorname{Tr}(\nabla_{\mathbf x}\mathbf s_{\bm\phi}(\mathbf x))\)。雖然不必建出整個 Jacobian 矩陣,精確計算一般要把每個輸入座標的導數資訊加起來,所以輸入維度 \(D\) 越大越貴,高維時計算代價很高。
為了解決這點,sliced score matching(Song et al. 2020)用以隨機投影為基礎的隨機估計取代 trace 項。下面簡述它的想法。
Sliced score matching 與 Hutchinson 估計
Sliced score matching 把 trace 換成沿著隨機「切片」方向的方向導數的平均。令 \(\mathbf u\in\mathbb R^D\) 是一個各向同性的隨機向量(例如 Rademacher,每個分量是等機率的 \(\pm1\);或標準高斯),滿足 \(\mathbb E[\mathbf u]=\mathbf 0\)、\(\mathbb E[\mathbf u\mathbf u^\top]=\mathbf I\)。由 Hutchinson 恆等式
$$\operatorname{Tr}(\mathbf A)=\mathbb E_{\mathbf u}\big[\mathbf u^\top\mathbf A\mathbf u\big],\qquad\mathbb E_{\mathbf u}\big[(\mathbf u^\top\mathbf s_{\bm\phi}(\mathbf x))^2\big]=\Vert\mathbf s_{\bm\phi}(\mathbf x)\Vert_2^2,$$得到精確的等價形式
$$\widetilde{\mathcal L}_{\text{SM}}(\bm\phi)=\mathbb E_{\mathbf x,\mathbf u}\Big[\mathbf u^\top\big(\nabla_{\mathbf x}\mathbf s_{\bm\phi}(\mathbf x)\big)\mathbf u+\tfrac12\big(\mathbf u^\top\mathbf s_{\bm\phi}(\mathbf x)\big)^2\Big].$$兩個恆等式的推導
\(\mathbf u^\top\mathbf A\mathbf u=\sum_{i,j}A_{ij}u_iu_j\),取期望:\(\mathbb E[u_iu_j]=(\mathbb E[\mathbf u\mathbf u^\top])_{ij}=\delta_{ij}\),所以只剩對角線,\(\sum_iA_{ii}=\operatorname{Tr}(\mathbf A)\)。
第二式:\((\mathbf u^\top\mathbf s)^2=\mathbf s^\top\mathbf u\mathbf u^\top\mathbf s\),取期望得 \(\mathbf s^\top\mathbf I\mathbf s=\Vert\mathbf s\Vert^2\)。它其實是第一式在 \(\mathbf A=\mathbf s\mathbf s^\top\) 的特例。
這個目標可以用自動微分有效率地計算:用 Jacobian-vector product 和 vector-Jacobian product(JVP/VJP),不必明確算出大的 Jacobian 或 Hessian 矩陣。對 \(K\) 個隨機探針取平均,得到變異數 \(\mathcal O(1/K)\) 的不偏估計;方向項 \(\mathbf u^\top(\nabla_{\mathbf x}\mathbf s_{\bm\phi})\mathbf u\) 一次 JVP 就能算出。直覺上,這表示只沿著隨機方向檢查模型的行為:投影後的 score 被推向和資料高密度區域對齊,讓資料點在期望上成為駐點。
為什麼一次 JVP 就夠、兩種探針哪個好
\((\nabla_{\mathbf x}\mathbf s_{\bm\phi})\mathbf u\) 是「\(\mathbf s_{\bm\phi}\) 沿 \(\mathbf u\) 方向的方向導數」,前向模式自動微分一次就能算出(代價約等於一次前向傳播),再和 \(\mathbf u\) 內積就是 \(\mathbf u^\top(\nabla\mathbf s)\mathbf u\)。精確的 trace 則要 \(D\) 次。
單一探針的變異數:Rademacher 是 \(2\sum_{i\ne j}A_{ij}^2\)(\(\mathbf A\) 對稱時),標準高斯是 \(2\Vert\mathbf A\Vert_F^2=2\sum_{i,j}A_{ij}^2\)。Rademacher 少了對角線的貢獻,所以通常比較小;\(K\) 個探針平均後都再除以 \(K\)。Demo A 可以直接看到這兩個數字。
從 sliced 到 denoising score matching
Sliced score matching 避開了 Jacobian,但仍然依賴原始的資料分佈,這讓它很脆弱:
- 影像資料落在低維流形上時,score \(\nabla_{\mathbf x}\log p_{\text{data}}(\mathbf x)\) 可能沒有定義或不穩定;
- 這個方法只在觀測到的資料點上約束向量場,對它們的鄰近區域控制很弱;
- 它還受到探針帶來的變異數,以及反覆 JVP/VJP 的計算成本所苦。
本頁聚焦的、更穩健的替代方案是 Denoising Score Matching(DSM;Vincent 2011),它提供了有原則、可擴展的解法。
Demo AHutchinson 估計:用隨機探針估 trace轉述者補充
一個固定的 \(20\times20\) 隨機對稱矩陣 \(\mathbf A\)(模擬一個 Jacobian)。每次估計抽 \(K\) 個探針 \(\mathbf u\),用 \(\frac1K\sum_k\mathbf u_k^\top\mathbf A\mathbf u_k\) 估 \(\operatorname{Tr}(\mathbf A)\),重複 2,000 次,畫出估計值的分佈。
瀏覽器實測(真正的 trace 是 23.75):兩種探針的平均都落在 23.6–24.1,是不偏的;標準差和上面「轉述者補充」的理論值相符,並隨 \(1/\sqrt K\) 縮小。\(K=1\) 時 Rademacher 10.73(理論 11.01)、高斯 13.92(理論 14.50);\(K=32\) 時 Rademacher 1.93、高斯 2.53。Rademacher 一直比較窄,因為它的 \(u_i^2\) 恆為 1,對角線不貢獻變異數。
02DSM 的訓練目標書 §3.3.2
回到 B05 的 SM 損失:
$$\mathcal L_{\text{SM}}(\bm\phi)=\frac12\,\mathbb E_{\mathbf x\sim p_{\text{data}}(\mathbf x)}\Big[\big\Vert\mathbf s_{\bm\phi}(\mathbf x)-\nabla_{\mathbf x}\log p_{\text{data}}(\mathbf x)\big\Vert_2^2\Big],$$問題出在算不出來的 \(\nabla_{\mathbf x}\log p_{\text{data}}(\mathbf x)\)。
Vincent 的解法:條件化
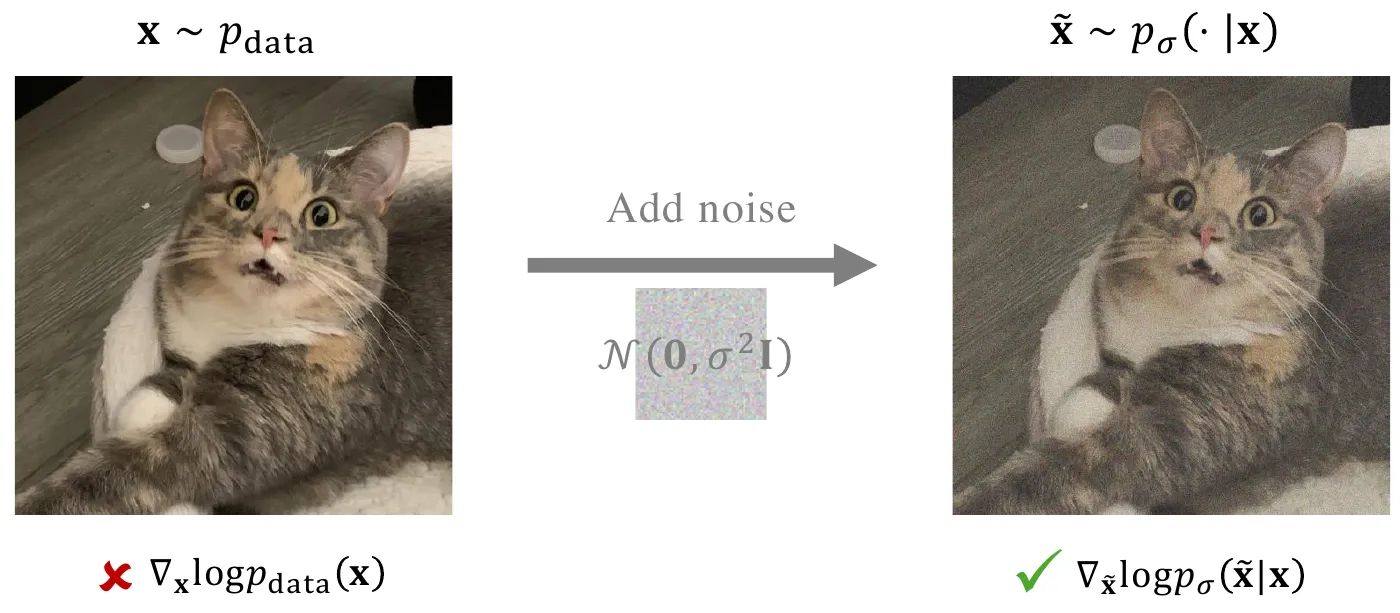
為了克服 \(\nabla_{\mathbf x}\log p_{\text{data}}(\mathbf x)\) 算不出來的問題,Vincent (2011) 提議透過一個已知的條件分佈 \(p_\sigma(\tilde{\mathbf x}\mid\mathbf x)\)(尺度為 \(\sigma\))對資料 \(\mathbf x\sim p_{\text{data}}\) 注入雜訊。神經網路 \(\mathbf s_{\bm\phi}(\tilde{\mathbf x},\sigma)\) 被訓練來近似擾動後的邊際分佈
$$p_\sigma(\tilde{\mathbf x})=\int p_\sigma(\tilde{\mathbf x}\mid\mathbf x)\,p_{\text{data}}(\mathbf x)\,d\mathbf x$$的 score,方法是最小化
$$\mathcal L_{\text{SM}}(\bm\phi;\sigma):=\frac12\,\mathbb E_{\tilde{\mathbf x}\sim p_\sigma}\Big[\big\Vert\mathbf s_{\bm\phi}(\tilde{\mathbf x},\sigma)-\nabla_{\tilde{\mathbf x}}\log p_\sigma(\tilde{\mathbf x})\big\Vert_2^2\Big].$$雖然 \(\nabla_{\tilde{\mathbf x}}\log p_\sigma(\tilde{\mathbf x})\) 一般也算不出來,Vincent (2011) 證明:以 \(\mathbf x\sim p_{\text{data}}\) 為條件,可以得到一個等價、好處理的目標,也就是 Denoising Score Matching(DSM)損失:
它的最佳解 \(\mathbf s^*\) 滿足 \(\mathbf s^*(\tilde{\mathbf x},\sigma)=\nabla_{\tilde{\mathbf x}}\log p_\sigma(\tilde{\mathbf x})\),這也是 \(\mathcal L_{\text{SM}}(\bm\phi;\sigma)\) 的最佳解。
例如,當 \(p_\sigma(\tilde{\mathbf x}\mid\mathbf x)\) 是變異數 \(\sigma^2\) 的高斯雜訊 \(\mathcal N(\tilde{\mathbf x};\mathbf x,\sigma^2\mathbf I)\),梯度 \(\nabla_{\tilde{\mathbf x}}\log p_\sigma(\tilde{\mathbf x}\mid\mathbf x)\) 有封閉形式(見下面的特例),回歸目標明確、好算。
而且當 \(\sigma\approx0\),\(p_\sigma(\tilde{\mathbf x})\approx p_{\text{data}}(\mathbf x)\),所以
$$\mathbf s^*(\tilde{\mathbf x},\sigma)=\nabla_{\tilde{\mathbf x}}\log p_\sigma(\tilde{\mathbf x})\approx\nabla_{\mathbf x}\log p_{\text{data}}(\mathbf x),$$學到的 score 近似原本資料的 score,可以拿來生成。下面的定理把 \(\mathcal L_{\text{SM}}\) 和 \(\mathcal L_{\text{DSM}}\) 梯度相等這件事說清楚:
證明(書的附錄 D.2)
1. 把兩個平方都展開。各得三項:\(\Vert\mathbf s_{\bm\phi}\Vert^2\)、交叉項、目標的平方。兩式相減,逐項比較。
2. 第一項相同。\(\Vert\mathbf s_{\bm\phi}(\tilde{\mathbf x},\sigma)\Vert^2\) 只依賴 \(\tilde{\mathbf x}\),而對 \(p_\sigma(\tilde{\mathbf x})\) 取期望,和先抽 \(\mathbf x\) 再抽 \(\tilde{\mathbf x}\mid\mathbf x\) 取期望是同一件事(因為 \(p_\sigma(\tilde{\mathbf x})=\int p_\sigma(\tilde{\mathbf x}\mid\mathbf x)p_{\text{data}}(\mathbf x)d\mathbf x\),交換積分順序)。差為 0。
3. 交叉項也相同(關鍵)。
$$\begin{aligned}\mathbb E_{p_\sigma(\tilde{\mathbf x})}\big[\mathbf s_{\bm\phi}^\top\nabla\log p_\sigma(\tilde{\mathbf x})\big]&=\int\mathbf s_{\bm\phi}^\top\nabla_{\tilde{\mathbf x}}p_\sigma(\tilde{\mathbf x})\,d\tilde{\mathbf x}=\int\mathbf s_{\bm\phi}^\top\nabla_{\tilde{\mathbf x}}\!\int p_\sigma(\tilde{\mathbf x}\mid\mathbf x)p_{\text{data}}(\mathbf x)\,d\mathbf x\,d\tilde{\mathbf x}\\&=\iint p_{\text{data}}(\mathbf x)\,\mathbf s_{\bm\phi}^\top\nabla_{\tilde{\mathbf x}}p_\sigma(\tilde{\mathbf x}\mid\mathbf x)\,d\tilde{\mathbf x}\,d\mathbf x=\mathbb E_{p_{\text{data}}(\mathbf x)p_\sigma(\tilde{\mathbf x}\mid\mathbf x)}\big[\mathbf s_{\bm\phi}^\top\nabla_{\tilde{\mathbf x}}\log p_\sigma(\tilde{\mathbf x}\mid\mathbf x)\big].\end{aligned}$$第一步用 \(p\nabla\log p=\nabla p\);第二步把邊際寫成積分、微分移進積分;最後一步再用一次 \(\nabla p(\cdot\mid\mathbf x)=p(\cdot\mid\mathbf x)\nabla\log p(\cdot\mid\mathbf x)\)。差為 0。
4. 剩下的第三項是 \(C=\tfrac12\big(\mathbb E_{p_\sigma}\Vert\nabla\log p_\sigma(\tilde{\mathbf x})\Vert^2-\mathbb E_{p_{\text{data}}p_\sigma(\cdot\mid\mathbf x)}\Vert\nabla\log p_\sigma(\tilde{\mathbf x}\mid\mathbf x)\Vert^2\big)\),只依賴 \(p_{\text{data}}\) 和 \(p_\sigma(\tilde{\mathbf x}\mid\mathbf x)\),和 \(\bm\phi\) 無關。
最小化解(書用另一個命題的同樣論證,這裡直接寫出):\(\mathcal L_{\text{DSM}}\) 對每個 \(\tilde{\mathbf x}\) 是一個平方誤差,最佳解是目標的條件期望 \(\mathbf s^*(\tilde{\mathbf x})=\mathbb E_{p(\mathbf x\mid\tilde{\mathbf x})}[\nabla_{\tilde{\mathbf x}}\log p_\sigma(\tilde{\mathbf x}\mid\mathbf x)]\)。由貝氏定理 \(p(\mathbf x\mid\tilde{\mathbf x})=p_\sigma(\tilde{\mathbf x}\mid\mathbf x)p_{\text{data}}(\mathbf x)/p_\sigma(\tilde{\mathbf x})\):
$$\mathbf s^*(\tilde{\mathbf x})=\int\frac{p_\sigma(\tilde{\mathbf x}\mid\mathbf x)p_{\text{data}}(\mathbf x)}{p_\sigma(\tilde{\mathbf x})}\cdot\frac{\nabla_{\tilde{\mathbf x}}p_\sigma(\tilde{\mathbf x}\mid\mathbf x)}{p_\sigma(\tilde{\mathbf x}\mid\mathbf x)}\,d\mathbf x=\frac{\nabla_{\tilde{\mathbf x}}\int p_\sigma(\tilde{\mathbf x}\mid\mathbf x)p_{\text{data}}(\mathbf x)\,d\mathbf x}{p_\sigma(\tilde{\mathbf x})}=\nabla_{\tilde{\mathbf x}}\log p_\sigma(\tilde{\mathbf x}).$$一句話:條件 score 的後驗平均,就是邊際 score。
這個定理和 B04 DDPM 的定理(邊際 KL 與條件 KL 只差常數)一樣,展示了一個共通的原則:
特例:加性高斯雜訊
現在考慮最常見的情況:對每個資料點 \(\mathbf x\sim p_{\text{data}}\) 加上變異數 \(\sigma^2\) 的高斯雜訊 \(\mathcal N(\mathbf 0,\sigma^2\mathbf I)\):
$$\tilde{\mathbf x}=\mathbf x+\sigma\boldsymbol\epsilon,\quad\boldsymbol\epsilon\sim\mathcal N(\mathbf 0,\mathbf I),\qquad p_\sigma(\tilde{\mathbf x}\mid\mathbf x)=\mathcal N(\tilde{\mathbf x};\mathbf x,\sigma^2\mathbf I).$$這時條件 score 有解析式:
$$\nabla_{\tilde{\mathbf x}}\log p_\sigma(\tilde{\mathbf x}\mid\mathbf x)=\frac{\mathbf x-\tilde{\mathbf x}}{\sigma^2}.$$所以 DSM 損失化簡成
其中 \(\boldsymbol\epsilon\sim\mathcal N(\mathbf 0,\mathbf I)\)。書說這個目標是(score-based)diffusion model 的核心。
條件 score 與第二個等號
\(\log\mathcal N(\tilde{\mathbf x};\mathbf x,\sigma^2\mathbf I)=-\frac{\Vert\tilde{\mathbf x}-\mathbf x\Vert^2}{2\sigma^2}+\text{常數}\),對 \(\tilde{\mathbf x}\) 微分得 \(-\frac{\tilde{\mathbf x}-\mathbf x}{\sigma^2}=\frac{\mathbf x-\tilde{\mathbf x}}{\sigma^2}\)。代入 \(\tilde{\mathbf x}-\mathbf x=\sigma\boldsymbol\epsilon\):目標是 \(-\sigma\boldsymbol\epsilon/\sigma^2=-\boldsymbol\epsilon/\sigma\),所以 \(\mathbf s_{\bm\phi}-(-\boldsymbol\epsilon/\sigma)=\mathbf s_{\bm\phi}+\boldsymbol\epsilon/\sigma\)。
和 B04 的 \(\boldsymbol\epsilon\)-prediction 是同一件事
如果把網路寫成 \(\mathbf s_{\bm\phi}(\tilde{\mathbf x},\sigma)=-\boldsymbol\epsilon_{\bm\phi}(\tilde{\mathbf x},\sigma)/\sigma\),DSM 損失變成 \(\frac1{2\sigma^2}\mathbb E\Vert\boldsymbol\epsilon_{\bm\phi}-\boldsymbol\epsilon\Vert^2\):在單一雜訊等級下,正是 B04 的 \(\mathcal L_{\text{simple}}\) 的形式(只差權重 \(\frac1{2\sigma^2}\))。最佳解 \(\boldsymbol\epsilon^*=\mathbb E[\boldsymbol\epsilon\mid\tilde{\mathbf x}]\),所以 \(\nabla\log p_\sigma(\tilde{\mathbf x})=-\mathbb E[\boldsymbol\epsilon\mid\tilde{\mathbf x}]/\sigma\)。B07 會把這個關係推廣到 DDPM 的每一個雜訊等級(書 §3.4.2,B07 第 2 節)。Demo B 的網路就是這樣參數化的。
也注意回歸目標 \(-\boldsymbol\epsilon/\sigma\) 本身的雜訊很大:它的變異數是 \(D/\sigma^2\),而真正要學的 score 只是它的條件平均。\(\sigma\) 越小,雜訊越大。
在固定的雜訊等級 \(\sigma>0\),DSM 學到的是被高斯平滑過的分佈
$$p_\sigma=p_{\text{data}}*\mathcal N(\mathbf 0,\sigma^2\mathbf I)$$的 score,而不是 \(p_{\text{data}}\) 本身的 score。\(\sigma\) 小時,破壞很輕微,\(p_\sigma\) 仍然緊貼資料分佈的局部結構,所以它的 score 是把帶雜訊樣本推回可能資料區域的有用方向。\(\sigma\) 越大,高斯平滑會逐漸抹掉細節、合併相近的峰,對應的 score 主要捕捉比較粗的、全域的結構。書強調這種行為是有用的,而不是缺點:第 3.4 節(B07)的多雜訊建構刻意把許多雜訊等級組合起來,用大雜訊做粗略的探索、用小雜訊做精細的修正。
為了更清楚看出這個目標為什麼自然對應「去雜訊」,第 4、5 節(書 §3.3.4、§3.3.5)會進一步說明。
03取樣與加雜訊的好處書 §3.3.3
在雜訊等級 \(\sigma\) 訓練好 score 模型 \(\mathbf s_{\bm\phi^\times}(\tilde{\mathbf x},\sigma)\) 之後,用 Langevin dynamics 生成樣本,把真正的 score 換成學到的模型:
$$\tilde{\mathbf x}_{n+1}=\tilde{\mathbf x}_n+\eta\,\underbrace{\mathbf s_{\bm\phi^\times}(\tilde{\mathbf x}_n,\sigma)}_{\approx\nabla_{\tilde{\mathbf x}}\log p_\sigma(\tilde{\mathbf x}_n)}+\sqrt{2\eta}\,\boldsymbol\epsilon_n,\qquad\boldsymbol\epsilon_n\sim\mathcal N(\mathbf 0,\mathbf I),$$\(n=0,1,2,\dots\),從初始值 \(\tilde{\mathbf x}_0\) 開始。如果 \(\sigma\) 夠小,跑夠多次之後 \(\tilde{\mathbf x}_n\) 就近似來自 \(p_{\text{data}}\) 的樣本。
加雜訊的好處
書另外指出,和 B05 的原始 score matching 相比,注入高斯雜訊形成 \(p_\sigma\) 有兩個關鍵好處(Song & Ermon 2019):
- 梯度處處有定義。雜訊把資料推離它所在的低維流形,得到的 \(p_\sigma\) 在整個 \(\mathbb R^D\) 上都有正的密度(full support),所以 score \(\nabla_{\tilde{\mathbf x}}\log p_\sigma(\tilde{\mathbf x})\) 處處有定義。
- 覆蓋範圍更好。雜訊把峰與峰之間稀疏的區域抹平,提升訓練訊號的品質,也讓 Langevin dynamics 比較容易穿過低密度區。
為什麼流形上的 score 會沒有定義
舉個極端的例子:二維資料全部落在一條直線 \(y=0\) 上。這時 \(p_{\text{data}}\) 在平面上沒有密度(直線的面積是 0),離開直線一點點,\(\log p_{\text{data}}=-\infty\),梯度無從談起。加上 \(\sigma\) 的高斯雜訊後,\(p_\sigma\) 在 \(y\) 方向是寬度約 \(\sigma\) 的高斯,score 在 \(y\) 方向是 \(-y/\sigma^2\):處處有定義,並把點拉回直線。影像資料的有效維度遠小於像素數,正是這種情況。
Demo B訓練 DSM:雜訊很大的目標,平均出真正的 score轉述者補充
一維資料:三個窄峰(位置 \(-1.5\)、\(0.3\)、\(1.8\),權重 0.35、0.40、0.25,每個標準差 0.1,和 B04 相同)。選一個 \(\sigma\),按「訓練」:一個兩層、每層 32 個神經元的 MLP,用 \(\mathcal L_{\text{DSM}}\) 訓練 3,000 步。網路輸出除以 \(\sigma\)(上面「和 \(\boldsymbol\epsilon\)-prediction 是同一件事」的參數化)。訓練只用資料樣本和加進去的雜訊;因為 \(p_\sigma\) 在這個例子裡可以精確算出,圖上另外畫出真正的 score 和真正的後驗平均來對照。
瀏覽器實測(固定種子,每個 \(\sigma\) 約 2 秒):
| \(\sigma\) | 0.1 | 0.3 | 0.6 | 1.0 |
|---|---|---|---|---|
| \(\mathcal L_{\text{DSM}}\) | 25.615 | 1.309 | 0.900 | 0.292 |
| \(\mathcal L_{\text{SM}}(\bm\phi;\sigma)\) | 0.615 | 0.070 | 0.001 | 0.001 |
| \(C\)(理論值) | \(-25.000\) | \(-1.239\) | \(-0.899\) | \(-0.292\) |
| score 的均方根誤差 | 1.109 | 0.375 | 0.041 | 0.036 |
| Langevin 三段比例 | 37.0 / 33.1 / 29.9% | 29.8 / 44.3 / 25.9% | 34.2 / 39.9 / 25.9% | 34.4 / 36.7 / 28.8% |
| \(p_\sigma\) 三段的質量 | 35.0 / 40.0 / 25.0% | 35.0 / 39.9 / 25.1% | 35.4 / 38.0 / 26.6% | 36.1 / 35.3 / 28.6% |
- 定理的數值驗證:每個 \(\sigma\) 的 \(\mathcal L_{\text{SM}}-\mathcal L_{\text{DSM}}\) 都精確等於 \(C\)(兩者都用數值積分算母體值,取到小數第三位一致)。訓練時只看得到 DSM 的目標,卻等於在最小化和真正 score 的差距。
- \(\sigma\) 小時目標幾乎全是雜訊:\(\sigma=0.1\) 時 \(\mathcal L_{\text{DSM}}=25.6\),其中 25.0 是學不掉的常數 \(-C=\tfrac12\big(1/\sigma^2-\mathbb E\Vert\nabla\log p_\sigma\Vert^2\big)=\tfrac12(100-50)\),真正可以學的部分只有 0.6。第一張圖的散點也看得出來:\(\sigma\) 越小,散點越分散,真正的 score 只是它們的條件平均。
- \(\sigma\) 小時 score 難學、低密度區最糟:\(\sigma=0.1\) 時真正的 score 在峰與峰之間是陡峭的鋸齒(例如 \(\tilde x=1.05\) 處是 \(-8.65\)),那裡幾乎沒有訓練樣本,學到的只有 \(-0.77\)。\(\sigma\ge0.6\) 時 \(p_\sigma\) 處處有足夠的樣本,score 誤差降到 0.04 左右。
- 去雜訊器比 score 準:Tweedie 把 score 的誤差乘上 \(\sigma^2\)。\(\sigma=0.1\) 時 score 在峰中心誤差約 0.4–0.9,去雜訊的結果誤差卻不到 0.01(讀數裡 \(\tilde x=-1.5,0.3,1.8\) 的三行)。第二張圖裡,學到的去雜訊器幾乎貼著真正的 \(\mathbb E[\mathbf x\mid\tilde{\mathbf x}]\);\(\sigma\) 小時它接近 \(y=\tilde x\)(雜訊小,幾乎不用改),\(\sigma\) 大時往三個峰的位置拉平。
- 學到的是 \(p_\sigma\),不是 \(p_{\text{data}}\):第三張圖的樣本跟著 \(p_\sigma\)(虛線)走。\(\sigma=1\) 時三個峰完全合成一團,樣本也是一團;\(\sigma=0.1\) 時樣本是三個尖峰。
- \(\sigma\) 小時 mixing 失敗:\(\sigma=0.1\) 的三段比例 37.0 / 33.1 / 29.9%,幾乎就是起始粒子 \(\mathcal N(0,2^2)\) 落在三段的比例(38.5 / 30.2 / 31.3%),而不是 \(p_\sigma\) 的 35 / 40 / 25%:粒子各自滑進最近的峰,之後就出不來了(B05 的 mixing 問題)。\(\sigma=0.3\) 時比例偏了約 5 個百分點,因為峰之間的 score 學得不準;\(\sigma=0.6\)、1.0 時和 \(p_\sigma\) 只差 1–2 個百分點。
結論正好是第 2 節最後那段話的具體版本:小 \(\sigma\) 貼近資料但難學、難混合;大 \(\sigma\) 好學、好混合,但分佈被抹平了。B07 的 NCSN 會把多個 \(\sigma\) 串起來,兩邊的好處都拿到。
04為什麼 DSM 就是去雜訊:Tweedie 公式書 §3.3.4
先看 Tweedie 公式(Efron 2011),它為「只從帶雜訊的觀測去雜訊」提供了有原則的基礎。具體地說:給定一個來自未知 \(\mathbf x\sim p_{\text{data}}\) 的單一高斯破壞觀測 \(\tilde{\mathbf x}\sim\mathcal N(\cdot;\alpha\mathbf x,\sigma^2\mathbf I)\),去雜訊的估計(給定 \(\tilde{\mathbf x}\) 時,所有可能的乾淨訊號的平均)可以這樣得到:把 \(\tilde{\mathbf x}\) 沿著帶雜訊邊際分佈的 score 方向推一步,步長是 \(\sigma^2\)。這裡的邊際分佈是
$$p_\sigma(\tilde{\mathbf x}):=\int\mathcal N(\tilde{\mathbf x};\alpha\mathbf x,\sigma^2\mathbf I)\,p_{\text{data}}(\mathbf x)\,d\mathbf x.$$證明(書的附錄 D.2;書證的是時間版本 \(\alpha_t,\sigma_t\),這裡用 \(\alpha,\sigma\) 寫)
1. 邊際的 score。\(\nabla\log p_\sigma(\tilde{\mathbf x})=\frac{\nabla p_\sigma(\tilde{\mathbf x})}{p_\sigma(\tilde{\mathbf x})}=\frac1{p_\sigma(\tilde{\mathbf x})}\int\nabla_{\tilde{\mathbf x}}p(\tilde{\mathbf x}\mid\mathbf x)\,p_{\text{data}}(\mathbf x)\,d\mathbf x\)。
2. 高斯條件密度的梯度。\(\nabla_{\tilde{\mathbf x}}p(\tilde{\mathbf x}\mid\mathbf x)=-p(\tilde{\mathbf x}\mid\mathbf x)\,\sigma^{-2}(\tilde{\mathbf x}-\alpha\mathbf x)\)。
3. 代入、用貝氏定理換成後驗。\(p(\tilde{\mathbf x}\mid\mathbf x)p_{\text{data}}(\mathbf x)=p(\mathbf x\mid\tilde{\mathbf x})p_\sigma(\tilde{\mathbf x})\):
$$\nabla p_\sigma(\tilde{\mathbf x})=-\sigma^{-2}\int(\tilde{\mathbf x}-\alpha\mathbf x)\,p(\mathbf x\mid\tilde{\mathbf x})\,p_\sigma(\tilde{\mathbf x})\,d\mathbf x=-p_\sigma(\tilde{\mathbf x})\,\sigma^{-2}\big(\tilde{\mathbf x}-\alpha\,\mathbb E[\mathbf x\mid\tilde{\mathbf x}]\big).$$4. 除以 \(p_\sigma(\tilde{\mathbf x})\)、移項:\(\nabla\log p_\sigma(\tilde{\mathbf x})=-\sigma^{-2}(\tilde{\mathbf x}-\alpha\mathbb E[\mathbf x\mid\tilde{\mathbf x}])\),即 \(\tilde{\mathbf x}+\sigma^2\nabla\log p_\sigma(\tilde{\mathbf x})=\alpha\,\mathbb E[\mathbf x\mid\tilde{\mathbf x}]\)。
Tweedie 公式在 diffusion model 裡扮演核心角色:像 DDPM 那樣引入多層雜訊時,它讓我們能透過 score 從帶雜訊的觀測估計乾淨樣本,因此在 score 預測和去雜訊器之間建立了根本的連結:
$$\underbrace{\mathbb E[\mathbf x\mid\tilde{\mathbf x}]}_{\substack{\text{去雜訊器}\\\text{從 }\tilde{\mathbf x}\text{ 估計}}}=\frac1\alpha\big(\tilde{\mathbf x}+\sigma^2\nabla_{\tilde{\mathbf x}}\log p_\sigma(\tilde{\mathbf x})\big).$$特別是:在帶雜訊的 log 概似上,以特定的步長 \(\sigma^2\) 做一步梯度上升,得到的就是去雜訊的估計(條件平均的乾淨訊號)。這讓 DSM 訓練和去雜訊緊密相關:如果用 DSM 訓練出 \(\mathbf s_{\bm\phi}(\tilde{\mathbf x})\approx\nabla_{\tilde{\mathbf x}}\log p_\sigma(\tilde{\mathbf x})\),那麼
$$\frac1\alpha\big(\tilde{\mathbf x}+\sigma^2\mathbf s_{\bm\phi}(\tilde{\mathbf x})\big)$$就是去雜訊器。
和 B04 的三種預測連起來
把 DDPM 的 \(\mathbf x_i=\bar\alpha_i\mathbf x_0+\sqrt{1-\bar\alpha_i^2}\,\boldsymbol\epsilon\) 代入 Tweedie(\(\alpha=\bar\alpha_i\)、\(\sigma^2=1-\bar\alpha_i^2\)):\(\bar\alpha_i\mathbf x^*=\mathbf x_i+(1-\bar\alpha_i^2)\nabla\log p_i(\mathbf x_i)\)。再和 B04 的 \(\mathbf x_i=\bar\alpha_i\mathbf x^*+\sqrt{1-\bar\alpha_i^2}\,\boldsymbol\epsilon^*\) 比較,得到
$$\nabla\log p_i(\mathbf x_i)=-\frac{\boldsymbol\epsilon^*(\mathbf x_i,i)}{\sqrt{1-\bar\alpha_i^2}}.$$所以 score、雜訊預測、乾淨資料預測三者互相決定。這是第 3 章開頭說的「DDPM 的 \(\boldsymbol\epsilon\)-prediction 和 score 的深刻等價」,B07 第 2 節(書 §3.4.2)會正式寫出來。
(選讀)高階 Tweedie 公式
古典的 Tweedie 公式用梯度 \(\nabla_{\tilde{\mathbf x}}\log p(\tilde{\mathbf x})\) 表示後驗平均 \(\mathbb E[\mathbf x_0\mid\tilde{\mathbf x}]\)。高階的推廣(Meng et al. 2021)用 \(\log p(\tilde{\mathbf x})\) 的高階導數表示後驗的共變異數和更高階的 cumulant(累積量)。
指數族的設定與 log-normalizer \(\lambda(\tilde{\mathbf x})\)。假設給定潛在的自然參數 \(\bm\eta\in\mathbb R^D\) 時,\(\tilde{\mathbf x}\) 的條件分佈屬於一個自然指數族:
$$q_\sigma(\tilde{\mathbf x}\mid\bm\eta)=\exp\big(\bm\eta^\top\tilde{\mathbf x}-\psi(\bm\eta)\big)\,q_0(\tilde{\mathbf x}).$$\(q_0(\tilde{\mathbf x})\) 是基底測度(base measure),也就是不依賴 \(\bm\eta\) 的部分;對變異數 \(\sigma^2\mathbf I\) 的加性高斯雜訊,它是 \((2\pi\sigma^2)^{-D/2}\exp(-\Vert\tilde{\mathbf x}\Vert^2/2\sigma^2)\)。令 \(p(\bm\eta)\) 是潛在自然參數的事先給定分佈,可以看成重新參數化的乾淨資料分佈(高斯位置模型時 \(\bm\eta=\mathbf x/\sigma^2\))。觀測到的帶雜訊邊際是
$$p_\sigma(\tilde{\mathbf x})=\int q_\sigma(\tilde{\mathbf x}\mid\bm\eta)\,p(\bm\eta)\,d\bm\eta.$$定義 \(\tilde{\mathbf x}\) 的 log-partition(log-normalizer)\(\lambda(\tilde{\mathbf x}):=\log p_\sigma(\tilde{\mathbf x})-\log q_0(\tilde{\mathbf x})\)。那麼給定 \(\tilde{\mathbf x}\) 時 \(\bm\eta\) 的後驗是
$$p(\bm\eta\mid\tilde{\mathbf x})\ \propto\ \exp\big(\bm\eta^\top\tilde{\mathbf x}-\psi(\bm\eta)-\lambda(\tilde{\mathbf x})\big)\,p(\bm\eta),$$這表示:把它看成 \(\tilde{\mathbf x}\) 的函數,後驗具有指數族的形式,自然參數是 \(\tilde{\mathbf x}\)、充分統計量是 \(\bm\eta\)、log-partition 是 \(\lambda(\tilde{\mathbf x})\)。
\(\lambda\) 的導數產生後驗 cumulant。這裡有兩條簡單的規則。第一是正規化:對每個 \(\tilde{\mathbf x}\),
$$\int\exp\big(\bm\eta^\top\tilde{\mathbf x}-\psi(\bm\eta)-\lambda(\tilde{\mathbf x})\big)\,p(\bm\eta)\,d\bm\eta=1.$$對 \(\tilde{\mathbf x}\) 微分這個恆等式,會從指數裡帶下 \(\bm\eta\) 的冪次和 \(\lambda(\tilde{\mathbf x})\) 的導數;令結果為 0,就得到 \(\lambda\) 的導數和 \(\bm\eta\) 後驗動差之間的等式。第二是指數族的標準性質:log-partition 是充分統計量的 cumulant 生成函數。因此
$$\nabla_{\tilde{\mathbf x}}\lambda(\tilde{\mathbf x})=\mathbb E[\bm\eta\mid\tilde{\mathbf x}],\qquad\nabla^2_{\tilde{\mathbf x}}\lambda(\tilde{\mathbf x})=\operatorname{Cov}[\bm\eta\mid\tilde{\mathbf x}],\qquad\nabla^{(k)}_{\tilde{\mathbf x}}\lambda(\tilde{\mathbf x})=\kappa_k(\bm\eta\mid\tilde{\mathbf x})\quad(k\ge3),$$其中 \(\kappa_k\) 是給定 \(\tilde{\mathbf x}\) 時隨機向量 \(\bm\eta\) 的 \(k\) 階條件 cumulant,由標準的動差與 cumulant 關係得到。這些就是高階 Tweedie 公式。特化到 \(\bm\eta=\mathbf x/\sigma^2\) 的高斯位置模型,就得到熟悉的、用 \(\log p_\sigma(\tilde{\mathbf x})\) 的導數表示的形式:
$$\mathbb E[\mathbf x\mid\tilde{\mathbf x}]=\tilde{\mathbf x}+\sigma^2\nabla_{\tilde{\mathbf x}}\log p_\sigma(\tilde{\mathbf x}),\qquad\operatorname{Cov}[\mathbf x\mid\tilde{\mathbf x}]=\sigma^2\mathbf I+\sigma^4\nabla^2_{\tilde{\mathbf x}}\log p_\sigma(\tilde{\mathbf x}),$$更高階的 cumulant 則對應 \(\log p_\sigma(\tilde{\mathbf x})\) 更高階的導數。
特化到高斯:從 \(\lambda\) 的導數到上面兩式
高斯時 \(\log q_0(\tilde{\mathbf x})=-\frac{\Vert\tilde{\mathbf x}\Vert^2}{2\sigma^2}+\text{常數}\),所以 \(\lambda=\log p_\sigma+\frac{\Vert\tilde{\mathbf x}\Vert^2}{2\sigma^2}+\text{常數}\)。
一階:\(\nabla\lambda=\nabla\log p_\sigma+\tilde{\mathbf x}/\sigma^2=\mathbb E[\bm\eta\mid\tilde{\mathbf x}]=\mathbb E[\mathbf x\mid\tilde{\mathbf x}]/\sigma^2\),乘 \(\sigma^2\) 就是 Tweedie。
二階:\(\nabla^2\lambda=\nabla^2\log p_\sigma+\mathbf I/\sigma^2=\operatorname{Cov}[\bm\eta\mid\tilde{\mathbf x}]=\operatorname{Cov}[\mathbf x\mid\tilde{\mathbf x}]/\sigma^4\),乘 \(\sigma^4\) 得 \(\operatorname{Cov}[\mathbf x\mid\tilde{\mathbf x}]=\sigma^2\mathbf I+\sigma^4\nabla^2\log p_\sigma\)。
直覺:後驗變異數由 \(\sigma^2\)(雜訊本身)減去一個由 log 密度曲率決定的量。在峰的中心,\(\log p_\sigma\) 往下彎(\(\nabla^2\) 負),後驗比 \(\sigma^2\) 窄;在兩峰之間,\(\log p_\sigma\) 往上彎,後驗可能比 \(\sigma^2\) 寬得多,因為不確定乾淨資料來自哪一個峰。
有幾篇研究訓練神經網路來估計高階 score(Meng et al. 2021;Lu et al. 2022;Lai et al. 2023)。書的目的是說清楚它們和統計量的關係,方法細節請讀者參考這些論文。
05(選讀)為什麼 DSM 就是去雜訊:SURE書 §3.3.5
SURE(Stein 的不偏風險估計)
大致來說,Stein's Unbiased Risk Estimator(SURE)是一種技術,可以在不知道乾淨訊號的情況下估計去雜訊器 \(\mathbf D\) 的均方誤差(MSE)。換句話說,SURE 讓我們在只有帶雜訊資料時也能挑選或訓練去雜訊器。
為了清楚,考慮加性高斯雜訊 \(\tilde{\mathbf x}=\mathbf x+\sigma\boldsymbol\epsilon\),\(\boldsymbol\epsilon\sim\mathcal N(\mathbf 0,\mathbf I)\),\(\mathbf x\in\mathbb R^D\) 是未知的乾淨訊號,\(\tilde{\mathbf x}\) 是觀測到的帶雜訊版本。去雜訊器是任何(弱可微的)映射 \(\mathbf D:\mathbb R^D\to\mathbb R^D\),產生 \(\mathbf x\) 的估計 \(\mathbf D(\tilde{\mathbf x})\)。自然的品質指標是條件 MSE
$$R(\mathbf D;\mathbf x):=\mathbb E_{\tilde{\mathbf x}\mid\mathbf x}\big[\Vert\mathbf D(\tilde{\mathbf x})-\mathbf x\Vert_2^2\,\big|\,\mathbf x\big].$$它依賴未知的真值 \(\mathbf x\),所以不能直接算。但 Stein 恆等式給出下面這個可觀測的替代量:
\(\nabla_{\tilde{\mathbf x}}\cdot\mathbf D(\tilde{\mathbf x})\) 是 \(\mathbf D\) 的散度。書強調 \(\mathrm{SURE}(\mathbf D;\tilde{\mathbf x})\) 只需要帶雜訊的觀測 \(\tilde{\mathbf x}\),不需要乾淨的 \(\mathbf x\)。(注意這裡的 \(D\) 是維度,\(\mathbf D\) 是去雜訊器。)
直覺上,SURE 由兩個互補的部分組成。\(\Vert\mathbf D(\tilde{\mathbf x})-\tilde{\mathbf x}\Vert^2\) 量的是去雜訊器的輸出離帶雜訊的輸入有多遠;單看這一項會低估真正的誤差,因為 \(\tilde{\mathbf x}\) 本身已經被破壞。散度項是修正:它捕捉去雜訊器對輸入的小擾動有多敏感,等於把雜訊帶來的變異數算進去。
重要的是,對任何固定但未知的 \(\mathbf x\),
$$\mathbb E_{\tilde{\mathbf x}\mid\mathbf x}\big[\mathrm{SURE}(\mathbf D;\mathbf x+\sigma\boldsymbol\epsilon)\,\big|\,\mathbf x\big]=R(\mathbf D;\mathbf x),$$期望是對高斯雜訊 \(\boldsymbol\epsilon\sim\mathcal N(\mathbf 0,\mathbf I)\) 取的。所以最小化 SURE(期望的或經驗的)等價於最小化真正的 MSE,卻只依賴帶雜訊的資料。實務上,對 \(\mathbf x\sim p_{\text{data}}\) 和破壞雜訊 \(\boldsymbol\epsilon\) 同時平均 SURE,就得到全域 MSE 風險的不偏估計。
證明:Stein 恆等式與 SURE 的推導(書的附錄 D.2)
一維 Stein 恆等式。若 \(z\sim\mathcal N(0,1)\)、\(f\) 衰減得夠快,則 \(\mathbb E[f'(z)]=\mathbb E[zf(z)]\)。證明:令 \(\varphi(z)=\frac1{\sqrt{2\pi}}e^{-z^2/2}\),它滿足 \(\varphi'(z)=-z\varphi(z)\)。分部積分
$$\int f'(z)\varphi(z)\,dz=\big[f(z)\varphi(z)\big]_{-\infty}^{\infty}-\int f(z)\varphi'(z)\,dz=0+\int f(z)\,z\,\varphi(z)\,dz.$$多維。若 \(\mathbf z\sim\mathcal N(\mathbf 0,\mathbf I_D)\),對 \(g:\mathbb R^D\to\mathbb R\) 有 \(\mathbb E[\nabla g(\mathbf z)]=\mathbb E[\mathbf zg(\mathbf z)]\);等價地,對 \(\mathbf u:\mathbb R^D\to\mathbb R^D\),\(\mathbb E[\nabla_{\mathbf z}\cdot\mathbf u(\mathbf z)]=\mathbb E[\mathbf z^\top\mathbf u(\mathbf z)]\)(每個座標各用一次一維的結果)。
SURE 需要的形式。\(\tilde{\mathbf x}=\mathbf x+\sigma\mathbf z\),對任何夠正則的向量函數 \(\mathbf a\):
$$\mathbb E\big[(\tilde{\mathbf x}-\mathbf x)^\top\mathbf a(\tilde{\mathbf x})\,\big|\,\mathbf x\big]=\sigma^2\,\mathbb E\big[\nabla_{\tilde{\mathbf x}}\cdot\mathbf a(\tilde{\mathbf x})\,\big|\,\mathbf x\big].$$(左邊是 \(\sigma\mathbb E[\mathbf z^\top\mathbf a(\mathbf x+\sigma\mathbf z)]=\sigma\mathbb E[\nabla_{\mathbf z}\cdot\mathbf a(\mathbf x+\sigma\mathbf z)]\),連鎖律 \(\nabla_{\mathbf z}=\sigma\nabla_{\tilde{\mathbf x}}\) 再多一個 \(\sigma\)。)
從條件 MSE 推出 SURE。在 \(\tilde{\mathbf x}\) 附近展開:\(\mathbf D-\mathbf x=(\mathbf D-\tilde{\mathbf x})+(\tilde{\mathbf x}-\mathbf x)\),
$$R=\mathbb E\Vert\mathbf D-\tilde{\mathbf x}\Vert^2+2\Big(\underbrace{\mathbb E[(\tilde{\mathbf x}-\mathbf x)^\top\mathbf D(\tilde{\mathbf x})]}_{\sigma^2\mathbb E[\nabla\cdot\mathbf D]}-\underbrace{\mathbb E[(\tilde{\mathbf x}-\mathbf x)^\top\tilde{\mathbf x}]}_{\sigma^2D}\Big)+\underbrace{\mathbb E\Vert\tilde{\mathbf x}-\mathbf x\Vert^2}_{\sigma^2D}=\mathbb E\big[\Vert\mathbf D-\tilde{\mathbf x}\Vert^2+2\sigma^2\nabla\cdot\mathbf D-D\sigma^2\,\big|\,\mathbf x\big].$$(中間第二個底括號:\(\mathbb E[\sigma\mathbf z^\top(\mathbf x+\sigma\mathbf z)]=\sigma^2\mathbb E\Vert\mathbf z\Vert^2=\sigma^2D\)。)期望裡的東西就是 SURE。
和 Tweedie 公式、Bayes 最佳性的關係
令 \(p_\sigma(\tilde{\mathbf x})=\big(p_{\text{data}}*\mathcal N(\mathbf 0,\sigma^2\mathbf I)\big)(\tilde{\mathbf x})\) 是這一節的帶雜訊邊際。SURE 是條件於 \(\mathbf x\)、對雜訊取期望的 MSE 的不偏估計:
$$\mathbb E_{\tilde{\mathbf x}\mid\mathbf x}\big[\mathrm{SURE}(\mathbf D;\tilde{\mathbf x})\big]=\mathbb E_{\tilde{\mathbf x}\mid\mathbf x}\big[\Vert\mathbf D(\tilde{\mathbf x})-\mathbf x\Vert^2\big].$$因此最小化期望的 SURE 等於最小化 Bayes 風險 \(\mathbb E_{(\mathbf x,\tilde{\mathbf x})}\big[\Vert\mathbf D(\tilde{\mathbf x})-\mathbf x\Vert^2\big]=\mathbb E_{\tilde{\mathbf x}}\big[\mathbb E_{\mathbf x\mid\tilde{\mathbf x}}\Vert\mathbf D(\tilde{\mathbf x})-\mathbf x\Vert^2\big]\)(全期望定律)。這個分解導出逐點的最佳化:對幾乎所有 \(\tilde{\mathbf x}\),
$$\mathbf D^*(\tilde{\mathbf x})=\arg\min_{\mathbf z}\ \mathbb E_{\mathbf x\mid\tilde{\mathbf x}}\big[\Vert\mathbf z-\mathbf x\Vert^2\big]=\mathbb E[\mathbf x\mid\tilde{\mathbf x}].$$所以 SURE 的最佳去雜訊器就是第 4 節的 Bayes 估計量,再由 Tweedie 恆等式:
$$\mathbf D^*(\tilde{\mathbf x})=\mathbb E[\mathbf x\mid\tilde{\mathbf x}]=\tilde{\mathbf x}+\sigma^2\nabla_{\tilde{\mathbf x}}\log p_\sigma(\tilde{\mathbf x}).$$SURE 和 score matching 的關係
上式啟發我們用一個 score 場來參數化去雜訊器:
$$\mathbf D(\tilde{\mathbf x})=\tilde{\mathbf x}+\sigma^2\mathbf s_{\bm\phi}(\tilde{\mathbf x},\sigma),$$\(\mathbf s_{\bm\phi}(\cdot,\sigma)\) 用來近似帶雜訊的 score \(\nabla_{\tilde{\mathbf x}}\log p_\sigma(\cdot)\)。把它代入 SURE 得到
$$\frac1{2\sigma^4}\,\mathrm{SURE}(\mathbf D;\tilde{\mathbf x})=\operatorname{Tr}\big(\nabla_{\tilde{\mathbf x}}\mathbf s_{\bm\phi}(\tilde{\mathbf x},\sigma)\big)+\tfrac12\Vert\mathbf s_{\bm\phi}(\tilde{\mathbf x},\sigma)\Vert_2^2+\text{const}(\sigma).$$代入的計算
\(\mathbf D-\tilde{\mathbf x}=\sigma^2\mathbf s_{\bm\phi}\),所以第一項是 \(\sigma^4\Vert\mathbf s_{\bm\phi}\Vert^2\)。散度:\(\nabla\cdot\mathbf D=D+\sigma^2\operatorname{Tr}(\nabla\mathbf s_{\bm\phi})\),第二項是 \(2\sigma^2D+2\sigma^4\operatorname{Tr}(\nabla\mathbf s_{\bm\phi})\)。合起來
$$\mathrm{SURE}=\sigma^4\Vert\mathbf s_{\bm\phi}\Vert^2+2\sigma^4\operatorname{Tr}(\nabla\mathbf s_{\bm\phi})+D\sigma^2,$$除以 \(2\sigma^4\):\(\operatorname{Tr}(\nabla\mathbf s_{\bm\phi})+\tfrac12\Vert\mathbf s_{\bm\phi}\Vert^2+\frac{D}{2\sigma^2}\),常數是 \(\frac{D}{2\sigma^2}\)。
所以對 \(\tilde{\mathbf x}\sim p_\sigma\) 取期望後,最小化 SURE 等價於(差一個加性常數)在雜訊等級 \(\sigma\)、期望對 \(p_\sigma\) 取的 Hyvärinen 替代 score matching 目標(B05 的 \(\widetilde{\mathcal L}_{\text{SM}}\))。因此兩個目標有相同的最小化解,就是上面的去雜訊器 \(\mathbf D^*\)。
三條路通到同一個答案
到這裡,至少有三個目標在雜訊等級 \(\sigma\) 有相同的最佳解:對 \(p_\sigma\) 做 Hyvärinen 的 score matching、DSM、以及用 score 參數化的 SURE。前兩者只差常數(第 2 節的定理加上 B05 的命題),後兩者也只差常數(這一節)。它們用的資訊不同:DSM 需要知道乾淨的 \(\mathbf x\)(訓練時自己加雜訊,所以知道),SURE 和 Hyvärinen 只需要帶雜訊的 \(\tilde{\mathbf x}\),代價是要算散度。
Demo CSURE 與真正的誤差轉述者補充
同樣的三峰資料。考慮一族去雜訊器 \(\mathbf D_a(\tilde{\mathbf x})=\tilde{\mathbf x}+a\,\sigma^2\nabla\log p_\sigma(\tilde{\mathbf x})\):\(a=0\) 是什麼都不做,\(a=1\) 是 Tweedie。抽 4,000 對 \((\mathbf x,\tilde{\mathbf x})\),對每個 \(a\) 算兩條曲線:真正的 MSE(要用到乾淨的 \(\mathbf x\)),以及平均的 SURE(只用 \(\tilde{\mathbf x}\);散度 \(\mathbf D_a'\) 用 score 的導數解析算出)。
瀏覽器實測:
- 兩條曲線幾乎重合:\(\sigma=0.5\) 時,\(a=1\) 的真正 MSE 是 0.1420、平均 SURE 是 0.1462;\(\sigma=0.2\) 時是 0.0083 對 0.0092。差距來自只有 4,000 個樣本(SURE 是不偏的,但單一樣本的值有雜訊)。
- 最小值都在 \(a\approx1\):真正的 MSE 在 \(\sigma=0.2,0.5,1.0\) 時都在 \(a=1.00\) 最小;SURE 在 \(\sigma=0.2\) 時也在 1.00,\(\sigma=0.5\)、1.0 時在 0.95(格點間距 0.05)。只看帶雜訊的資料,就找得到 Tweedie 的去雜訊器。
- \(a=0\) 的 SURE 恰好是 \(\sigma^2\):\(\mathbf D=\tilde{\mathbf x}\) 時第一項為 0、散度是 1,SURE \(=2\sigma^2-\sigma^2=\sigma^2\),沒有任何隨機性;真正的 MSE 則是 \(\sigma^2\) 加上抽樣誤差(\(\sigma=0.5\) 時 0.2560 對 0.2500)。
06(選讀)Generalized score matching書 §3.3.6
動機
古典 score matching、denoising score matching 和高階的變體,目標都是某個密度 \(p\) 的
$$\frac{\mathcal Lp(\mathbf x)}{p(\mathbf x)},$$其中 \(\mathcal L\) 是作用在密度上的線性算子。古典情況 \(\mathcal L=\nabla_{\mathbf x}\) 給出 \(\nabla_{\mathbf x}\log p(\mathbf x)=\frac{\nabla_{\mathbf x}p(\mathbf x)}{p(\mathbf x)}\)。\(\frac{\mathcal Lp}{p}\) 這個結構讓分部積分能消掉正規化常數,得到只依賴 \(p\) 的樣本和學到的場 \(\mathbf s_{\bm\phi}\) 的好處理目標。這個觀點啟發了 generalized score matching 的框架。
Generalized Fisher divergence
令 \(p\) 是資料分佈,\(q\) 是任何模型分佈。對作用在 \(\mathbf x\) 的純量函數上的線性算子 \(\mathcal L\),定義 generalized Fisher divergence
$$\mathcal D_{\mathcal L}(p\,\Vert\,q):=\int p(\mathbf x)\left\Vert\frac{\mathcal Lp(\mathbf x)}{p(\mathbf x)}-\frac{\mathcal Lq(\mathbf x)}{q(\mathbf x)}\right\Vert_2^2d\mathbf x.$$如果 \(\mathcal L\) 是完備的(complete),也就是 \(\frac{\mathcal Lp_1}{p_1}=\frac{\mathcal Lp_2}{p_2}\) 幾乎處處成立就推得 \(p_1=p_2\) 幾乎處處成立,那麼 \(\mathcal D_{\mathcal L}(p\Vert q)=0\) 就確定 \(q=p\)。\(\mathcal L=\nabla\) 時,這就是古典的 Fisher divergence(B01)。
用 score 參數化
實務上我們不建模正規化的密度 \(q\),而是直接參數化一個向量場 \(\mathbf s_{\bm\phi}(\mathbf x)\) 來近似廣義的 score \(\frac{\mathcal Lp(\mathbf x)}{p(\mathbf x)}\)。考慮
$$\mathcal D_{\mathcal L}(p\,\Vert\,\mathbf s_{\bm\phi}):=\mathbb E_{\mathbf x\sim p}\left[\left\Vert\mathbf s_{\bm\phi}(\mathbf x)-\frac{\mathcal Lp(\mathbf x)}{p(\mathbf x)}\right\Vert_2^2\right].$$雖然 \(\frac{\mathcal Lp}{p}\) 未知,「分部積分」讓損失只依賴 \(\mathbf s_{\bm\phi}\)。令 \(\mathcal L^\dagger\) 是 \(\mathcal L\) 的伴隨算子(adjoint),定義為
$$\int(\mathcal Lf)^\top g=\int f\,(\mathcal L^\dagger g)\qquad\text{對所有測試函數 }f,g,$$在邊界項消失時,它形式上把 \(\mathcal L\)「搬」到積分的另一邊。展開平方、套用這個恆等式,得到好處理的目標
$$\mathcal L_{\text{GSM}}(\bm\phi)=\mathbb E_{\mathbf x\sim p}\Big[\tfrac12\Vert\mathbf s_{\bm\phi}(\mathbf x)\Vert_2^2-\big(\mathcal L^\dagger\mathbf s_{\bm\phi}\big)(\mathbf x)\Big]+\text{const},$$常數和 \(\bm\phi\) 無關。\(p\) 只透過期望出現,所以 generalized score matching 損失可以和古典 score matching 一樣,從訓練資料做經驗估計。\(\mathcal L=\nabla\) 時 \(\mathcal L^\dagger=-\nabla\cdot\),就回到 Hyvärinen 的目標 \(\mathbb E_p\big[\tfrac12\Vert\mathbf s_{\bm\phi}\Vert_2^2+\nabla\cdot\mathbf s_{\bm\phi}\big]\)(B05)。
展開的步驟
(第二步 \(p\) 消掉,第三步用伴隨的定義、取 \(f=p\)、\(g=\mathbf s_{\bm\phi}\)。)這是 \(2\mathcal L_{\text{GSM}}\) 加常數;乘上 \(\tfrac12\) 不改變最佳解。\(\mathcal L=\nabla\) 的伴隨:分部積分 \(\int(\nabla f)^\top\mathbf g=-\int f\,\nabla\cdot\mathbf g\),所以 \(\mathcal L^\dagger=-\nabla\cdot\)。
算子的例子
- 古典 score matching。\(\mathcal L=\nabla_{\mathbf x}\),廣義 score 就是 \(\frac{\mathcal Lp}{p}=\nabla_{\mathbf x}\log p(\mathbf x)\)。
- Denoising score matching。對加性高斯雜訊,定義算子 \((\mathcal Lf)(\tilde{\mathbf x})=\tilde{\mathbf x}\,f(\tilde{\mathbf x})+\sigma^2\nabla_{\tilde{\mathbf x}}f(\tilde{\mathbf x})\)。那麼 $$\frac{\mathcal Lp_\sigma(\tilde{\mathbf x})}{p_\sigma(\tilde{\mathbf x})}=\tilde{\mathbf x}+\sigma^2\nabla_{\tilde{\mathbf x}}\log p_\sigma(\tilde{\mathbf x})=\mathbb E[\mathbf x_0\mid\tilde{\mathbf x}],\qquad p_\sigma(\tilde{\mathbf x}):=\int\mathcal N(\tilde{\mathbf x};\mathbf x_0,\sigma^2\mathbf I)\,p_{\text{data}}(\mathbf x_0)\,d\mathbf x_0,\quad\tilde{\mathbf x}=\mathbf x_0+\sigma\boldsymbol\epsilon.$$ 這正是加性高斯雜訊的 Tweedie 恆等式。用這個算子最小化 \(\mathcal L_{\text{GSM}}\),就是訓練 \(\mathbf s_{\bm\phi}\) 去近似後驗平均的去雜訊器。如果改用縮放過的高斯位置模型 \(\tilde{\mathbf x}=\alpha\mathbf x_0+\sigma\boldsymbol\epsilon\),對應的恆等式會像第 4 節的 Tweedie 一樣多一個 \(\alpha\)。
- 高階目標。在 \(\mathcal L\) 裡疊上更多導數,會露出 \(\nabla^2\log p\) 和更高階的導數,對應後驗共變異數和更高階的 cumulant。
DSM 算子的伴隨與損失長什麼樣
\(\int(\tilde{\mathbf x}f+\sigma^2\nabla f)^\top\mathbf g=\int f\,(\tilde{\mathbf x}^\top\mathbf g-\sigma^2\nabla\cdot\mathbf g)\),所以 \(\mathcal L^\dagger\mathbf g=\tilde{\mathbf x}^\top\mathbf g-\sigma^2\nabla\cdot\mathbf g\),損失是
$$\mathcal L_{\text{GSM}}=\mathbb E_{p_\sigma}\Big[\tfrac12\Vert\mathbf s_{\bm\phi}\Vert^2-\tilde{\mathbf x}^\top\mathbf s_{\bm\phi}+\sigma^2\nabla\cdot\mathbf s_{\bm\phi}\Big]=\mathbb E_{p_\sigma}\Big[\tfrac12\Vert\mathbf s_{\bm\phi}-\tilde{\mathbf x}\Vert^2+\sigma^2\nabla\cdot\mathbf s_{\bm\phi}\Big]+\text{const}.$$令 \(\mathbf s_{\bm\phi}=\mathbf D\)(這裡的 \(\mathbf s_{\bm\phi}\) 直接輸出去雜訊結果),這正是 \(\tfrac12\mathbb E[\mathrm{SURE}(\mathbf D)]\) 加常數:generalized score matching 把 SURE 也收進同一個框架。
延伸與應用
Generalized score matching 可以延伸到連續變數以外的離散情境,包括語言建模(Meng et al. 2022;Lou et al. 2024,後者就是 CS236 第 18 講的 SEDD)。它也啟發了 score 風格、產生去雜訊式目標的訓練方法。這個算子觀點統一了一系列目標,允許從資料做經驗估計,並提供了「選擇適當的 \(\mathcal L\) 來設計損失函數」的一般原則。