DEIS 與 DPM-Solver:不再把神經預測當常數,用過去或這一步內的計算去逼近它的變化
DDIM 把雜訊預測在整步上當成常數。要更準,就得知道它怎麼變。兩個方法各取一條古典數值分析的路:DEIS 像 Adams–Bashforth,重用前幾步已經算好的預測,畫一條 Lagrange 多項式往下一步外插,不多花任何模型計算;DPM-Solver 像 Runge–Kutta,先把時間換成 half-log SNR \(\lambda=\log(\alpha/\sigma)\),讓 PF-ODE 的精確解變成一個指數加權的積分,再在這一步內多算一兩次模型,估出預測的 Taylor 係數。兩者都保留已知的時程部分精確積分,只對神經預測做近似;兩者的最低階情形都恰好是 DDIM。
讀完這頁你應該能夠
- 寫出 Lagrange 插值多項式和它的基本性質,並說明它怎麼當成外插使用。
- 推出 AB-DEIS-\(n\) 更新,包括係數 \(C_{i,j}\)、暖啟動,以及為什麼 \(n=0\) 就是 DDIM。
- 把 PF-ODE 改寫成 \(\lambda\) 時間,推出指數加權的精確解,並說明均勻的 \(\lambda\) 格點會把步長放在哪裡。
- 由 Taylor 展開推出 DPM-Solver-\(n\) 的 \(\varphi\) 函數形式和 DPM-Solver-2 演算法,並說明它和一般 RK2、指數 RK2 的差別。
前置知識
- B24:雜訊形式的變數常數變易精確解、分解式指數積分器、single-step 與 multistep 的分類。
- B25:DDIM 的更新、\(\rho=\sigma/\alpha\) 座標、DDIM 和 Euler/指數 Euler 的比較。這一頁的每個方法都和它比。
- Taylor 展開、Runge–Kutta 和 Adams–Bashforth 的想法:補充課 B;B24 第 2 節的補充框有 AB2 的公式。
「書 §」標出原文位置。灰框「轉述者補充」是書裡沒有的內容;藍框「推導」展開書中省略的步驟。
01DEIS:從過去的預測外插書 §9.3 開頭
在分解式指數積分器的式子(B24)裡,
$$\int_s^t\frac{g^2(\tau)}{2\sigma_\tau}\,\mathcal E(\tau\to t)\,\bm\epsilon_{\bm\phi^\times}(\mathbf x_\tau,\tau)\,d\tau,$$所有依賴時程的因子都是已知的;沿軌跡唯一未知的是神經預測 \(\bm\epsilon_{\bm\phi^\times}(\mathbf x_\tau,\tau)\)。DDIM 做最簡單的一階近似,把它固定在這一步開頭的值:\(\bm\epsilon_{\bm\phi^\times}(\mathbf x_\tau,\tau)\approx\bm\epsilon_{\bm\phi^\times}(\mathbf x_s,s)\),\(\tau\in[t,s]\)。神經預測沿軌跡變化明顯時,這在大步上會變得不準。
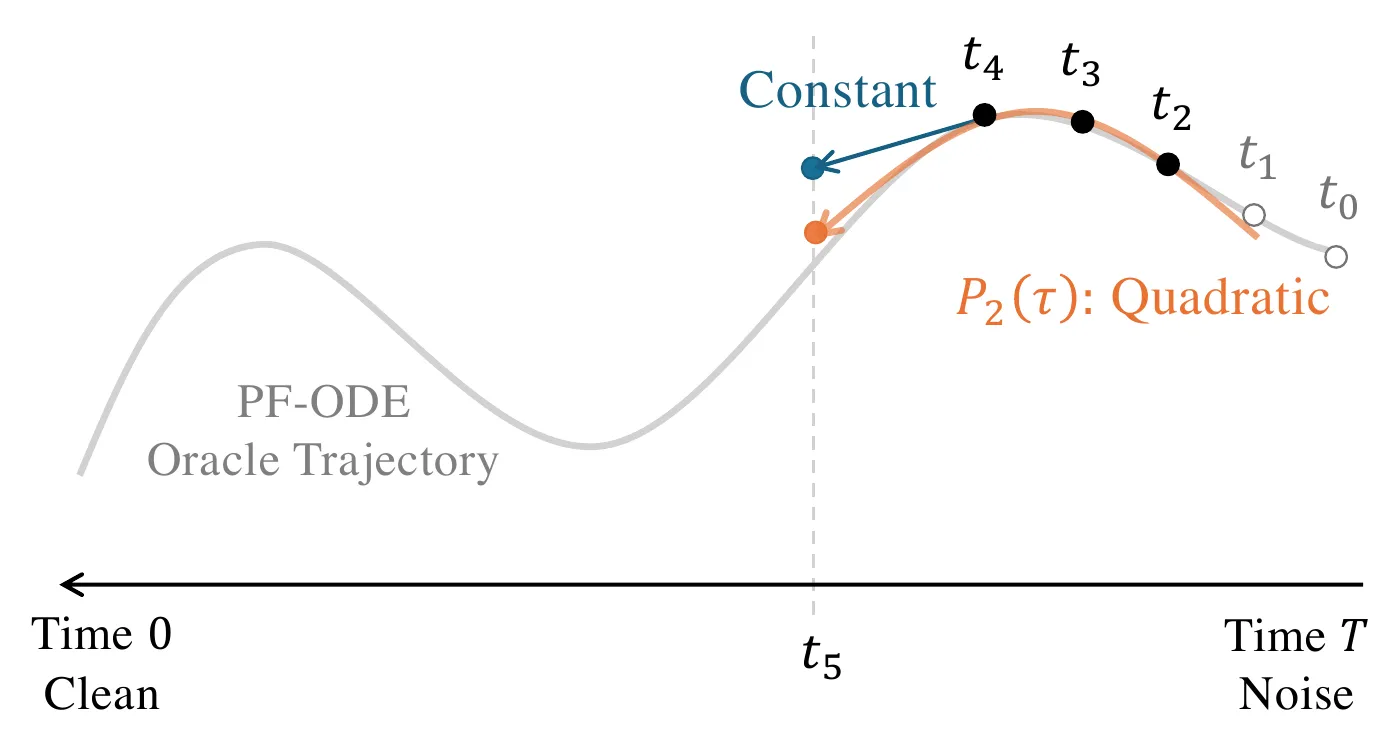
DEIS(Zhang & Chen 2022)在不增加這一步內的模型計算的前提下改進這個想法。它受 Adams–Bashforth 之類古典 multistep 方法啟發,把前幾步已完成的模型預測當成錨點(anchors),擬合一條多項式,把它們最近的變化外插到下一步。這條多項式取代積分裡未知的神經預測,而已知的、依賴時程的權重 \(\frac{g^2(\tau)}{2\sigma_\tau}\mathcal E(\tau\to t)\) 則解析地保留。所以 DEIS 把 DDIM 的常數近似,延伸成高階的 multistep 多項式近似。
從古典數值的觀點,DEIS 因此是分解式指數積分器框架裡的 Adams–Bashforth 型 multistep 方法:前幾步的神經計算提供高階資訊,已知的 diffusion 動態則保留在加權積分裡。書先回顧多項式外插(第 2 節),再推導 DEIS 更新,最後說明常數(零次)情形還原 DDIM(第 3 節)。
02背景:多項式外插書 §9.3.1
想法很簡單:先讓一條多項式通過幾個已知的值,再在最近的錨點之外計算這條多項式,預測這個量可能怎麼繼續變。所以這條多項式在已知的錨點上是插值(interpolant),在下一個解法步上則當成外插(extrapolant)。
假設一個隨時間變化的量在 \(n+1\) 個相異時刻已知:\((\tau_0,\mathbf Y_0),(\tau_1,\mathbf Y_1),\dots,(\tau_n,\mathbf Y_n)\),\(\tau_0\lt\tau_1\lt\cdots\lt\tau_n\),每個 \(\mathbf Y_j\) 可以是向量。我們想建構一條恰好吻合這些觀察值、又能延續到最近錨點之外的最簡單平滑曲線。通過所有錨點、次數至多 \(n\) 的唯一多項式是 Lagrange 插值多項式:
\(\ell_j\) 的構造很簡單:每個因子讓它在某個其他錨點為 0,分母則把它在 \(\tau_j\) 的值正規化成 1。所以 \(\ell_j(\tau_k)=\delta_{jk}\),因此 \(P_n(\tau_j)=\mathbf Y_j\)(\(j=0,\dots,n\))。此外 \(\sum_{j=0}^n\ell_j(\tau)=1\)。
唯一性,以及 \(\sum_j\ell_j\equiv1\)
唯一。如果兩條次數 \(\le n\) 的多項式都通過這 \(n+1\) 個點,它們的差是次數 \(\le n\) 的多項式,卻有 \(n+1\) 個根,只能恆為 0。
權重和為 1。把所有 \(\mathbf Y_j\) 都取成 1:常數函數 1 是一條通過所有點的零次多項式,由唯一性 \(P_n\equiv1\),也就是 \(\sum_j\ell_j(\tau)=1\) 對每個 \(\tau\) 都成立(包括錨點之外)。這表示 \(P_n(\tau)\) 是錨點的加權組合,權重加起來是 1;但在錨點範圍之外,權重可以是負的、絕對值可以大於 1,這就是外插對誤差敏感的原因。
所以 \(P_n(\tau)\) 是觀察到的錨點的、隨時間變化的線性組合:在每個錨點恰好重現對應的值;在錨點之間或之外,多項式把它們組合起來描述它們的變化所暗示的局部趨勢。DEIS 會在最近的錨點之外用同一條曲線,把插值變成下一步的外插。最低階的情形:
- \(n=0\)(常數):一個錨點,多項式就是保持最近的值:\(P_0(\tau)=\mathbf Y_0\)。
- \(n=1\)(線性):兩個錨點,連接它們的直線:\(P_1(\tau)=\frac{\tau-\tau_1}{\tau_0-\tau_1}\mathbf Y_0+\frac{\tau-\tau_0}{\tau_1-\tau_0}\mathbf Y_1\)。
- \(n=2\)(二次):三個錨點,\(P_2(\tau)=\ell_0(\tau)\mathbf Y_0+\ell_1(\tau)\mathbf Y_1+\ell_2(\tau)\mathbf Y_2\),還能捕捉觀察值的局部彎曲。
在 DEIS 裡,錨點是前幾步已完成的取樣步的神經預測。多項式恰好吻合這些存下的預測,再在最近的錨點之外、在下一個反向時間區間上外插。
03DEIS 更新,以及 DDIM = AB-DEIS-0書 §9.3.2–9.3.3
令 \(n\ge0\) 是選定的多項式次數。在第 \(i\) 步,DEIS 用一條由過去的模型輸出建構的 \(n\) 次 Lagrange 多項式,近似未知的映射 \(\tau\mapsto\bm\epsilon_{\bm\phi^\times}(\mathbf x_\tau,\tau)\) 在下一個反向區間 \([t_i,t_{i-1}]\) 上的樣子,再把多項式代入指數積分器的更新,得到 \(\tilde{\mathbf x}_{t_i}\)。直覺是:不像 DDIM 那樣把神經預測當常數,而是用它最近的歷史捕捉它隨時間怎麼變。
\(n\) 次的更新需要 \(n+1\) 個錨點。錨點足夠時(歷史足夠,\(i\ge n+1\))用完整的 \(n\) 次格式;最初幾步(歷史不足,\(i\le n\))用可行的最高次數 \(i-1\),隨著錨點增加而提高。
情形 I:\(i=n+1,\dots,M\)(歷史足夠)
DEIS 重用最近 \(n+1\) 次模型計算當錨點:\((\tau_j,\mathbf Y_j):=\big(t_{i-1-j},\bm\epsilon_{\bm\phi^\times}(\tilde{\mathbf x}_{t_{i-1-j}},t_{i-1-j})\big)\),\(j=0,\dots,n\)。把 \(\tau\mapsto\bm\epsilon_{\bm\phi^\times}(\mathbf x_\tau,\tau)\) 看成沿軌跡的平滑函數,建構 \(n\) 次 Lagrange 多項式
$$P_n(\tau)=\sum_{j=0}^n\underbrace{\Big[\prod_{\substack{k=0\\k\ne j}}^n\frac{\tau-t_{i-1-k}}{t_{i-1-j}-t_{i-1-k}}\Big]}_{=:\ell_j^{(i)}(\tau)}\bm\epsilon_{\bm\phi^\times}\big(\tilde{\mathbf x}_{t_{i-1-j}},t_{i-1-j}\big),$$依構造在每個錨點 \(P_n(\tau_j)=\mathbf Y_j\),每個 \(\ell_j^{(i)}\) 在 \(t_{i-1-m}\) 的值是 \(\delta_{mj}\)。多項式接著在最近的錨點 \(t_{i-1}\) 之外、在新的一步上外插:\(\bm\epsilon_{\bm\phi^\times}(\mathbf x_\tau,\tau)\approx P_n(\tau)\),\(\tau\in[t_i,t_{i-1}]\)。把 \(P_n\) 代入指數積分器的式子:
$$\int_{t_{i-1}}^{t_i}\frac{g^2(\tau)}{2\sigma_\tau}\mathcal E(\tau\to t_i)\,\bm\epsilon_{\bm\phi^\times}(\mathbf x_\tau,\tau)\,d\tau\approx\sum_{j=0}^n\underbrace{\int_{t_{i-1}}^{t_i}\frac{g^2(\tau)}{2\sigma_\tau}\mathcal E(\tau\to t_i)\,\ell_j^{(i)}(\tau)\,d\tau}_{=:C_{i,j}}\cdot\bm\epsilon_{\bm\phi^\times}(\tilde{\mathbf x}_{t_{i-1-j}},t_{i-1-j}).$$係數 \(C_{i,j}\) 只依賴雜訊時程和選定的時間格點,可以事先算好。時程有合適的反導數時有閉式;否則可以用數值積分算到很高的精度。把線性部分用 \(\mathcal E(t_{i-1}\to t_i)\) 精確積分,得到 AB-DEIS-\(n\) 更新
$$\tilde{\mathbf x}_{t_i}=\mathcal E(t_{i-1}\to t_i)\,\tilde{\mathbf x}_{t_{i-1}}+\sum_{j=0}^nC_{i,j}\,\bm\epsilon_{\bm\phi^\times}(\tilde{\mathbf x}_{t_{i-1-j}},t_{i-1-j}).$$為了下面的局部截斷誤差,令 \(h\) 表示一個特徵局部步長,並假設相鄰步長的比值有界。在神經預測沿 empirical 軌跡的標準平滑假設、以及時程權重的正則性下,歷史足夠的 \(n\) 次建構有形式上的 \(n+1\) 階,單步局部誤差 \(\mathcal O(h^{n+2})\)。
為什麼是 \(n+1\) 階
Lagrange 插值的誤差公式:若 \(\bm\epsilon\)(沿軌跡)有 \(n+1\) 階連續導數,\(\bm\epsilon(\tau)-P_n(\tau)=\frac{\bm\epsilon^{(n+1)}(\xi)}{(n+1)!}\prod_{k=0}^n(\tau-\tau_k)\)。在下一步上,每個因子 \(|\tau-\tau_k|\) 都是 \(\mathcal O(h)\)(步長比有界時錨點離得不遠),所以被積函數的誤差是 \(\mathcal O(h^{n+1})\);再乘上長度 \(\mathcal O(h)\) 的積分區間,單步誤差是 \(\mathcal O(h^{n+2})\)。\(M\sim1/h\) 步累加起來是 \(\mathcal O(h^{n+1})\),前提是方法穩定、起始值也夠準(見下面的說明)。
情形 II:\(i=1,\dots,n\)(歷史不足)
最初幾步只有 \(i\) 個過去的模型計算可用,所以用所有可用的錨點,把多項式次數設成 \(i-1\):\(P_{i-1}(\tau)=\sum_{j=0}^{i-1}\ell_j^{(i)}(\tau)\,\bm\epsilon_{\bm\phi^\times}(\tilde{\mathbf x}_{t_{i-1-j}},t_{i-1-j})\),其中 \(\ell_j^{(i)}\) 是建在 \(\{t_{i-1},t_{i-2},\dots,t_0\}\) 上的 \(i-1\) 次 Lagrange 基底。它吻合所有可用的錨點,在 \(i\ge n+1\) 之後就接到歷史足夠的公式。這是 multistep 方法標準的暖啟動:第一步用常數近似,第二步用線性外插,第三步用二次外插,依此類推,直到可以用目標次數 \(n\)。
AB-DEIS-\(n\) 更新的總結
合併歷史足夠和暖啟動兩種情形,得到 AB-DEIS-\(n\) 更新(書的腳註:「AB」指 Adams–Bashforth 的 multistep 原理,在這裡用在指數積分器的表述裡;Hochbruck & Ostermann 2010)。\(n\) 是目標多項式次數,最多用 \(n+1\) 個過去的計算:
\(i\ge n+1\) 時 \(\min\{n,i-1\}=n\),完整歷史的 \(n\) 次步在上面的假設下有單步局部截斷誤差 \(\mathcal O(h^{n+2})\),對應 \(n+1\) 階的方法。暖啟動時(\(i\le n\))次數是 \(i-1\),單步局部誤差 \(\mathcal O(h^{i+1})\),形式上是 \(i\) 階。所以階數從第一步的 1 開始,有 \(n+1\) 個錨點之後達到完整的 \(n+1\) 階。和標準的 multistep 方法一樣,低階的暖啟動步本身不足以保證全域 \(n+1\) 階;那還需要穩定性和夠準的起始值。
非常大的 \(n\) 可能讓數值行為變差:高次外插對錨點的間距、存下的模型預測的誤差和穩定性越來越敏感。所以實務上偏好比較小的多項式次數。Demo C 在均勻 \(t\) 格點、少步數時就看得到這件事。
\(C_{i,j}\) 實際怎麼算(轉述者補充)
B25 證明了 \(\frac{g^2(\tau)}{2\sigma_\tau}\mathcal E(\tau\to t_i)=\alpha_{t_i}\frac{d}{d\tau}\big(\frac{\sigma_\tau}{\alpha_\tau}\big)\)。換成 \(\lambda\)(第 4 節):\(\sigma/\alpha=e^{-\lambda}\),所以 \(\frac{d}{d\tau}(\sigma/\alpha)\,d\tau=-e^{-\lambda}d\lambda\),
$$C_{i,j}=-\alpha_{t_i}\int_{\lambda_{t_{i-1}}}^{\lambda_{t_i}}e^{-\lambda}\,\ell_j^{(i)}\big(t_\lambda(\lambda)\big)\,d\lambda.$$這個被積函數在 \(\lambda\) 裡很平滑(原本在 \(t\to0\) 時有 \(1/\sqrt t\) 型的奇異性),Demo C 用 16 點 Gauss–Legendre 求積在 \(\lambda\) 裡算,每個格點只算一次、所有樣本共用。
DDIM = AB-DEIS-0
在 \(n=0\) 時和 DDIM 的連結立刻可見:Lagrange 多項式是常數,DEIS 在下一步全程只用最近的模型預測。對應的係數化簡成 \(C_{i0}=\frac12\int_{t_{i-1}}^{t_i}\frac{g^2(\tau)}{\sigma_\tau}\mathcal E(\tau\to t_i)\,d\tau\),代入得到零階的 AB-DEIS:
$$\begin{aligned}\tilde{\mathbf x}_{t_i}&=\mathcal E(t_{i-1}\to t_i)\tilde{\mathbf x}_{t_{i-1}}+C_{i0}\,\bm\epsilon_{\bm\phi^\times}(\tilde{\mathbf x}_{t_{i-1}},t_{i-1})\\&=e^{\int_{t_{i-1}}^{t_i}f(u)du}\,\tilde{\mathbf x}_{t_{i-1}}+\Big(\int_{t_{i-1}}^{t_i}\frac{g^2(\tau)}{2\sigma_\tau}e^{\int_\tau^{t_i}f(u)du}\,d\tau\Big)\bm\epsilon_{\bm\phi^\times}(\tilde{\mathbf x}_{t_{i-1}},t_{i-1}).\end{aligned}$$這和確定性 DDIM 用的一階分解式近似完全一樣:神經預測固定在 \(t_{i-1}\),已知的積分因子和時程係數留在積分裡、在整步上傳播。所以 AB-DEIS-0 和 DDIM 不只是一階等價,而是給出相同的有限步更新。
這也釐清了 DEIS 在解法階層裡的角色。注意索引「0」指的是多項式次數,不是數值階數:AB-DEIS-0 仍然是一階方法。更高次的 DEIS 保留同樣對已知 diffusion 動態的解析處理,但把常數預測換成來自更多過去模型計算的多項式外插。所以 DDIM 是零次的基本情形,DEIS 的 multistep 建構從它自然延伸出來。
B27 會遇到另一條通往 multistep diffusion 解法的路:DPM-Solver++(2M)。它從資料預測在 log-SNR 時間的局部 Taylor 展開出發,用後向差分重用前幾步的模型計算來估所需的導數。雖然表示和推導都和 DEIS 不同,兩個方法都用過去的模型計算捕捉神經預測的變化,不引入額外的步內階段。書在 §9.5 更明確地比較兩者。
Demo A用過去的錨點外插 ε轉述者補充
一維資料 \(0.5\,\mathcal N(-1,0.02^2)+0.5\,\mathcal N(1,0.02^2)\)(兩個很窄的峰),DDPM 式 VP 時程,精確的 \(\bm\epsilon^*\)。從 \(x_T\) 出發沿精確的 PF-ODE 軌跡走,在 \(\lambda\) 均勻的 10 個格點上記下 \(\epsilon^*\),這些就是錨點。選一步 \(i\) 和次數 \(n\):圖上畫出錨點、通過它們的 Lagrange 多項式在下一步 \([t_i,t_{i-1}]\) 上的外插,以及 \(\epsilon^*\) 在那一步上真正的樣子。readout 比較這一步的加權積分 \(\int\frac{g^2}{2\sigma}\mathcal E\,\epsilon\,d\tau\) 用各次數外插算出的值和精確值。
瀏覽器實測(\(x_T=0.3\);加權積分的精確值由精確軌跡算出,誤差 = 外插值 − 精確值):
| 步 | \(t\) | 精確值 | \(n=0\)(DDIM) | \(n=1\) | \(n=2\) | \(n=3\) |
|---|---|---|---|---|---|---|
| 4 | 0.671 → 0.522 | −0.4317 | \(-3.7\times10^{-3}\) | \(-2.7\times10^{-3}\) | \(-2.0\times10^{-3}\) | \(-1.4\times10^{-3}\) |
| 6 | 0.344 → 0.174 | 0.0008 | −0.17 | −0.15 | −0.13 | −0.11 |
| 8 | 0.071 → 0.026 | 0.1043 | \(5.2\times10^{-4}\) | \(5.8\times10^{-3}\) | \(1.1\times10^{-3}\) | \(-5.5\times10^{-3}\) |
三種情形。(1) 第 4 步,\(\epsilon^*\) 還在平滑地變,次數越高越準,從 \(3.7\times10^{-3}\) 一路降到 \(1.4\times10^{-3}\),這是 DEIS 設計時想要的情形。(2) 第 6 步,軌跡正在「決定要去哪一團」,\(\epsilon^*\) 在這一步內急轉彎(圖上灰線的那段陡坡),過去的錨點完全沒有預告這個轉折,所有次數都錯了一個量級,高次只好一點點。外插只能延續已經發生的趨勢。(3) 第 8 步,轉折剛過,錨點裡還帶著轉折的痕跡,線性和三次外插反而衝過頭,比常數(DDIM)差 10 倍。這就是書說的「高次外插對錨點和誤差敏感」。換一個起點 \(x_T\),轉折發生在不同的步。
04DPM-Solver:換成 log-SNR 時鐘書 §9.4 開頭、§9.4.1
DPM-Solver(Lu et al. 2022)利用 DDIM 一節出現的同一個 diffusion 專屬結構,為 empirical PF-ODE 發展高階解法。核心目標是用比一階取樣器少得多的神經網路計算得到準確的樣本。原始的 DPM-Solver 專注在雜訊預測,建構一、二、三階的 single-step 解法;之後的延伸,包括 DPM-Solver++(Lu et al. 2022)和 DPM-Solver-v3(Zheng et al. 2023),進一步發展了這個家族。
高層次的想法
B25 說明了在 \(\bm\epsilon\)-預測下,一階更新可以靠「解析保留已知時程、在每步內固定神經預測」得到。DPM-Solver 自然地建在這個想法上:不把神經預測當常數,而是去找它沿軌跡怎麼變的高階近似。和 DEIS 一樣,它從 PF-ODE 的半線性 \(\bm\epsilon\)-預測形式
$$\frac{d\mathbf x_t}{dt}=\frac{\alpha_t'}{\alpha_t}\mathbf x_t-\sigma_t\Big(\frac{\alpha_t'}{\alpha_t}-\frac{\sigma_t'}{\sigma_t}\Big)\bm\epsilon_{\bm\phi^\times}(\mathbf x_t,t)$$和它的變數常數變易表示出發。關鍵的新成分,是依 VDM(Kingma et al. 2021)的 log-SNR 參數化,把時間重新參數化成 half-log signal-to-noise ratio:
這個座標透過 \(\rho_t=e^{-\lambda_t}\) 直接連到 DDIM 的時程對齊時鐘 \(\rho_t=\sigma_t/\alpha_t\)(B25),並把剩下依賴模型的項變成一個特別方便的指數加權積分。神經預測在 \(\lambda\) 裡的局部 Taylor 近似就能解析地積分,提供一條從一階 DDIM 更新走向高階 diffusion 解法的系統化路線。
上面的 PF-ODE 形式和 B24 的雜訊形式一樣
B24 的雜訊形式是 \(f\mathbf x+\frac{g^2}{2\sigma}\bm\epsilon\),\(f=\alpha'/\alpha\)、\(\frac{g^2}{2\sigma}=\sigma'-\frac{\alpha'}{\alpha}\sigma=-\sigma\big(\frac{\alpha'}{\alpha}-\frac{\sigma'}{\sigma}\big)\)。
把 PF-ODE 換成 log-SNR 時間
假設在關心的區間上 \(\alpha_t>0\)、\(\sigma_t>0\)、\(\lambda_t\) 嚴格單調。它就有反函數 \(t_\lambda(\cdot)\),滿足 \(t=t_\lambda(\lambda(t))\)。對 \(\sigma_0=0\) 的時程,\(t\to0\) 時 \(\lambda_t\to+\infty\),所以牽涉到端點 \(t=0\) 的式子要透過極限,或在數值實作裡透過一個小的正終點時間來理解。
接著把狀態、時程和神經預測都用 \(\lambda\) 座標表示:
$$\hat{\mathbf x}_\lambda:=\mathbf x_{t_\lambda(\lambda)},\qquad\alpha_\lambda:=\alpha_{t_\lambda(\lambda)},\quad\sigma_\lambda:=\sigma_{t_\lambda(\lambda)},\qquad\hat{\bm\epsilon}_{\bm\phi^\times}(\mathbf x,\lambda):=\bm\epsilon_{\bm\phi^\times}\big(\mathbf x,t_\lambda(\lambda)\big).$$所以沿 empirical PF-ODE 軌跡 \(\hat{\bm\epsilon}_{\bm\phi^\times}(\hat{\mathbf x}_\lambda,\lambda)=\bm\epsilon_{\bm\phi^\times}(\mathbf x_{t_\lambda(\lambda)},t_\lambda(\lambda))\)。因為 \(\frac{d\lambda_t}{dt}=\frac{\alpha_t'}{\alpha_t}-\frac{\sigma_t'}{\sigma_t}\),PF-ODE 可以寫成 \(\frac{d\mathbf x_t}{dt}=\frac{d\log\alpha_t}{dt}\mathbf x_t-\sigma_t\frac{d\lambda_t}{dt}\bm\epsilon_{\bm\phi^\times}(\mathbf x_t,t)\)。用鏈鎖律 \(\frac{d\mathbf x_t}{dt}=\frac{d\hat{\mathbf x}_\lambda}{d\lambda}\frac{d\lambda_t}{dt}\)、\(\frac{d\log\alpha_t}{dt}=\frac{d\log\alpha_\lambda}{d\lambda}\frac{d\lambda_t}{dt}\),兩邊除以 \(\frac{d\lambda_t}{dt}\),得到 log-SNR 時間的 PF-ODE:
對它用同樣的指數積分器(變數常數變易)技巧,得到下面的精確解。
證明:線性項的積分因子是 \(\exp\big(\int_{\lambda_s}^{\lambda_t}\frac{d\log\alpha_\lambda}{d\lambda}d\lambda\big)=\frac{\alpha_t}{\alpha_s}\)。所以變數常數變易給出 \(\frac{\alpha_t}{\alpha_s}\mathbf x_s-\int_{\lambda_s}^{\lambda_t}\frac{\alpha_t}{\alpha_\lambda}\sigma_\lambda\hat{\bm\epsilon}\,d\lambda\),再用 \(\sigma_\lambda/\alpha_\lambda=e^{-\lambda}\)。
關鍵的數值後果現在很明白:在 \(\lambda\) 時間裡,精確解中唯一依賴模型的量出現在 \(\int_{\lambda_s}^{\lambda_t}e^{-\lambda}\hat{\bm\epsilon}_{\bm\phi^\times}(\hat{\mathbf x}_\lambda,\lambda)\,d\lambda\) 裡。把模型輸出局部近似成 \(\lambda\) 的 Taylor 多項式,得到的指數加權多項式項可以用閉式積分,給出顯式的高階更新係數。所以和 B24 的分解觀點一樣,已知的時程依賴解析地保留,近似集中在神經預測上。
為什麼要重新參數化時間(直覺)
對嚴格單調的 \(\lambda(t)\),局部的一階變數變換給出 \(|\Delta t|\approx|\Delta\lambda|/|\lambda'(t)|\)。所以如果數值格點用固定的步長 \(|\Delta\lambda|\),誘導出的 \(t\) 步長在 \(|\lambda'(t)|\) 大(\(\lambda\) 隨 \(t\) 變化快)的地方比較小、在 \(|\lambda'(t)|\) 小的地方比較大。
重新參數化本身不改變 PF-ODE 的解路徑,只改變同一條路徑怎麼被參數化:\(\frac{d\hat{\mathbf x}_\lambda}{d\lambda}=\frac{1}{\lambda'(t)}\frac{d\mathbf x_t}{dt}\)。所以在 \(|\lambda'(t)|\) 大的地方,軌跡對 \(t\) 的同樣變化,被攤在比較大的 \(\lambda\) 範圍上。
更重要的是,\(\lambda(t)\) 直接用訊號和雜訊的相對平衡來量 diffusion 過程的進度。固定的 \(\Delta\lambda\) 對應 \(\alpha_t/\sigma_t\) 的固定倍數變化(等價地,log-SNR 的固定加法變化),而同樣的 \(\Delta t\) 在不同時刻可能對應非常不同的破壞程度變化。所以在 \(\lambda\) 裡均勻放數值節點,是沿 diffusion 軌跡重新分配解析度的自然方式。在原本時間 \(t\) 裡誘導出的精確間距取決於選的雜訊時程。兩個簡單的例子:
- \((\alpha_t,\sigma_t)=(1-t,t)\)(flow matching 常用的線性內插):\(\lambda(t)=\log\frac{1-t}{t}\)、\(\lambda'(t)=-\frac{1}{t(1-t)}\),所以局部 \(|\Delta t|\approx|\Delta\lambda|\,t(1-t)\)。均勻的 \(\lambda\) 格點在兩端 \(t\to0\)、\(t\to1\) 附近誘導出很小的 \(t\) 步,在軌跡中段比較大。
- \((\alpha_t,\sigma_t)=(1,t)\)(EDM 參數化,Karras et al. 2022,把自變數 \(t\) 直接當成雜訊等級 \(\sigma_t\)):\(\lambda(t)=\log\frac1t\)、\(\lambda'(t)=-\frac1t\),所以 \(|\Delta t|\approx|\Delta\lambda|\,t\)。事實上均勻的 \(\lambda\) 間距就是 \(t=e^{-\lambda}\),對應的雜訊等級是等比的:在小雜訊(高 SNR)處絕對間距較細,在大雜訊(低 SNR)處較粗。
Demo B均勻的 λ 格點長什麼樣轉述者補充
每一列是一個時程,上面的點是 \(t\) 上均勻的 \(M+1\) 個節點,下面的點是 \(\lambda\) 上均勻的節點(兩者有相同的端點)。DDPM 式 VP 和 \((1-t,t)\) 的範圍是 \(t\in[0.002,1]\)(\((1-t,t)\) 的右端改成 0.998,因為 \(t=1\) 時 \(\alpha=0\)、\(\lambda=-\infty\));\((1,t)\) 是 EDM 式的雜訊等級 \(t\in[0.002,80]\),畫在對數軸上。
05Taylor 展開與 DPM-Solver-n 的實作書 §9.4.2–9.4.3
DEIS 和 DPM-Solver 利用同一個分解原則,但用不同方式得到高階資訊。DEIS 重用前幾步已完成的預測,把神經預測外插到下一個區間;DPM-Solver 則在 log-SNR 座標 \(\lambda\) 裡對神經預測做局部 Taylor 展開,所需的高階資訊來自這一步內的額外模型計算。
從上一節的命題,從目前數值狀態 \(\tilde{\mathbf x}_s\) 出發的精確 empirical PF-ODE flow 是
$$\widetilde{\bm\Psi}_{s\to t}(\tilde{\mathbf x}_s)=\frac{\alpha_t}{\alpha_s}\tilde{\mathbf x}_s-\alpha_t\int_{\lambda_s}^{\lambda_t}e^{-\lambda}\,\hat{\bm\epsilon}_{\bm\phi^\times}(\hat{\mathbf x}_\lambda,\lambda)\,d\lambda,$$其中 \(\hat{\mathbf x}_{\lambda_s}=\tilde{\mathbf x}_s\),\(\hat{\mathbf x}_\lambda\) 是這一步上對應的精確 empirical PF-ODE 軌跡。所以已知的時程因子解析處理之後,剩下的數值問題是在加權積分裡近似 \(\lambda\mapsto\hat{\bm\epsilon}_{\bm\phi^\times}(\hat{\mathbf x}_\lambda,\lambda)\)。對 \(n\ge1\),把這個神經預測在 \(\lambda_s\) 附近展開:
$$\hat{\bm\epsilon}_{\bm\phi^\times}(\hat{\mathbf x}_\lambda,\lambda)=\sum_{k=0}^{n-1}\frac{(\lambda-\lambda_s)^k}{k!}\,\hat{\bm\epsilon}^{(k)}_{\bm\phi^\times}(\hat{\mathbf x}_{\lambda_s},\lambda_s)+\mathcal O\big((\lambda-\lambda_s)^n\big),$$其中 \(\hat{\bm\epsilon}^{(k)}_{\bm\phi^\times}(\hat{\mathbf x}_\lambda,\lambda):=\frac{d^k}{d\lambda^k}\hat{\bm\epsilon}_{\bm\phi^\times}(\hat{\mathbf x}_\lambda,\lambda)\) 表示沿 empirical PF-ODE 軌跡的第 \(k\) 階全導數。特別是
$$\frac{d}{d\lambda}\hat{\bm\epsilon}_{\bm\phi^\times}(\hat{\mathbf x}_\lambda,\lambda)=\frac{\partial}{\partial\lambda}\hat{\bm\epsilon}_{\bm\phi^\times}(\hat{\mathbf x}_\lambda,\lambda)+J_{\mathbf x}\hat{\bm\epsilon}_{\bm\phi^\times}(\hat{\mathbf x}_\lambda,\lambda)\,\frac{d\hat{\mathbf x}_\lambda}{d\lambda},$$所以導數同時包含對 \(\lambda\) 的明顯依賴,以及透過演化中的狀態的依賴。把 Taylor 展開代進精確 flow:
(這裡的 \(C_k\) 是 DPM-Solver 的係數,和上面 DEIS 的 \(C_{i,j}\) 是不同的量。)如果所需的軌跡導數可以取得,丟掉 \(\mathcal O(h^{n+1})\) 的餘項就得到對應的形式 \(n\) 階更新。DPM-Solver 用額外的模型計算近似這些導數,避免對神經網路明確微分。
\(n\ge2\) 的 DPM-Solver-\(n\) 需要第 \(k\le n-1\) 階導數 \(\hat{\bm\epsilon}^{(k)}_{\bm\phi^\times}\)。直接算高階導數在實務上很貴,Lu et al. (2022) 也提出了近似這些導數的有效方法,見下。
DPM-Solver-\(n\)(\(n\ge2\))的實作
實作高階的 DPM-Solver-\(n\) 需要兩件事:事先算好係數 \(C_k\);以及近似 \(k\le n-1\) 階的導數 \(\hat{\bm\epsilon}^{(k)}_{\bm\phi^\times}\),避開精確高階導數的昂貴計算(ODE 文獻研究得很透徹的挑戰;Hochbruck & Ostermann 2005、Luan & Ostermann 2021)。一個常見的策略是有限差分。
事先算 \(C_k\)。令 \(s\)、\(t\) 是起點和終點時刻,\(h:=\lambda_t-\lambda_s\)。精確 empirical PF-ODE flow 的 Taylor 展開有如下形式:
前三個是 \(\varphi_1(h)=\frac{e^h-1}{h}\)、\(\varphi_2(h)=\frac{e^h-h-1}{h^2}\)、\(\varphi_3(h)=\frac{e^h-\frac{h^2}2-h-1}{h^3}\)。
從 \(\alpha_tC_k\) 到 \(\sigma_th^{k+1}\varphi_{k+1}(h)\)
令 \(u=\lambda-\lambda_s\):\(C_k=e^{-\lambda_s}\int_0^he^{-u}\frac{u^k}{k!}du\)。反覆分部積分(或認出不完全 Gamma 函數):
$$\int_0^he^{-u}\frac{u^k}{k!}du=1-e^{-h}\sum_{j=0}^k\frac{h^j}{j!}.$$(檢查 \(k=0\):\(1-e^{-h}\)。對 \(h\) 微分兩邊都是 \(e^{-h}h^k/k!\)。)所以 \(\alpha_tC_k=\alpha_te^{-\lambda_s}\big(1-e^{-h}\sum_{j\le k}\frac{h^j}{j!}\big)\)。用 \(e^{-\lambda_s}=\sigma_s/\alpha_s\) 和 \(e^h=\frac{\alpha_t\sigma_s}{\sigma_t\alpha_s}\)(也就是 \(\alpha_t\sigma_s/\alpha_s=\sigma_te^h\)):
$$\alpha_tC_k=\sigma_te^h\Big(1-e^{-h}\sum_{j=0}^k\frac{h^j}{j!}\Big)=\sigma_t\Big(e^h-\sum_{j=0}^k\frac{h^j}{j!}\Big)=\sigma_t\,h^{k+1}\varphi_{k+1}(h).$$\(\varphi_m(h)\) 在 \(h\to0\) 時趨於 \(1/m!\),因為 \(e^h\) 去掉前 \(m\) 項之後的首項是 \(h^m/m!\)。所以 \(h^{k+1}\varphi_{k+1}(h)=\mathcal O(h^{k+1})\):第 \(k\) 階導數的係數本身就是 \(h^{k+1}\) 的大小。
近似 \(k\le n-1\) 階的導數。對 \(n\ge2\),依照 single-step ODE 解法的標準做法(Atkinson et al. 2009),Lu et al. (2022) 用這一步內的額外模型計算來近似高階導數。以 \(n=2\) 為例。令 \(\gamma\in(0,1]\) 指定 log-SNR 區間 \([\lambda_s,\lambda_t]\) 裡的一個階段點。給定 \(s\) 的估計 \(\tilde{\mathbf x}_s\),定義 \(s^{\text{mid}}=t_\lambda(\lambda_s+\gamma h)\)。\(\gamma\in(0,1)\) 是內部點,\(\gamma=1\) 對應終點 \(t\)。先用一步 DPM-Solver-1 預測這個階段的狀態:
$$\mathbf x^{\text{mid}}=\frac{\alpha_{s^{\text{mid}}}}{\alpha_s}\tilde{\mathbf x}_s-\sigma_{s^{\text{mid}}}\big(e^{\gamma h}-1\big)\bm\epsilon_{\bm\phi^\times}(\tilde{\mathbf x}_s,s).$$起點和階段點的模型預測之差,給出沿軌跡第一階全導數的有限差分近似:
$$\hat{\bm\epsilon}^{(1)}_{\bm\phi^\times}(\hat{\mathbf x}_{\lambda_s},\lambda_s)\approx\frac{\bm\epsilon_{\bm\phi^\times}(\mathbf x^{\text{mid}},s^{\text{mid}})-\bm\epsilon_{\bm\phi^\times}(\tilde{\mathbf x}_s,s)}{\gamma h}.$$代入二階展開:
所以丟掉 \(\mathcal O(h^3)\) 的餘項就得到二階的 single-step 更新。中點選擇 \(\gamma=\frac12\) 時,DPM-Solver-2 有更簡單的兩階段形式(下面的演算法),它和上式只差 \(\mathcal O(h^3)\),所以有同樣的二階精度。
- \(\tilde{\mathbf x}_{t_0}\gets\mathbf x_T\)
- 對 \(i=1,\dots,M\):
- \(h_i\gets\lambda_{t_i}-\lambda_{t_{i-1}}\)
- \(s_i^{\text{mid}}\gets t_\lambda\big(\frac{\lambda_{t_{i-1}}+\lambda_{t_i}}{2}\big)\)
- \(\mathbf x_i^{\text{mid}}\gets\frac{\alpha_{s_i^{\text{mid}}}}{\alpha_{t_{i-1}}}\tilde{\mathbf x}_{t_{i-1}}-\sigma_{s_i^{\text{mid}}}\big(e^{h_i/2}-1\big)\bm\epsilon_{\bm\phi^\times}(\tilde{\mathbf x}_{t_{i-1}},t_{i-1})\)
- \(\tilde{\mathbf x}_{t_i}\gets\frac{\alpha_{t_i}}{\alpha_{t_{i-1}}}\tilde{\mathbf x}_{t_{i-1}}-\sigma_{t_i}\big(e^{h_i}-1\big)\bm\epsilon_{\bm\phi^\times}(\mathbf x_i^{\text{mid}},s_i^{\text{mid}})\)
- 回傳 \(\tilde{\mathbf x}_{t_M}\)
為什麼兩階段形式和有限差分形式只差 \(\mathcal O(h^3)\)(\(\gamma=\frac12\))
記 \(\bm\epsilon_s\)、\(\bm\epsilon_m\) 為起點和中點的預測。有限差分形式是 \(-\sigma_t\big[(e^h-1)\bm\epsilon_s+\frac{2}{h}(e^h-h-1)(\bm\epsilon_m-\bm\epsilon_s)\big]\),兩階段形式是 \(-\sigma_t(e^h-1)\bm\epsilon_m=-\sigma_t\big[(e^h-1)\bm\epsilon_s+(e^h-1)(\bm\epsilon_m-\bm\epsilon_s)\big]\)。差在 \(\bm\epsilon_m-\bm\epsilon_s\) 前面的係數:\(\frac2h(e^h-h-1)-(e^h-1)=\frac2h\big(\frac{h^2}2+\frac{h^3}6+\cdots\big)-\big(h+\frac{h^2}2+\cdots\big)=-\frac{h^2}{6}+\mathcal O(h^3)\)。而 \(\bm\epsilon_m-\bm\epsilon_s=\mathcal O(h)\),所以兩者差 \(\mathcal O(h^3)\)。
實作細節:取樣時間點的選擇
因為 DPM-Solver 在 log-SNR 時間 \(\lambda\) 裡建構局部高階近似,自然的選擇是讓數值節點在 \(\lambda\) 裡均勻。對有限的終點時刻 \(t_M>0\),
$$\lambda_{t_i}=\lambda_{t_0}+\frac iM\big(\lambda_{t_M}-\lambda_{t_0}\big),\qquad i=0,\dots,M.$$如果 \(\sigma_0=0\),那 \(\lambda_0=+\infty\),所以實務上改用一個對應小正時刻的有限終點 log-SNR,端點則用對應的極限或最後一步去噪處理。推導雖然在 \(\lambda\) 空間進行,預訓練模型和時程 \((\alpha_t,\sigma_t)\) 通常是用原本的 diffusion 時間 \(t\) 參數化的。所以取樣時,每當要計算模型或需要時程係數,每個選定的 log-SNR 節點都透過 \(t_i=t_\lambda(\lambda_{t_i})\) 映射回去(例如上面的演算法)。\(\lambda\) 是數值積分的座標,取樣器仍然在對應的時間標籤上計算原本的預訓練模型。
DDPM 式 VP 時程的 \(t_\lambda\) 有閉式(轉述者補充)
\(\alpha_t^2=e^{-q(t)}\),\(q(t)=0.1t+9.95t^2\),\(\sigma_t^2=1-e^{-q}\)。所以 \(e^{-2\lambda}=\sigma^2/\alpha^2=e^q-1\),\(q=\log(1+e^{-2\lambda})\),再解二次方程 \(9.95t^2+0.1t-q=0\) 取正根。Demo C 就用這個閉式;用二分法反解會慢幾十倍。
06DDIM = DPM-Solver-1,以及和 Runge–Kutta 的關係書 §9.4.4–9.4.5
一階的 DPM-Solver 恰好還原 DDIM。兩個方法都從同一條雜訊預測 PF-ODE 的精確積分表示出發,在一步上做同樣的近似 \(\bm\epsilon_{\bm\phi^\times}(\mathbf x_\tau,\tau)\approx\bm\epsilon_{\bm\phi^\times}(\tilde{\mathbf x}_s,s)\),再解析地積分剩下依賴時程的項。DDIM 直接在前面推出的時程對齊形式裡做這件事,DPM-Solver 則先用 log-SNR 座標改寫積分。在一階,換數值時鐘並不改變對模型預測的常數近似,所以兩個推導給出完全相同的有限步更新。
證明:由 \(\lambda\) 的定義,\(\frac{\sigma_s}{\alpha_s}=e^{-\lambda_s}\)、\(\frac{\sigma_t}{\alpha_t}=e^{-\lambda_t}\)。令 \(h=\lambda_t-\lambda_s\),則 \(e^h=\frac{\alpha_t/\sigma_t}{\alpha_s/\sigma_s}=\frac{\alpha_t\sigma_s}{\sigma_t\alpha_s}\),所以 $$-\sigma_t(e^h-1)=\sigma_t-\frac{\alpha_t}{\alpha_s}\sigma_s=\alpha_t\Big(\frac{\sigma_t}{\alpha_t}-\frac{\sigma_s}{\alpha_s}\Big).$$ 代入 DPM-Solver-1 就是 DDIM 的 \(\frac{\alpha_t}{\alpha_s}\tilde{\mathbf x}_s+\alpha_t\big(\frac{\sigma_t}{\alpha_t}-\frac{\sigma_s}{\alpha_s}\big)\bm\epsilon_{\bm\phi^\times}(\tilde{\mathbf x}_s,s)\)。
所以 DPM-Solver-1 和 DDIM 是同一個一階有限步更新的兩種推導。log-SNR 座標在超過一階之後才產生差別:高階 DPM-Solver 用它來近似雜訊預測沿軌跡怎麼變,而不是在整步上把預測當常數。
DPM-Solver 和 Runge–Kutta 型解法
DPM-Solver-1 恰好是 DDIM,所以它的一階行為已經清楚了。高階的問題是:DPM-Solver 怎麼改進這個一次計算的更新?連結在 Runge–Kutta(RK)方法。Euler 只用步開頭的向量場;RK 方法透過階段(stages),也就是在這一步內產生的狀態和時刻上的計算,取得額外的資訊。高階 DPM-Solver 遵循同樣的原則:不在整步上固定一個神經預測,而是引入額外的步內模型計算來捕捉它的變化。diffusion 專屬的差別是:已知的、依賴時程的因子解析地保留,分段近似只套用在學到的預測上。
DPM-Solver-2 和一般的中點 RK2。先把 DPM-Solver-2 和直接套在 \(\lambda\) 時間的完整雜訊預測 PF-ODE 上的古典中點 RK2 比較。簡寫它完整的右手邊為 \(\mathbf F(\hat{\mathbf x}_\lambda,\lambda)\)。中點選擇 \(\gamma=\frac12\) 時,令 \(\lambda_{\text{mid}}:=\lambda_s+\frac h2\),\(\alpha_{\text{mid}}\)、\(\sigma_{\text{mid}}\) 為對應的時程值,\(\hat{\bm\epsilon}_s:=\bm\epsilon_{\bm\phi^\times}(\tilde{\mathbf x}_s,s)\)。古典中點 RK2 是
$$\mathbf x^{\text{RK}}_{\text{mid}}=\tilde{\mathbf x}_s+\frac h2\mathbf F(\tilde{\mathbf x}_s,\lambda_s),\qquad\tilde{\mathbf x}^{\text{RK2}}_t=\tilde{\mathbf x}_s+h\,\mathbf F\big(\mathbf x^{\text{RK}}_{\text{mid}},\lambda_{\text{mid}}\big).$$一般 RK2 把兩階段的建構套在完整的 PF-ODE 速度上,包括已知的時程項和神經預測。對照之下,中點 DPM-Solver-2 先建構階段 \(\mathbf x^{\text{DPM2}}_{\text{mid}}=\frac{\alpha_{\text{mid}}}{\alpha_s}\tilde{\mathbf x}_s-\sigma_{\text{mid}}(e^{h/2}-1)\hat{\bm\epsilon}_s\),記對應的中點預測 \(\hat{\bm\epsilon}^{\text{DPM2}}_{\text{mid}}\),完整更新是 \(\tilde{\mathbf x}^{\text{DPM2}}_t=\frac{\alpha_t}{\alpha_s}\tilde{\mathbf x}_s-\sigma_t(e^h-1)\hat{\bm\epsilon}^{\text{DPM2}}_{\text{mid}}\)。
結構上的差別一目了然:一般中點 RK2 離散化完整的 PF-ODE 速度;DPM-Solver-2 解析地保留已知的 diffusion 演化,只用它的兩次模型計算來近似雜訊預測的變化。在標準平滑假設下,兩者都是 \(\lambda\) 時間裡同一條 empirical PF-ODE 的二階方法。它們的中間狀態一般差 \(\mathcal O(h^2)\),完整的單步更新差 \(\mathcal O(h^3)\)。所以 DPM-Solver-2 遵循和古典 RK2 一樣的兩階段中點原則,但在套用數值近似之前先利用已知的 diffusion 結構。
DPM-Solver-2 和指數中點 RK2。更接近的比較是保留 \(\lambda\) 時間 PF-ODE 的半線性分解、把已知的線性部分解析處理。對應的指數中點 RK2(ExpRK2)先用一個指數 Euler 階段走到中點:
$$\mathbf x^{\text{ExpRK}}_{\text{mid}}=\frac{\alpha_{\text{mid}}}{\alpha_s}\tilde{\mathbf x}_s-\alpha_{\text{mid}}\sigma_s\Big[\int_{\lambda_s}^{\lambda_{\text{mid}}}\frac{1}{\alpha_\lambda}d\lambda\Big]\hat{\bm\epsilon}_s,$$計算 \(\hat{\bm\epsilon}^{\text{ExpRK}}_{\text{mid}}:=\hat{\bm\epsilon}_{\bm\phi^\times}(\mathbf x^{\text{ExpRK}}_{\text{mid}},\lambda_{\text{mid}})\) 之後,完整的指數中點更新是
$$\tilde{\mathbf x}^{\text{ExpRK2}}_t=\frac{\alpha_t}{\alpha_s}\tilde{\mathbf x}_s-\alpha_t\sigma_{\text{mid}}\Big[\int_{\lambda_s}^{\lambda_t}\frac{1}{\alpha_\lambda}d\lambda\Big]\hat{\bm\epsilon}^{\text{ExpRK}}_{\text{mid}}.$$線性係數是常數時,這些積分係數化成顯式指數中點 RK2 常見的 \(\varphi_1\) 係數。DPM-Solver-2 用同樣的中點分段原則,但利用更細的雜訊預測分解 \(-\sigma_\lambda\hat{\bm\epsilon}_{\bm\phi^\times}(\hat{\mathbf x}_\lambda,\lambda)\):因為 \(\sigma_\lambda\) 也是從 diffusion 時程已知的,DPM-Solver-2 把它留在積分裡,只對神經預測分段。所以它的中點和整步係數分別是
$$\alpha_{\text{mid}}\int_{\lambda_s}^{\lambda_{\text{mid}}}\frac{\sigma_\lambda}{\alpha_\lambda}d\lambda=\sigma_{\text{mid}}\big(e^{h/2}-1\big),\qquad\alpha_t\int_{\lambda_s}^{\lambda_t}\frac{\sigma_\lambda}{\alpha_\lambda}d\lambda=\sigma_t\big(e^h-1\big),$$還原上面的演算法。三種建構差在 RK 階段近似的是什麼:
$$\begin{array}{rl}\textbf{一般 RK2:}&\text{對完整的 PF-ODE 速度分段;}\\[4pt]\textbf{ExpRK2:}&\text{精確傳播線性部分;對乘上係數的殘差 }\sigma_\lambda\hat{\bm\epsilon}_{\bm\phi^\times}\text{ 分段;}\\[4pt]\textbf{DPM-Solver-2:}&\text{也把 }\sigma_\lambda\text{ 解析保留,只對 }\hat{\bm\epsilon}_{\bm\phi^\times}\text{ 分段。}\end{array}$$指數 RK 和 DPM 的中點階段差 \(\mathbf x^{\text{DPM2}}_{\text{mid}}-\mathbf x^{\text{ExpRK}}_{\text{mid}}=-\alpha_{\text{mid}}\big[\int_{\lambda_s}^{\lambda_{\text{mid}}}\frac{\sigma_\lambda-\sigma_s}{\alpha_\lambda}d\lambda\big]\hat{\bm\epsilon}_s=\mathcal O(h^2)\)。對完整的一步,在 \(\lambda_{\text{mid}}\) 附近 Taylor 展開給出 \(\int_{\lambda_s}^{\lambda_t}\frac{\sigma_\lambda-\sigma_{\text{mid}}}{\alpha_\lambda}d\lambda=\mathcal O(h^3)\),而神經預測的平滑性給出 \(\hat{\bm\epsilon}^{\text{DPM2}}_{\text{mid}}-\hat{\bm\epsilon}^{\text{ExpRK}}_{\text{mid}}=\mathcal O(h^2)\)。因此 \(\tilde{\mathbf x}^{\text{DPM2}}_t-\tilde{\mathbf x}^{\text{ExpRK2}}_t=\mathcal O(h^3)\):DPM-Solver-2 和指數中點 RK2 在二階以內一致,但 DPM-Solver-2 在加權積分裡多保留一個解析已知的量 \(\sigma_\lambda\)。
為什麼 \(\int_{\lambda_s}^{\lambda_t}\frac{\sigma_\lambda-\sigma_{\text{mid}}}{\alpha_\lambda}d\lambda=\mathcal O(h^3)\)
在中點附近展開 \(\sigma_\lambda-\sigma_{\text{mid}}=\sigma'_{\text{mid}}(\lambda-\lambda_{\text{mid}})+\mathcal O(h^2)\)、\(\frac{1}{\alpha_\lambda}=\frac{1}{\alpha_{\text{mid}}}+\mathcal O(h)\)。主項 \(\frac{\sigma'_{\text{mid}}}{\alpha_{\text{mid}}}(\lambda-\lambda_{\text{mid}})\) 對中點對稱,在 \([\lambda_s,\lambda_t]\) 上積分為 0;剩下的被積函數是 \(\mathcal O(h^2)\),乘上長度 \(h\) 是 \(\mathcal O(h^3)\)。這也是中點規則比端點規則高一階的同一個原因。
Demo C高階解法的誤差與 NFE轉述者補充
一維資料、DDPM 式 VP 時程、精確的 \(\bm\epsilon^*\),100 個起點 \(x_T\sim\mathcal N(0,1)\),從 \(T=1\) 走到 \(0.002\)。參考答案用 \(\lambda\) 時間的 RK4 走 2,000 步(和 4,000 步的差在 \(10^{-10}\) 量級)。誤差是 \(|\tilde x-\widetilde\Psi|\) 的平均。方法:DDIM(= AB-DEIS-0 = DPM-Solver-1)、AB-DEIS-1/2/3(多項式在 \(t\) 裡,係數用 Gauss–Legendre 求積)、DPM-Solver-2(每步 2 NFE)、\(\lambda\) 時間的一般中點 RK2 和指數中點 RK2(各每步 2 NFE)。NFE 相同時,兩階段方法的步數是一半。
瀏覽器實測(和 Node 原型一致;每種設定約 1–2 秒)。預設設定(兩個窄峰、\(\lambda\) 均勻):
| 方法\NFE | 6 | 10 | 20 | 40 |
|---|---|---|---|---|
| DDIM | 0.041 | 0.020 | 0.0084 | 0.0039 |
| DEIS-1 | 0.017 | 0.0073 | 0.0024 | 0.00081 |
| DEIS-2 | 0.010 | 0.0043 | 0.0013 | 0.00037 |
| DEIS-3 | 0.0087 | 0.0037 | 0.0010 | 0.00026 |
| DPM-Solver-2 | 0.23 | 0.049 | 0.0058 | 0.00096 |
| RK2 | 0.74 | 0.15 | 0.013 | 0.0024 |
| ExpRK2 | 2.0 | 0.43 | 0.024 | 0.0037 |
(1) 多步法免費地拿到高階。DEIS 每步只多用存下的計算,在每個 NFE 都比 DDIM 準,次數越高越好:40 NFE 時 DEIS-3 的誤差是 DDIM 的 1/15。DDIM 的誤差在 NFE 加倍時大約減半,是一階的樣子。(2) 單步的二階方法少步時吃虧。DPM-Solver-2 每步 2 NFE,同樣的預算只能走一半的步:6 NFE(3 步)時誤差 0.23,比 DDIM 還差;到 20 NFE 才開始比 DDIM 準,40 NFE 時準 4 倍。(3) 保留已知結構確實有用。三個兩階段方法同樣是二階、同樣 NFE,DPM-Solver-2 在每個 NFE 都比一般 RK2 和 ExpRK2 準,6 NFE 時差了 3 到 9 倍。有趣的是 ExpRK2(只保留線性部分)比一般 RK2 還差:把 \(\sigma_\lambda\) 和神經預測綁在一起凍結,在這裡反而吃虧。
換設定之後,排序會變:
- 同一份資料、改成 \(t\) 均勻:幾乎所有方法都變差(只有 DDIM 在 20 NFE 反而從 0.0084 變成 0.0056),而且 DEIS 的高次反而有害(6 NFE:DDIM 0.17、DEIS-3 0.26;40 NFE:DDIM 0.0040、DEIS-3 0.010)。\(t\) 均勻時大步落在 \(\epsilon^*\) 急轉的低雜訊段,外插失準。DPM-Solver-2 在 6 NFE 的誤差到了 3.7。時間格點的選擇和方法本身一樣重要,這是書強調 \(\lambda\) 的原因之一。
- 兩個寬峰(標準差 0.5)、\(\lambda\) 均勻:DEIS-3 仍然最好(40 NFE:\(3.8\times10^{-4}\)),但一般 RK2(\(1.2\times10^{-3}\))反過來比 DPM-Solver-2(0.012)準 10 倍。和 B24 一樣:資料寬時「凍結神經預測」不再是好的近似,保留已知結構的好處就消失了。
這些都只是一維的玩具例子,用的是精確的 score;它們說明的是書的原則(各方法近似了什麼、在什麼條件下準),而不是實際影像模型上的排名。