DDIM:凍結這一步開頭的雜訊預測,其餘的照雜訊時程精確地走
B24 留下一個具體的問題:已知的時程因子精確保留之後,積分裡剩下的神經預測要怎麼近似?DDIM 給了最簡單的答案:用這一步開頭的值。由此得到的更新有好幾種等價的寫法,最直覺的一種是「把開頭推斷出的乾淨估計和雜訊估計固定住,用目標時刻的係數重新組合」。這一頁接著精確地說明 DDIM 和 Euler、指數 Euler 的關係:三者都是一階、每步一次 NFE,差在凍結了什麼;而 DDIM 在換成 \(\mathbf x/\alpha\) 和 \(\sigma/\alpha\) 的座標之後,恰好就是 Euler。最後是 DDIM 最初的變分推導:訓練目標只決定每個時刻的邊際,不決定不同時刻怎麼耦合,DDIM 就利用這個自由度。
讀完這頁你應該能夠
- 從 PF-ODE 的精確解推出 DDIM 更新,並寫出它的四種等價形式。
- 說明為什麼凍結 \(\bm\epsilon\) 和凍結 \(\mathbf x\) 給出同一個 DDIM,而凍結 score 或速度給出不同的方法。
- 比較 DDIM、Euler、指數 Euler 各凍結了什麼、局部誤差由什麼決定,並說明 DDIM 在哪個座標下恰好是 Euler。
- 從「邊際一致」的條件推出 DDIM 的變分核、\(\eta\) 參數化,並說明它和 DDPM、conditional flow matching 的關係。
前置知識
- B24:半線性 PF-ODE、變數常數變易的精確解、分解式指數積分器、傳統指數 Euler。這一頁直接接著用。
- B16:四種預測的換算 \(\mathbf x=\alpha_t\mathbf x^*+\sigma_t\bm\epsilon^*\)、\(\mathbf s^*=-\bm\epsilon^*/\sigma_t\)。
- B04:DDPM 的變分觀點與前向後驗;B12:conditional flow matching。
「書 §」標出原文位置。灰框「轉述者補充」是書裡沒有的內容;藍框「推導」展開書中省略的步驟。
01DDIM 在這一章的位置書 §9.2 開頭
Denoising Diffusion Implicit Models(DDIM;Song, Meng & Ermon 2020)是最早、也最廣泛使用的 diffusion 取樣加速方法之一。DDIM 最初是從機率的觀點提出的,但它的確定性更新也可以透過 PF-ODE 得到特別乾淨的解讀。所以書在這一章共同的「數值解 ODE」框架下介紹 DDIM,把它原本的變分觀點放到第 4 節。
B24 留下一個具體的數值問題:已知的、依賴時程的因子保留成解析的之後,剩下的積分裡的神經預測要怎麼近似?DDIM 採取最簡單的答案:用這一步開頭的值。書先推出由此得到的更新,再釐清它和古典 Euler 積分、以及之後高階 diffusion 解法的關係。
02DDIM 是一階的 diffusion 解法書 §9.2.1
考慮從時刻 \(s\) 的起點 \(\tilde{\mathbf x}_s\) 走一步到 \(t\lt s\)。在雜訊預測下,B24 的變數常數變易公式給出精確的 empirical PF-ODE flow:
$$\widetilde{\bm\Psi}_{s\to t}(\tilde{\mathbf x}_s)=\mathcal E(s\to t)\,\tilde{\mathbf x}_s+\frac12\int_s^t\frac{g^2(\tau)}{\sigma_\tau}\,\mathcal E(\tau\to t)\,\bm\epsilon_{\bm\phi^\times}(\mathbf x_\tau,\tau)\,d\tau.$$依賴時程的因子都是解析已知的;積分裡唯一的未知量,是沿著未知軌跡算的神經預測 \(\bm\epsilon_{\bm\phi^\times}(\mathbf x_\tau,\tau)\)。從 PF-ODE 的觀點,確定性 DDIM 用最簡單的一階近似:把雜訊預測固定在這一步開頭的值,
$$\bm\epsilon_{\bm\phi^\times}(\mathbf x_\tau,\tau)\approx\bm\epsilon_{\bm\phi^\times}(\tilde{\mathbf x}_s,s),\qquad\tau\in[t,s],$$同時把已知的時程因子留在積分裡。這給出
$$\tilde{\mathbf x}_t=\mathcal E(s\to t)\,\tilde{\mathbf x}_s+\Big[\frac12\int_s^t\frac{g^2(\tau)}{\sigma_\tau}\,\mathcal E(\tau\to t)\,d\tau\Big]\bm\epsilon_{\bm\phi^\times}(\tilde{\mathbf x}_s,s).$$用 \(f(t)=\alpha_t'/\alpha_t\),積分因子化簡成 \(\mathcal E(s\to t)=\alpha_t/\alpha_s\)。剩下的時程係數也有方便的閉式:\(\frac12\frac{g^2(\tau)}{\sigma_\tau}\mathcal E(\tau\to t)=\alpha_t\frac{d}{d\tau}\big(\frac{\sigma_\tau}{\alpha_\tau}\big)\)。所以神經預測一旦在這一步內固定,剩下的積分可以從雜訊時程精確算出。
兩個化簡
積分因子。\(\int_s^tf(u)du=\int_s^t(\log\alpha_u)'du=\log\alpha_t-\log\alpha_s\),所以 \(\mathcal E(s\to t)=\alpha_t/\alpha_s\)。
係數。B24 的腳註給出 \(g^2=2\sigma\sigma'-2\frac{\alpha'}{\alpha}\sigma^2\),所以 \(\frac{g^2(\tau)}{2\sigma_\tau}=\sigma_\tau'-\frac{\alpha_\tau'}{\alpha_\tau}\sigma_\tau\)。另一方面
$$\frac{d}{d\tau}\Big(\frac{\sigma_\tau}{\alpha_\tau}\Big)=\frac{\sigma_\tau'\alpha_\tau-\sigma_\tau\alpha_\tau'}{\alpha_\tau^2}=\frac{1}{\alpha_\tau}\Big(\sigma_\tau'-\frac{\alpha_\tau'}{\alpha_\tau}\sigma_\tau\Big).$$乘上 \(\mathcal E(\tau\to t)=\alpha_t/\alpha_\tau\) 就是 \(\alpha_t\frac{d}{d\tau}(\sigma_\tau/\alpha_\tau)\)。
所以 DDIM 做的近似非常明確:已知的時程演化在整個區間上保留,只忽略了神經預測的變化。
用乾淨資料預測,得到同一個 DDIM
在乾淨資料預測下有類似的推導。精確的 empirical PF-ODE flow 可以寫成
$$\widetilde{\bm\Psi}_{s\to t}(\tilde{\mathbf x}_s)=\frac{\sigma_t}{\sigma_s}\tilde{\mathbf x}_s+\sigma_t\int_s^t\frac{d}{d\tau}\Big(\frac{\alpha_\tau}{\sigma_\tau}\Big)\mathbf x_{\bm\phi^\times}(\mathbf x_\tau,\tau)\,d\tau.$$用同樣的一階近似,把 \(\mathbf x_{\bm\phi^\times}(\mathbf x_\tau,\tau)\) 固定在時刻 \(s\) 的值,剩下的時程積分精確地算出來:
$$\tilde{\mathbf x}_t=\frac{\sigma_t}{\sigma_s}\tilde{\mathbf x}_s+\alpha_s\Big(\frac{\alpha_t}{\alpha_s}-\frac{\sigma_t}{\sigma_s}\Big)\mathbf x_{\bm\phi^\times}(\tilde{\mathbf x}_s,s).$$\(\mathbf x\)-預測的精確解和這個更新
B24 的表:\(\mathbf x\)-預測下 \(a=\sigma'/\sigma\)、\(b=\alpha(\frac{\alpha'}{\alpha}-\frac{\sigma'}{\sigma})\)。積分因子 \(\mathcal E(\tau\to t)=\exp\int_\tau^t(\log\sigma)'=\sigma_t/\sigma_\tau\)。所以
$$\mathcal E(\tau\to t)\,b(\tau)=\sigma_t\,\frac{\alpha_\tau}{\sigma_\tau}\Big(\frac{\alpha_\tau'}{\alpha_\tau}-\frac{\sigma_\tau'}{\sigma_\tau}\Big)=\sigma_t\,\frac{d}{d\tau}\Big(\frac{\alpha_\tau}{\sigma_\tau}\Big),$$就是上面的精確解。凍結 \(\mathbf x_{\bm\phi^\times}\) 之後積分得 \(\sigma_t\big(\frac{\alpha_t}{\sigma_t}-\frac{\alpha_s}{\sigma_s}\big)=\alpha_t-\frac{\sigma_t}{\sigma_s}\alpha_s=\alpha_s\big(\frac{\alpha_t}{\alpha_s}-\frac{\sigma_t}{\sigma_s}\big)\)。
所以,在雜訊預測的 PF-ODE 裡凍結雜訊預測,或在乾淨資料預測的 PF-ODE 裡凍結乾淨資料預測,產生同一個 DDIM 更新。這個對應之後會在 DPM-Solver 和 DPM-Solver++ 再出現:它們分別從雜訊和乾淨資料預測的表述建出高階近似(B26、B27)。
等價形式與解讀
在 oracle 層級,標準的預測目標逐點地透過 B16 的換算在代數上等價。所以上面從雜訊預測推出的確定性 DDIM 更新,可以在起點 \(s\) 改寫成乾淨資料或 score 預測,而不改變這一步的有限步更新:
四式互換
都只用 \(\tilde{\mathbf x}_s=\alpha_s\mathbf x^*+\sigma_s\bm\epsilon^*\) 和 \(\mathbf s^*=-\bm\epsilon^*/\sigma_s\)(都在 \((\tilde{\mathbf x}_s,s)\) 取值)。
第一式 → 第四式:\(\frac{\alpha_t}{\alpha_s}(\alpha_s\mathbf x^*+\sigma_s\bm\epsilon^*)+(\sigma_t-\frac{\alpha_t\sigma_s}{\alpha_s})\bm\epsilon^*=\alpha_t\mathbf x^*+\sigma_t\bm\epsilon^*\)。
第二式 → 第四式:\(\frac{\sigma_t}{\sigma_s}(\alpha_s\mathbf x^*+\sigma_s\bm\epsilon^*)+(\alpha_t-\frac{\sigma_t\alpha_s}{\sigma_s})\mathbf x^*=\alpha_t\mathbf x^*+\sigma_t\bm\epsilon^*\)。
第一式 → 第三式:代入 \(\bm\epsilon^*=-\sigma_s\mathbf s^*\):\(\alpha_t(\frac{\sigma_t}{\alpha_t}-\frac{\sigma_s}{\alpha_s})(-\sigma_s)=\sigma_s(\frac{\alpha_t\sigma_s}{\alpha_s}-\sigma_t)=\sigma_s^2(\frac{\alpha_t}{\alpha_s}-\frac{\sigma_t}{\sigma_s})\)。
Demo A 在 Node 和瀏覽器裡把這幾式各算一次,結果相同到浮點捨入。
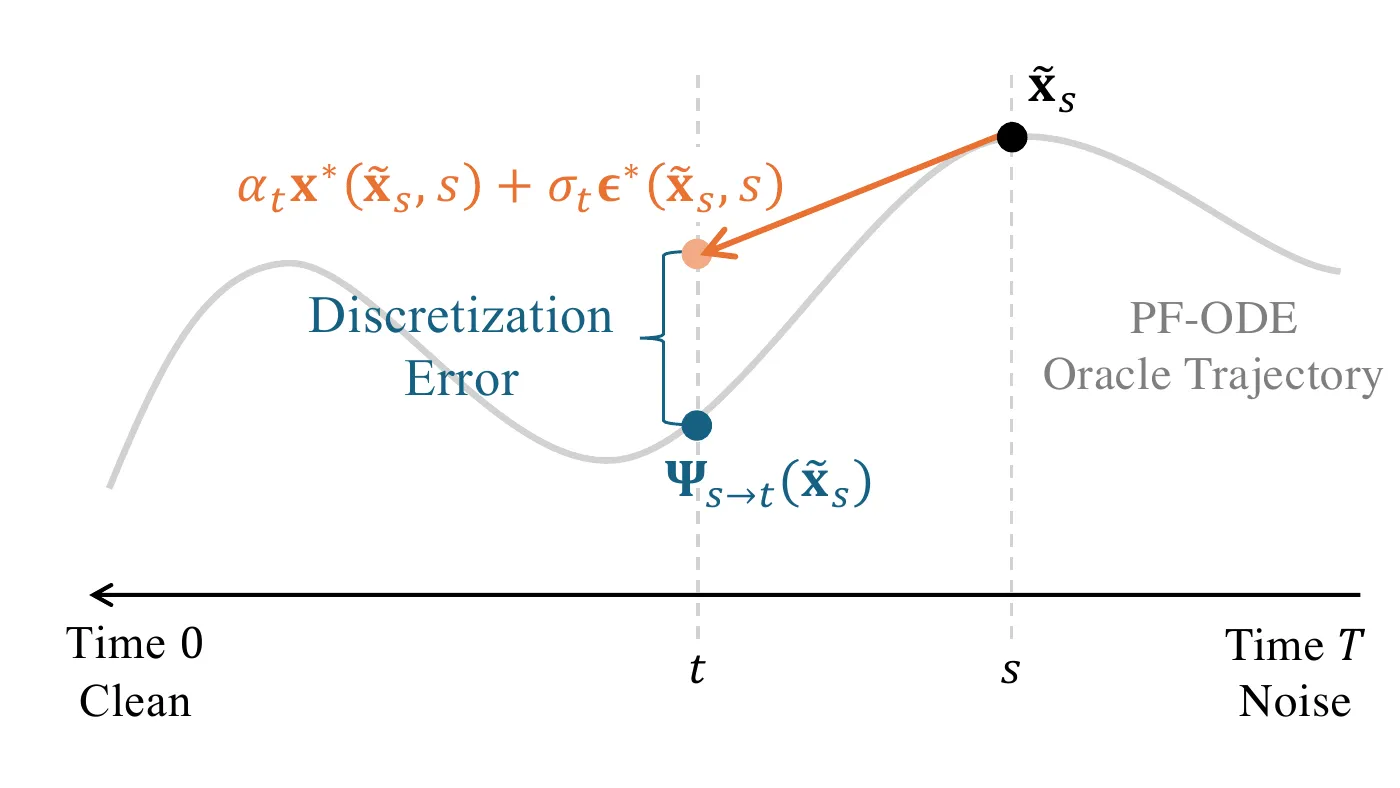
最後一式給 DDIM 一個特別直覺的看法:從 \(\tilde{\mathbf x}_s\) 出發,DDIM 把在時刻 \(s\) 推斷出的乾淨估計和雜訊估計固定住,再用目標時刻的時程係數重新組合:
$$\tilde{\mathbf x}_t=\alpha_t\,\mathbf x^*(\tilde{\mathbf x}_s,s)+\sigma_t\,\bm\epsilon^*(\tilde{\mathbf x}_s,s).$$這和前向高斯路徑的「共用雜訊」耦合 \(\mathbf x_\tau=\alpha_\tau\mathbf x_0+\sigma_\tau\bm\epsilon\) 一模一樣:固定一對 \((\mathbf x_0,\bm\epsilon)\),從一個時刻移到另一個時刻只改變係數 \((\alpha_\tau,\sigma_\tau)\)。DDIM 用這一步開頭能得到的乾淨和雜訊估計,套用同一個想法。
在條件層級,\(\mathbf x_0\) 和 \(\bm\epsilon\) 都固定時,這個重新組合精確地沿著對應的共用雜訊路徑走。但在邊際層級,\(\mathbf x^*(\tilde{\mathbf x}_s,s)\) 和 \(\bm\epsilon^*(\tilde{\mathbf x}_s,s)\) 是從 \(\tilde{\mathbf x}_s\) 推斷出的後驗估計。所以有限步的 DDIM 一般只是邊際 PF-ODE flow 的近似,而不是從 \(p_t\) 精確地抽樣。
凍結哪一個預測,為什麼重要
在任何固定的狀態和時刻,標準的預測參數化都透過換算在代數上等價。但有限步解法多了一個近似:在一個區間上把某一個選定的預測固定住。這樣的凍結近似,只有在換算後的預測沿著得到的近似軌跡也保持常數時,才在換參數化之後保持不變。
DDIM 是一個特別乾淨的例子。令
$$\widehat{\mathbf x}_0:=\mathbf x_{\bm\phi^\times}(\tilde{\mathbf x}_s,s),\qquad\widehat{\bm\epsilon}:=\bm\epsilon_{\bm\phi^\times}(\tilde{\mathbf x}_s,s),$$如果模型只直接預測其中一個,另一個由 B16 的代數換算定義。所以依構造 \(\tilde{\mathbf x}_s=\alpha_s\widehat{\mathbf x}_0+\sigma_s\widehat{\bm\epsilon}\)。把這一對開頭的乾淨/雜訊估計固定住,就定義了整個區間上的 DDIM 內插:
這不需要額外的模型計算:\((\widehat{\mathbf x}_0,\widehat{\bm\epsilon})\) 在時刻 \(s\) 固定之後,每個中間時刻 \(\tau\) 的時程係數 \((\alpha_\tau,\sigma_\tau)\) 都是已知的。\(\tau=s\) 時還原起點,\(\tau=t\) 時給出 DDIM 更新,中間的值就是 DDIM 近似誘導的有限步軌跡。
雜訊和乾淨資料預測的特殊地位現在一目了然。沿著這條軌跡,
$$\frac{\tilde{\mathbf x}_\tau^{\text{DDIM}}-\sigma_\tau\widehat{\bm\epsilon}}{\alpha_\tau}=\widehat{\mathbf x}_0,\qquad\frac{\tilde{\mathbf x}_\tau^{\text{DDIM}}-\alpha_\tau\widehat{\mathbf x}_0}{\sigma_\tau}=\widehat{\bm\epsilon}.$$也就是說,代數換算出的乾淨和雜訊預測沿著 DDIM 軌跡一起保持常數。因此凍結 \(\bm\epsilon_{\bm\phi^\times}\) 或凍結 \(\mathbf x_{\bm\phi^\times}\) 得到同一個 DDIM 更新。在這個意義上,\(\widehat{\mathbf x}_0\) 和 \(\widehat{\bm\epsilon}\) 是 DDIM 共用雜訊路徑的兩個固定成分,\((\alpha_\tau,\sigma_\tau)\) 則是已知的、隨時間變化的權重。
score 和速度的行為就不同了。DDIM 固定推斷出的乾淨/雜訊對,但由這一對得到的 score 和速度一般會隨時間變。例如把固定的(時刻 \(s\) 的)雜訊估計換成中間時刻 \(\tau\) 的 score:
$$\mathbf s(\tilde{\mathbf x}_\tau^{\text{DDIM}},\tau)=-\frac{\widehat{\bm\epsilon}}{\sigma_\tau}=\frac{\sigma_s}{\sigma_\tau}\,\mathbf s_{\bm\phi^\times}(\tilde{\mathbf x}_s,s).$$雖然 \(\widehat{\bm\epsilon}\) 固定,它對應的 score 透過因子 \(1/\sigma_\tau\) 隨 \(\tau\) 變化。所以直接要求 \(\mathbf s_{\bm\phi^\times}(\mathbf x_\tau,\tau)\approx\mathbf s_{\bm\phi^\times}(\tilde{\mathbf x}_s,s)\)(\(\tau\in[t,s]\))是一個不同的有限步近似,一般會給出另一個一階的分解式解法。類似地,固定的乾淨/雜訊對誘導的速度是
$$\frac{d}{d\tau}\tilde{\mathbf x}_\tau^{\text{DDIM}}=\alpha_\tau'\widehat{\mathbf x}_0+\sigma_\tau'\widehat{\bm\epsilon},$$因為時程的導數 \(\alpha_\tau'\)、\(\sigma_\tau'\) 會變,這個速度一般隨 \(\tau\) 變化。改成固定原始的速度預測 \(\mathbf v_{\bm\phi^\times}(\mathbf x_\tau,\tau)\approx\mathbf v_{\bm\phi^\times}(\tilde{\mathbf x}_s,s)\),得到的是原本 diffusion 時間下的一般 Euler;它和 DDIM 的關係在第 3 節討論。
Demo ADDIM 走一步轉述者補充
一維資料 \(0.5\,\mathcal N(-1,0.2^2)+0.5\,\mathcal N(1,0.2^2)\),預測用精確的 \(\bm\epsilon^*\)。選一個起點 \(\tilde x_s\)(這裡取精確軌跡上的點)、從 \(s\) 走一步到 \(t\)。上圖:精確的 PF-ODE 軌跡(RK4 4,000 步)、DDIM 內插 \(\alpha_\tau\widehat x_0+\sigma_\tau\widehat\epsilon\)、Euler 的直線,以及凍結 score 和傳統指數 Euler 的終點。下圖:沿精確軌跡的 \(\epsilon^*(x_\tau,\tau)\) 和 \(x^*(x_\tau,\tau)\),對照 DDIM 固定住的 \(\widehat\epsilon\)、\(\widehat x_0\)。兩種時程:DDPM 式 VP(\(\beta(t)=0.1+19.9t\)),以及 flow matching 常用的 \((\alpha_t,\sigma_t)=(1-t,t)\)。
瀏覽器實測(和精確終點的差;DDIM 的四種寫法與 \((\mathbf y,\rho)\) 座標的 Euler 在每個設定都相同到小數第六位):
| 時程 | \(s\to t\) | \(\tilde x_s\) | DDIM | Euler | 凍結 score | 傳統指數 Euler | 沿軌跡的 \(x^*\) |
|---|---|---|---|---|---|---|---|
| VP | 0.6 → 0.3 | 0.4 | −0.080 | −0.029 | −0.028 | −0.302 | 0.069 → 0.418 |
| VP | 0.5 → 0.1 | 0.4 | −0.520 | −0.353 | −0.352 | −0.781 | 0.126 → 0.950 |
| VP | 0.2 → 0.02 | 1.1 | −0.053 | 0.105 | 0.066 | −0.072 | 1.011 → 1.088 |
| VP | 0.15 → 0.02 | 0.9 | −0.0038 | 0.066 | 0.0011 | −0.0042 | 0.999 → 1.005 |
| \((1-t,t)\) | 0.6 → 0.3 | 0.4 | −0.211 | −0.211 | −0.152 | −0.300 | 0.421 → 0.979 |
(1) 書的恆等式全部成立:四種 DDIM 寫法、\((\mathbf y,\rho)\) 座標的 Euler 給出同一個數;\((1-t,t)\) 時程下 DDIM 和 Euler 完全相同(−0.211、−0.211),而凍結 score 給出不同的結果(−0.152)。(2) 沒有普遍的排序,而且勝負正好對應「被凍結的量變了多少」。中段(0.6 → 0.3)軌跡還在決定要去哪一團,\(x^*\) 從 0.069 變到 0.418,凍結它的 DDIM 誤差(−0.080)比 Euler(−0.029)大;後段(0.15 → 0.02)軌跡已經確定在右邊那一團,\(x^*\) 幾乎不動(0.999 → 1.005),DDIM 的誤差只有 0.0038,Euler 是 0.066,大了 17 倍。(3) 傳統指數 Euler 在中段特別差(−0.302、−0.781):它把 \(b(\tau)=\frac{g^2}{2\sigma}\) 凍結在開頭的值,而這個係數在 VP 時程下隨 \(\tau\) 變化很大。下圖可以直接看出 DDIM 的誤差來源:虛線是 DDIM 以為不變的 \(\widehat\epsilon\)、\(\widehat x_0\),實線是它們沿精確軌跡真正的變化。
03DDIM 和 Euler 型方法的關係書 §9.2.2
上面說明了 DDIM 是一階方法,但它和古典 Euler 法的關係需要小心。把已知的 diffusion 時程和學到的預測分開之後,依「在一個有限步內固定什麼」,會得到不同的一階格式。書比較三種每步一次計算的建構:
- 一般 Euler:固定完整的 PF-ODE 速度;
- 指數 Euler:解析地處理已知的線性傳播,但固定剩下的、乘上係數的殘差;
- DDIM:固定開頭的乾淨/雜訊估計,同時保留它們在已知 diffusion 時程下的有限步演化。
從同一個 DDIM 更新的兩個等價觀點最容易看清這些區別:乾淨/雜訊形式讓它和一般 Euler 的差別一目了然,分解的半線性形式則釐清它和指數 Euler 的關係。接著找出剩下的離散化誤差,並說明 DDIM 在什麼精確意義下,經過一個和時程對齊的座標變換之後,本身就是 Euler 法。
DDIM 和一般 Euler
DDIM 和一般 Euler 用同樣的開頭模型資訊,但在有限步上的傳播方式不同。一般 Euler 局部地近似完整的 PF-ODE 速度;DDIM 保留已知 diffusion 時程的有限步演化,同時固定模型預測。所以對平滑的時程,兩個更新在一階上一致,一般差 \(\mathcal O((\Delta s)^2)\) 的項。
考慮從 \(s\) 往回走到 \(t\lt s\) 的一步,假設開頭的乾淨和雜訊預測在代數上一致:\(\tilde{\mathbf x}_s=\alpha_s\mathbf x_{\bm\phi^\times}(\tilde{\mathbf x}_s,s)+\sigma_s\bm\epsilon_{\bm\phi^\times}(\tilde{\mathbf x}_s,s)\)。時刻 \(s\) 對應的 empirical PF-ODE 速度是
$$\mathbf v_{\bm\phi^\times}(\tilde{\mathbf x}_s,s)=\alpha_s'\,\mathbf x_{\bm\phi^\times}(\tilde{\mathbf x}_s,s)+\sigma_s'\,\bm\epsilon_{\bm\phi^\times}(\tilde{\mathbf x}_s,s).$$為什麼 PF-ODE 速度是 \(\alpha'\mathbf x^*+\sigma'\bm\epsilon^*\)
B24 的雜訊形式 \(\frac{d\mathbf x}{dt}=f\mathbf x+\frac{g^2}{2\sigma}\bm\epsilon\),代入 \(f=\alpha'/\alpha\)、\(\frac{g^2}{2\sigma}=\sigma'-\frac{\alpha'}{\alpha}\sigma\),再用 \(\mathbf x=\alpha\mathbf x^*+\sigma\bm\epsilon\):
$$\frac{\alpha'}{\alpha}(\alpha\mathbf x^*+\sigma\bm\epsilon)+\Big(\sigma'-\frac{\alpha'}{\alpha}\sigma\Big)\bm\epsilon=\alpha'\mathbf x^*+\sigma'\bm\epsilon.$$這也正是第 4 節 conditional flow matching 的邊際速度。
一般 Euler 在整個步上 \(\tau\in[t,s]\) 固定這個完整速度:\(\tilde{\mathbf x}_t^{\text{Euler}}=\tilde{\mathbf x}_s-\Delta s\,\mathbf v_{\bm\phi^\times}(\tilde{\mathbf x}_s,s)\)。DDIM 則固定開頭的乾淨/雜訊預測對,同時把已知的時程係數從 \((\alpha_s,\sigma_s)\) 演化到 \((\alpha_t,\sigma_t)\):
$$\tilde{\mathbf x}_t^{\text{DDIM}}=\tilde{\mathbf x}_s+(\alpha_t-\alpha_s)\,\mathbf x_{\bm\phi^\times}(\tilde{\mathbf x}_s,s)+(\sigma_t-\sigma_s)\,\bm\epsilon_{\bm\phi^\times}(\tilde{\mathbf x}_s,s).$$兩者精確的有限步差是
$$\tilde{\mathbf x}_t^{\text{DDIM}}-\tilde{\mathbf x}_t^{\text{Euler}}=\big[\alpha_t-\alpha_s+\Delta s\,\alpha_s'\big]\mathbf x_{\bm\phi^\times}(\tilde{\mathbf x}_s,s)+\big[\sigma_t-\sigma_s+\Delta s\,\sigma_s'\big]\bm\epsilon_{\bm\phi^\times}(\tilde{\mathbf x}_s,s).$$對平滑的時程,\(\alpha_t-\alpha_s+\Delta s\,\alpha_s'=\frac{(\Delta s)^2}{2}\alpha_s''+\mathcal O((\Delta s)^3)\),\(\sigma\) 也一樣(\(t=s-\Delta s\) 的 Taylor 展開)。所以
DDIM 和一般 Euler 在一階上一致,但在有限步上一般不同。一般 Euler 把有限的時程變化 \((\alpha_t-\alpha_s,\sigma_t-\sigma_s)\) 換成局部線性化;DDIM 則解析地保留有限的時程演化。
一個直接的特例:如果 \(\alpha_\tau\) 和 \(\sigma_\tau\) 在 \([t,s]\) 上都是 \(\tau\) 的仿射函數,那麼 \(\alpha_t-\alpha_s=-\Delta s\,\alpha_s'\)、\(\sigma_t-\sigma_s=-\Delta s\,\sigma_s'\),DDIM 和一般 Euler 完全一致。這包括時程 \((\alpha_t,\sigma_t)=(1,t)\) 和 \((\alpha_t,\sigma_t)=(1-t,t)\)(參見 B16 關於仿射時程的討論)。所以兩者在有限步上的差別,來自已知時程在原本 diffusion 時間裡的非線性。Demo A 切到 \((1-t,t)\) 就看得到兩條線重合。
DDIM 和指數 Euler
上面用乾淨/雜訊表示說明 DDIM 和一般 Euler 的差別。現在回到 B24 的半線性表示,區分 DDIM 和傳統的指數 Euler。差別很簡單:兩者都解析地保留已知的線性演化,但在剩下的積分裡固定的量不同。在雜訊預測下,分解的 PF-ODE 有 \(a(\tau)=f(\tau)\)、\(b(\tau)=\frac{g^2(\tau)}{2\sigma_\tau}\)、\(\mathbf N_{\bm\phi^\times}=\bm\epsilon_{\bm\phi^\times}\),精確解裡依賴模型的項是 \(b(\tau)\bm\epsilon_{\bm\phi^\times}(\mathbf x_\tau,\tau)\)。
傳統指數 Euler 把這個乘上係數的量當成單一殘差,整個固定在開頭的值:\(b(\tau)\bm\epsilon_{\bm\phi^\times}(\mathbf x_\tau,\tau)\approx b(s)\bm\epsilon_{\bm\phi^\times}(\tilde{\mathbf x}_s,s)\),所以
$$\tilde{\mathbf x}_t^{\text{ExpEuler}}=\mathcal E(s\to t)\tilde{\mathbf x}_s+b(s)\Big[\int_s^t\mathcal E(\tau\to t)\,d\tau\Big]\bm\epsilon_{\bm\phi^\times}(\tilde{\mathbf x}_s,s).$$DDIM 用 B24 強調的更細的分解:\(b(\tau)\) 是時程已知的,所以留在積分裡,只固定神經預測:
$$\tilde{\mathbf x}_t^{\text{DDIM}}=\mathcal E(s\to t)\tilde{\mathbf x}_s+\Big[\int_s^t\mathcal E(\tau\to t)\,b(\tau)\,d\tau\Big]\bm\epsilon_{\bm\phi^\times}(\tilde{\mathbf x}_s,s).$$所以兩個更新的有限步差完全來自已知的係數 \(b(\tau)\):
$$\tilde{\mathbf x}_t^{\text{DDIM}}-\tilde{\mathbf x}_t^{\text{ExpEuler}}=\Big[\int_s^t\mathcal E(\tau\to t)\big(b(\tau)-b(s)\big)\,d\tau\Big]\bm\epsilon_{\bm\phi^\times}(\tilde{\mathbf x}_s,s)=\frac{(\Delta s)^2}{2}\,b'(s)\,\bm\epsilon_{\bm\phi^\times}(\tilde{\mathbf x}_s,s)+\mathcal O\big((\Delta s)^3\big)$$(後一式對平滑的 \(b\))。DDIM 和傳統指數 Euler 在一階上一致;唯一的差別是指數 Euler 把 \(b(\tau)\) 連同神經預測一起凍結在 \(b(s)\),DDIM 則保留 \(b(\tau)\) 的已知變化。所以只要 \(b(\tau)\) 在這一步內是常數(包括 B24 開頭那個常 \(b\) 的例子),兩者就完全相同。
\(\frac{(\Delta s)^2}{2}b'(s)\) 這一項
令 \(\tau=s-u\),\(u\in[0,\Delta s]\)。\(b(\tau)-b(s)=-u\,b'(s)+\mathcal O(u^2)\),\(\mathcal E(\tau\to t)=1+\mathcal O(\Delta s)\)。積分方向從 \(s\) 到 \(t\):\(\int_s^t(\cdot)d\tau=-\int_0^{\Delta s}(\cdot)du\),所以 \(-\int_0^{\Delta s}(-u\,b'(s))du=\frac{(\Delta s)^2}{2}b'(s)\),其餘是 \(\mathcal O((\Delta s)^3)\)。
和前面一般 Euler 的比較合起來,三個一階規則的差別只在:做常數近似之前,保留了多少已知結構(\(\tau\in[t,s]\),\(\widehat{\bm\epsilon}:=\bm\epsilon_{\bm\phi^\times}(\tilde{\mathbf x}_s,s)\)):
$$\begin{array}{rcl}\text{一般 Euler}&:&f(\tau)\mathbf x_\tau+b(\tau)\bm\epsilon_\tau\;\approx\;f(s)\tilde{\mathbf x}_s+b(s)\widehat{\bm\epsilon},\\[4pt]\text{指數 Euler}&:&b(\tau)\bm\epsilon_\tau\;\approx\;b(s)\widehat{\bm\epsilon},\\[4pt]\text{DDIM}&:&\bm\epsilon_\tau\;\approx\;\widehat{\bm\epsilon}.\end{array}$$三者都只用這一步開頭的一次神經網路計算。一般 Euler 近似完整的速度;指數 Euler 先保留已知的線性傳播;DDIM 再多保留已知的係數 \(b(\tau)\),只近似神經預測。這個階層講的是保留了哪些解析已知的項,而不是單步誤差的普遍排序。它主要的數值後果是:DDIM 剩下的近似可以完全歸到神經預測的變化上,如下所示。
每個方法還犯什麼錯
現在把每個更新和精確的 empirical PF-ODE flow 比較。做局部誤差分析時,假設這一步從精確的 empirical 狀態 \(\mathbf x_s\) 出發。三個單步誤差分別是
(第一式用直接速度形式 \(\widetilde{\bm\Psi}_{s\to t}(\mathbf x_s)=\mathbf x_s+\int_s^t\mathbf v_{\bm\phi^\times}d\tau\);後兩式用變數常數變易形式。)這些恆等式揭示了每個一階格式相關的「平滑」是什麼:對應的量沿著精確的 empirical 軌跡變化得慢,單步近似就準。更精確地說,在標準的平滑性下:
$$\begin{aligned}\big\|\widetilde{\bm\Psi}_{s\to t}(\mathbf x_s)-\tilde{\mathbf x}_t^{\text{Euler}}\big\|&\le\frac{(\Delta s)^2}{2}\sup_{\tau\in[t,s]}\Big\|\tfrac{d}{d\tau}\mathbf v_{\bm\phi^\times}(\mathbf x_\tau,\tau)\Big\|,\\\big\|\widetilde{\bm\Psi}_{s\to t}(\mathbf x_s)-\tilde{\mathbf x}_t^{\text{ExpEuler}}\big\|&\le\frac{(\Delta s)^2}{2}\sup_{\tau}\big|\mathcal E(\tau\to t)\big|\cdot\sup_{\tau}\Big\|\tfrac{d}{d\tau}\big[b(\tau)\bm\epsilon_{\bm\phi^\times}(\mathbf x_\tau,\tau)\big]\Big\|,\\\big\|\widetilde{\bm\Psi}_{s\to t}(\mathbf x_s)-\tilde{\mathbf x}_t^{\text{DDIM}}\big\|&\le\frac{(\Delta s)^2}{2}\sup_{\tau}\big|\mathcal E(\tau\to t)\,b(\tau)\big|\cdot\sup_{\tau}\Big\|\tfrac{d}{d\tau}\bm\epsilon_{\bm\phi^\times}(\mathbf x_\tau,\tau)\Big\|.\end{aligned}$$界的來源
以 DDIM 為例。\(\|\bm\epsilon(\mathbf x_\tau,\tau)-\bm\epsilon(\mathbf x_s,s)\|\le|s-\tau|\cdot\sup\|\frac{d}{d\tau}\bm\epsilon\|\)(均值定理,沿著精確軌跡對 \(\tau\) 微分)。把積分的被積函數取範數、把 \(|\mathcal E b|\) 用 sup 界住,剩下 \(\int_0^{\Delta s}u\,du=\frac{(\Delta s)^2}{2}\)。另外兩式完全相同,只是換成被凍結的那個量。
在通常的平滑與穩定性假設下,三個方法都是全域一階的,每步只需要一次神經網路計算。而且每個方法在某一步上,只要它固定的量沿精確的 empirical 軌跡確實是常數,就是精確的:一般 Euler 是完整的 PF-ODE 速度,指數 Euler 是乘上係數的殘差 \(b(\tau)\bm\epsilon_{\bm\phi^\times}(\mathbf x_\tau,\tau)\),DDIM 是雜訊預測 \(\bm\epsilon_{\bm\phi^\times}(\mathbf x_\tau,\tau)\)。
因此三者之間沒有普遍的誤差排序:每個方法在它固定的量在這一步內變化得慢時最準。DDIM 特別適合「神經預測變化慢、但已知 diffusion 時程變化明顯」的情形,因為它把後者解析地保留下來。利用更多已知結構可以減少離散化誤差,但不保證每一步的誤差都更小。這裡討論的是相對於 empirical PF-ODE 的數值離散化誤差;empirical 和 oracle PF-ODE 之間的模型誤差是另一個獨立的誤差來源。B24 的 Demo C 量到了這件事:資料幾乎是一點時 DDIM 大勝,資料寬時 Euler 準得多。
DDIM 精確地是 Euler:換座標之後
DDIM 和一般 Euler 雖然在一階上一致,在原本的狀態 \(\mathbf x\) 和 diffusion 時間 \(t\) 下一般給出不同的有限步更新。不過,同時對狀態和時間座標做一個和時程對齊的變換之後,有一個精確的 Euler 解讀。在雜訊預測下定義
兩個變換扮演互補的角色:狀態正規化 \(\mathbf x_t\mapsto\mathbf x_t/\alpha_t\) 把已知的訊號縮放除掉,新的時鐘 \(\rho_t=\sigma_t/\alpha_t\) 用「雜訊對訊號比」而不是原本的 diffusion 時間來量進度。
先看條件層級:固定一對 \((\mathbf x_0,\bm\epsilon)\),高斯擾動路徑是 \(\mathbf x_t=\alpha_t\mathbf x_0+\sigma_t\bm\epsilon\)(這裡的 \(\bm\epsilon\) 是一個固定的潛在雜訊實現,不是神經預測)。變換後的狀態滿足 \(\mathbf y_t=\mathbf x_0+\rho_t\bm\epsilon\),所以沿著這條條件路徑 \(\frac{d\mathbf y}{d\rho}=\bm\epsilon\)。也就是說,固定 \((\mathbf x_0,\bm\epsilon)\) 時,已知的時程依賴在新座標 \(\rho\) 裡變成仿射的。
對應的 empirical PF-ODE 有相同的座標結構,只是固定的潛在雜訊 \(\bm\epsilon\) 換成學到的、依賴狀態的雜訊預測。用 B24 的雜訊形式 \(\frac{d\mathbf x_t}{dt}=\frac{\alpha_t'}{\alpha_t}\mathbf x_t+\big(\sigma_t'-\frac{\alpha_t'}{\alpha_t}\sigma_t\big)\bm\epsilon_{\bm\phi^\times}(\mathbf x_t,t)\),得到
$$\frac{d\mathbf y_t}{dt}=\frac{1}{\alpha_t}\Big(\frac{d\mathbf x_t}{dt}-\frac{\alpha_t'}{\alpha_t}\mathbf x_t\Big)=\frac{d\rho_t}{dt}\,\bm\epsilon_{\bm\phi^\times}(\mathbf x_t,t).$$這兩個等號
商的微分:\(\frac{d}{dt}\frac{\mathbf x_t}{\alpha_t}=\frac{\mathbf x_t'}{\alpha_t}-\frac{\alpha_t'}{\alpha_t^2}\mathbf x_t\),就是第一個等號。把雜訊形式代進括號,線性項消掉,剩 \(\frac{1}{\alpha_t}(\sigma_t'-\frac{\alpha_t'}{\alpha_t}\sigma_t)\bm\epsilon=\frac{\sigma_t'\alpha_t-\sigma_t\alpha_t'}{\alpha_t^2}\bm\epsilon=\rho_t'\,\bm\epsilon\)。
所以在任何 \(\alpha_t>0\)、\(\rho_t\) 嚴格單調的區間上,可以用 \(\rho\) 當時間座標。寫 \(t=t(\rho)\),定義變換後的神經場 \(\bar{\bm\epsilon}_{\bm\phi^\times}(\mathbf y,\rho):=\bm\epsilon_{\bm\phi^\times}\big(\alpha_{t(\rho)}\mathbf y,t(\rho)\big)\),empirical PF-ODE 變成
模型對空間和時間的依賴仍然在,只是用變換後的變數 \((\mathbf y,\rho)\) 表示。對這條方程從 \(\rho_s\) 到 \(\rho_t\) 做顯式 Euler:\(\tilde{\mathbf y}_t=\tilde{\mathbf y}_s+(\rho_t-\rho_s)\bar{\bm\epsilon}_{\bm\phi^\times}(\tilde{\mathbf y}_s,\rho_s)\)。因為 \(\bar{\bm\epsilon}_{\bm\phi^\times}(\tilde{\mathbf y}_s,\rho_s)=\bm\epsilon_{\bm\phi^\times}(\tilde{\mathbf x}_s,s)\),代回 \(\mathbf y=\mathbf x/\alpha\)、\(\rho=\sigma/\alpha\) 得到
$$\tilde{\mathbf x}_t=\frac{\alpha_t}{\alpha_s}\tilde{\mathbf x}_s+\alpha_t\Big(\frac{\sigma_t}{\alpha_t}-\frac{\sigma_s}{\alpha_s}\Big)\bm\epsilon_{\bm\phi^\times}(\tilde{\mathbf x}_s,s),$$正是確定性 DDIM 更新。
乾淨資料預測下有對偶的建構:用 \(\sigma_t\) 正規化狀態、以 \(\alpha_t/\sigma_t\) 當時間座標,得到 \(\frac{d}{dt}\big(\frac{\mathbf x_t}{\sigma_t}\big)=\frac{d}{dt}\big(\frac{\alpha_t}{\sigma_t}\big)\mathbf x_{\bm\phi^\times}(\mathbf x_t,t)\),所以 DDIM 的乾淨資料形式同樣是對應座標裡的顯式 Euler。
這個「狀態–時間換座標」的觀點也預告了座標選擇在高階 diffusion 解法裡的角色。B26 的 DPM-Solver 用 half-log SNR \(\lambda_t:=\log\frac{\alpha_t}{\sigma_t}\),它和 DDIM 的 Euler 時鐘直接相關:\(\rho_t=\sigma_t/\alpha_t=e^{-\lambda_t}\)、\(d\rho=-e^{-\lambda}d\lambda\)。所以精確的變換方程也可以等價地積成
$$\mathbf y_t=\mathbf y_s-\int_{\lambda_s}^{\lambda_t}e^{-\lambda}\,\hat{\bm\epsilon}_{\bm\phi^\times}(\hat{\mathbf x}_\lambda,\lambda)\,d\lambda,$$用的是 B26 才引入的、以 \(\lambda\) 參數化的模型記號。在一階,固定神經預測、保留已知的變數變換權重,給出同一個有限步更新,所以 DPM-Solver-1 就是 DDIM。超過一階之後,在哪個座標裡近似那個依賴狀態與時間的神經預測,就成了數值方法的一部分。DPM-Solver 用 \(\lambda\),因為它給出一個指數加權的積分,有方便的高階展開。
04(選讀)DDIM 原本的變分觀點書 §9.2.3
上面的 PF-ODE 觀點把確定性 DDIM 解釋成一個數值解法。但在歷史上,DDIM 是從 DDPM 的變分觀點提出的。它的出發問題不一樣:去噪目標是否唯一決定了不同時刻的雜訊狀態必須怎麼耦合?
回顧 DDPM 的變分觀點
DDPM 引入一個固定的馬可夫推論過程,它的單時刻擾動邊際是高斯 \(p_t(\mathbf x_t\mid\mathbf x_0)=\mathcal N(\mathbf x_t;\alpha_t\mathbf x_0,\sigma_t^2\mathbf I)\)。對應的變分推導用到 \(p(\mathbf x_t\mid\mathbf x_s,\mathbf x_0)\)(\(t\lt s\))之類可算的條件分佈;用來生成的學到的反向模型則不能直接以未知的乾淨樣本 \(\mathbf x_0\) 為條件,改用 diffusion model 的預測。
DDIM 背後的關鍵觀察和去噪目標有關。雜訊預測的 DDPM 損失可以寫成
$$\mathbb E_t\,\mathbb E_{\mathbf x_0,\bm\epsilon}\Big[\big\|\bm\epsilon_{\bm\phi}(\alpha_t\mathbf x_0+\sigma_t\bm\epsilon,t)-\bm\epsilon\big\|_2^2\Big],$$它只透過單時刻邊際 \(p_t(\mathbf x_t\mid\mathbf x_0)\) 依賴推論過程,而不是透過給定 \(\mathbf x_0\) 時 \(\mathbf x_1,\dots,\mathbf x_T\) 的完整聯合耦合。
DDIM 原本的動機
所以去噪訓練目標並不唯一決定不同時刻的雜訊狀態怎麼耦合。固定一個乾淨樣本 \(\mathbf x_0\),常用的去噪代理目標由單時刻擾動邊際決定,而許多不同的跨時間聯合過程可以有完全相同的邊際。DDIM 利用這個自由度:保留訓練時用的擾動邊際,改變不同雜訊等級之間的耦合。
具體地,對任何 \(t\lt s\),考慮一個條件轉移 \(\pi(\mathbf x_t\mid\mathbf x_s,\mathbf x_0)\)。要求它是單步邊際一致的:
白話:如果 \(\mathbf x_s\sim p_s(\cdot\mid\mathbf x_0)\),套用一次選定的轉移就得到 \(\mathbf x_t\sim p_t(\cdot\mid\mathbf x_0)\)。所以每個雜訊等級的邊際分佈保持不變,即使 \(\mathbf x_s\) 和 \(\mathbf x_t\) 之間的依賴可以改變。原本馬可夫 DDPM 前向過程誘導的貝氏反向後驗是一個合法的選擇(書的腳註:對馬可夫前向過程 \(\mathbf x_0\to\mathbf x_t\to\mathbf x_s\),\(t\lt s\),由全機率公式 \(p_t(\mathbf x_t\mid\mathbf x_0)=\int p(\mathbf x_t\mid\mathbf x_s,\mathbf x_0)\,p_s(\mathbf x_s\mid\mathbf x_0)\,d\mathbf x_s\)),但它不由邊際唯一決定。DDIM 允許其他邊際一致的耦合,包括直接在相隔很遠的雜訊等級之間轉移。這就是同一個訓練好的去噪器可以用在跳過中間時刻的粗格點上的機率理由。
離散時間 DDIM 的推導
現在對高斯擾動模型 \(p_t(\mathbf x_t\mid\mathbf x_0):=\mathcal N(\mathbf x_t;\alpha_t\mathbf x_0,\sigma_t^2\mathbf I)\)(\(\mathbf x_0\sim p_{\text{data}}\))把這個耦合自由度寫清楚。目標是對任何 \(t\lt s\) 建構一個滿足邊際一致條件的條件轉移,不要求它和原本馬可夫前向過程的貝氏後驗一致。一個自然的選擇是高斯族
$$\pi(\mathbf x_t\mid\mathbf x_s,\mathbf x_0)=\mathcal N\big(\mathbf x_t;\,a_{t,s}\mathbf x_0+b_{t,s}\mathbf x_s,\,c_{t,s}^2\mathbf I\big),$$\((a_{t,s},b_{t,s},c_{t,s})\) 決定時刻 \(s\) 的狀態、乾淨樣本和新注入的雜訊怎麼組合。為了施加邊際一致,先抽 \(\mathbf x_s=\alpha_s\mathbf x_0+\sigma_s\bm\epsilon'\),再從上式抽 \(\mathbf x_t\)。等價地,
$$\begin{aligned}\mathbf x_t&=a_{t,s}\mathbf x_0+b_{t,s}\mathbf x_s+c_{t,s}\bm\epsilon=a_{t,s}\mathbf x_0+b_{t,s}(\alpha_s\mathbf x_0+\sigma_s\bm\epsilon')+c_{t,s}\bm\epsilon\\&=(a_{t,s}+b_{t,s}\alpha_s)\mathbf x_0+\sqrt{b_{t,s}^2\sigma_s^2+c_{t,s}^2}\;\bm\epsilon'',\end{aligned}$$其中 \(\bm\epsilon\)、\(\bm\epsilon'\) 是獨立的標準高斯,\(\bm\epsilon''\) 是代表它們正規化線性組合的標準高斯(兩個獨立高斯的線性組合仍是高斯,變異數相加)。要讓得到的邊際等於規定的 \(\mathcal N(\alpha_t\mathbf x_0,\sigma_t^2\mathbf I)\),平均和變異數必須一致:
$$\alpha_t=a_{t,s}+b_{t,s}\alpha_s,\qquad\sigma_t^2=b_{t,s}^2\sigma_s^2+c_{t,s}^2.$$重點是:這只是三個係數 \((a_{t,s},b_{t,s},c_{t,s})\) 上的兩個限制。所以規定的邊際不決定 \(s\) 和 \(t\) 之間唯一的轉移。可以把 \(c_{t,s}\) 當自由參數,\(0\le c_{t,s}\le\sigma_t\),再解出其餘的係數。取非負的分支:
$$b_{t,s}=\frac{\sqrt{\sigma_t^2-c_{t,s}^2}}{\sigma_s},\qquad a_{t,s}=\alpha_t-\alpha_sb_{t,s}.$$非負的 \(b_{t,s}\) 給出標準的 DDIM 耦合。代回去得到
這把耦合的自由度寫得很明白:\(\mathbf x_s-\alpha_s\mathbf x_0\) 是 \(\mathbf x_s\) 裡已經有的雜訊成分,\(c_{t,s}\) 控制從 \(s\) 轉移到 \(t\) 時注入多少新的高斯雜訊。改變 \(c_{t,s}\) 就改變兩個雜訊等級之間的耦合,同時保持同一個目標邊際 \(p_t(\mathbf x_t\mid\mathbf x_0)\)。
DDIM 取樣器(從 \(s\) 走到 \(t\))
邊際一致的核 \(\pi(\mathbf x_t\mid\mathbf x_s,\mathbf x_0)\) 仍然以未知的乾淨樣本 \(\mathbf x_0\) 為條件。生成時,DDIM 把 \(\mathbf x_0\) 換成預訓練 diffusion model 給的乾淨資料估計。在 \(\bm\epsilon\)-預測下定義 \(\mathbf x_{\bm\phi^\times}(\mathbf x_s,s):=\frac{\mathbf x_s-\sigma_s\bm\epsilon_{\bm\phi^\times}(\mathbf x_s,s)}{\alpha_s}\),並用代入式的轉移 \(p_{\bm\phi^\times}(\mathbf x_t\mid\mathbf x_s):=\pi\big(\mathbf x_t\mid\mathbf x_s,\mathbf x_{\bm\phi^\times}(\mathbf x_s,s)\big)\)。代入上面的核得到
代入的代數
平均是 \(\alpha_t\hat{\mathbf x}_0+b(\mathbf x_s-\alpha_s\hat{\mathbf x}_0)\),\(b=\sqrt{\sigma_t^2-c^2}/\sigma_s\)。因為 \(\mathbf x_s-\alpha_s\hat{\mathbf x}_0=\sigma_s\bm\epsilon_{\bm\phi^\times}\),第二項是 \(\sqrt{\sigma_t^2-c^2}\,\bm\epsilon_{\bm\phi^\times}\)。第一項 \(\alpha_t\hat{\mathbf x}_0=\frac{\alpha_t}{\alpha_s}(\mathbf x_s-\sigma_s\bm\epsilon_{\bm\phi^\times})\)。加起來就是框裡的平均,再加上變異數 \(c^2\) 的新雜訊。
所以模型預測決定從 \(s\) 帶到 \(t\) 的估計乾淨/雜訊內容,自由係數 \(c_{t,s}\in[0,\sigma_t]\) 控制這一步注入多少新的高斯雜訊。要解讀這個自由度,可以和原本的馬可夫前向過程比較。對 \(t\lt s\) 定義
$$\alpha_{s|t}:=\frac{\alpha_s}{\alpha_t},\qquad\sigma_{s|t}^2:=\sigma_s^2-\alpha_{s|t}^2\sigma_t^2,$$使得 \(p(\mathbf x_s\mid\mathbf x_t)=\mathcal N(\mathbf x_s;\alpha_{s|t}\mathbf x_t,\sigma_{s|t}^2\mathbf I)\)。高斯條件化給出對應的後驗變異數
$$\operatorname{Var}(\mathbf x_t\mid\mathbf x_s,\mathbf x_0)=\frac{\sigma_t^2}{\sigma_s^2}\,\sigma_{s|t}^2\,\mathbf I.$$後驗變異數,以及它的平均也對得上(轉述者補的驗證)
先驗 \(\mathbf x_t\mid\mathbf x_0\sim\mathcal N(\alpha_t\mathbf x_0,\sigma_t^2)\),概似 \(\mathbf x_s\mid\mathbf x_t\sim\mathcal N(\alpha_{s|t}\mathbf x_t,\sigma_{s|t}^2)\)。高斯共軛:精確度相加,
$$\frac{1}{\operatorname{Var}}=\frac{1}{\sigma_t^2}+\frac{\alpha_{s|t}^2}{\sigma_{s|t}^2}=\frac{\sigma_{s|t}^2+\alpha_{s|t}^2\sigma_t^2}{\sigma_t^2\sigma_{s|t}^2}=\frac{\sigma_s^2}{\sigma_t^2\sigma_{s|t}^2}.$$後驗平均是 \(\operatorname{Var}\cdot\big(\frac{\alpha_t\mathbf x_0}{\sigma_t^2}+\frac{\alpha_{s|t}\mathbf x_s}{\sigma_{s|t}^2}\big)=\frac{\sigma_{s|t}^2}{\sigma_s^2}\alpha_t\mathbf x_0+\frac{\alpha_{s|t}\sigma_t^2}{\sigma_s^2}\mathbf x_s\)。取 \(c=\frac{\sigma_t}{\sigma_s}\sigma_{s|t}\) 時,\(b=\frac{\sqrt{\sigma_t^2-c^2}}{\sigma_s}=\frac{\sigma_t}{\sigma_s^2}\sqrt{\sigma_s^2-\sigma_{s|t}^2}=\frac{\alpha_{s|t}\sigma_t^2}{\sigma_s^2}\),\(a=\alpha_t-\alpha_sb=\alpha_t\big(1-\frac{\alpha_{s|t}^2\sigma_t^2}{\sigma_s^2}\big)=\frac{\sigma_{s|t}^2}{\sigma_s^2}\alpha_t\)(用了 \(\alpha_s=\alpha_{s|t}\alpha_t\))。平均也完全一致,所以這個選擇下核就是 DDPM 的後驗。
這把 DDPM 後驗認定為上面邊際一致家族裡的一個特定成員,也讓 \(c_{t,s}\) 的角色變得明確:
- DDPM 步(後驗變異數):取 \(c_{t,s}=\frac{\sigma_t}{\sigma_s}\sigma_{s|t}\),和原本馬可夫前向過程的後驗變異數一致。配合非負的 \(b_{t,s}\),條件核就和那個過程的貝氏後驗 \(p(\mathbf x_t\mid\mathbf x_s,\mathbf x_0)\) 相同。
- 確定性 DDIM(\(\eta=0\)):另一個極端 \(c_{t,s}=0\),完全不注入新雜訊。實用的更新變成 \(\mathbf x_t=\frac{\alpha_t}{\alpha_s}\mathbf x_s+\big(\sigma_t-\frac{\alpha_t}{\alpha_s}\sigma_s\big)\bm\epsilon_{\bm\phi^\times}(\mathbf x_s,s)\),正是前面從 PF-ODE 推出的確定性 DDIM。在條件層級,它的共用雜訊解讀特別簡單:若 \(\mathbf x_s=\alpha_s\mathbf x_0+\sigma_s\bm\epsilon\),確定性轉移給出 \(\mathbf x_t=\alpha_t\mathbf x_0+\sigma_t\bm\epsilon\):沒有新雜訊,同一對 \((\mathbf x_0,\bm\epsilon)\) 被帶過這一步,只有已知的時程係數改變。
- 內插:更一般地定義 $$c_{t,s}=\eta\,\frac{\sigma_t}{\sigma_s}\,\sigma_{s|t},\qquad\eta\in[0,1].$$ 參數 \(\eta\) 連續地控制轉移的隨機性:\(\eta=0\) 是確定性 DDIM,\(\eta=1\) 和對應 DDPM 馬可夫轉移的後驗變異數一致。
所以 DDIM 家族把兩個成分分開處理:擾動邊際保持不變,相鄰雜訊等級之間的耦合則可以透過 \(c_{t,s}\) 改變。確定性 DDIM 對應在這一步保留既有的共用雜訊;DDPM 後驗的選擇則注入原本馬可夫前向過程規定的那麼多額外隨機性。
和 conditional flow matching 的連結
上面的確定性 DDIM 建構也提供了和 conditional flow matching(CFM,B12)的簡單連結。關鍵是區分同一條條件高斯路徑的兩個物件:它的有限時間映射和它的瞬時速度。DDIM 和前者有關,CFM 建立在後者上。以一個乾淨樣本 \(\mathbf x_0\) 為條件,考慮共用雜訊路徑 \(\mathbf x_\tau=\alpha_\tau\mathbf x_0+\sigma_\tau\bm\epsilon\);固定 \((\mathbf x_0,\bm\epsilon)\) 時,這是一條精確地通過高斯擾動邊際 \(p_\tau(\mathbf x_\tau\mid\mathbf x_0)\) 的條件軌跡。
有限時間觀點:條件的 DDIM 映射。假設軌跡在時刻 \(s\) 位於 \(\mathbf x_s\)。因為保留同一個 \(\bm\epsilon\),從 \(\mathbf x_s=\alpha_s\mathbf x_0+\sigma_s\bm\epsilon\) 消去它,得到精確的條件映射
$$\bm\Psi_{s\to t}(\mathbf x_s\mid\mathbf x_0)=\frac{\sigma_t}{\sigma_s}\mathbf x_s+\Big(\alpha_t-\alpha_s\frac{\sigma_t}{\sigma_s}\Big)\mathbf x_0.$$這個映射在給定 \(\mathbf x_0\) 時是精確的。它還不是實用的 DDIM 取樣器,因為生成時 \(\mathbf x_0\) 未知。把 \(\mathbf x_0\) 換成開頭的模型預測,就恰好是前面推出的確定性 DDIM 更新。
無窮小時間觀點:CFM 的條件速度。不問條件路徑在一段有限區間內移到哪裡,而問它的瞬時方向。對 \(\mathbf x_t=\alpha_t\mathbf x_0+\sigma_t\bm\epsilon\) 微分得 \(\frac{d\mathbf x_t}{dt}=\alpha_t'\mathbf x_0+\sigma_t'\bm\epsilon\);用 \(\bm\epsilon=(\mathbf x-\alpha_t\mathbf x_0)/\sigma_t\),同一個速度可以寫成目前狀態的函數:
$$\mathbf v_t^*(\mathbf x\mid\mathbf x_0)=\frac{\sigma_t'}{\sigma_t}\mathbf x+\Big(\alpha_t'-\alpha_t\frac{\sigma_t'}{\sigma_t}\Big)\mathbf x_0.$$這就是 conditional flow matching 裡和高斯機率路徑相關的條件速度。CFM 接著對目前狀態下 \(\mathbf x_0\) 的後驗不確定性取平均,把這個條件速度連到邊際動態:
$$\begin{aligned}\mathbf v^*(\mathbf x,t)&:=\mathbb E_{\mathbf x_0\sim p(\mathbf x_0\mid\mathbf x_t=\mathbf x)}\big[\mathbf v_t^*(\mathbf x\mid\mathbf x_0)\big]=\frac{\sigma_t'}{\sigma_t}\mathbf x+\Big(\alpha_t'-\alpha_t\frac{\sigma_t'}{\sigma_t}\Big)\mathbf x^*(\mathbf x,t)\\&=\alpha_t'\,\mathbf x^*(\mathbf x,t)+\sigma_t'\,\bm\epsilon^*(\mathbf x,t),\end{aligned}$$其中 \(\mathbf x^*(\mathbf x,t)=\mathbb E[\mathbf x_0\mid\mathbf x_t=\mathbf x]\)、\(\mathbf x=\alpha_t\mathbf x^*(\mathbf x,t)+\sigma_t\bm\epsilon^*(\mathbf x,t)\)。得到的 \(\mathbf v^*(\mathbf x,t)\) 正是 oracle 的邊際 PF-ODE 速度。
這個連結在條件路徑和它的瞬時速度的層級上是精確的。但它不表示有限步的 DDIM 就是精確的邊際 PF-ODE flow:DDIM 固定這一步開頭推斷出的預測,而精確的邊際 PF-ODE 速度隨著演化中的狀態連續地變化。
「條件映射取平均」和「平均速度再積分」為什麼不同(轉述者補充)
CFM 是先對速度取後驗平均、再積分:每個瞬間都重新問一次「現在的 \(\mathbf x\) 最可能來自哪個 \(\mathbf x_0\)」。DDIM 是在步的開頭問一次,然後整步都用那個答案。兩者只在後驗 \(p(\mathbf x_0\mid\mathbf x_\tau)\) 沿路不變時才一樣,例如資料只有一個點(後驗永遠是那個點)。這和 B24 局部誤差式的說法一致:誤差來自 \(\bm\epsilon^*\)(等價地 \(\mathbf x^*\))沿軌跡的變化。
Demo B同樣的邊際,不同的耦合轉述者補充
固定一個乾淨樣本 \(x_0=1\),DDPM 式 VP 時程,\(s=0.6\)、\(t=0.3\)。抽 5,000 個 \(x_s\sim p_s(\cdot\mid x_0)\),套用 DDIM 的條件核 \(\pi(x_t\mid x_s,x_0)\)(\(c_{t,s}=\eta\frac{\sigma_t}{\sigma_s}\sigma_{s|t}\))。左圖:\((x_s,x_t)\) 的散佈;右圖:\(x_t\) 的直方圖對照目標邊際 \(\mathcal N(\alpha_tx_0,\sigma_t^2)\)。
瀏覽器實測:\(\eta=0\) 時 \(c_{t,s}=0\),所有點落在一條直線上(相關係數 1.000);\(\eta=0.5\) 時相關係數 0.871(理論 0.872);\(\eta=1\)(DDPM 後驗)時只剩 0.208(理論 0.202)。而三種情形下 \(x_t\) 的邊際都和目標 \(\mathcal N(0.630,0.777^2)\) 一致:平均 0.631、0.634、0.636,標準差 0.782、0.787、0.791(5,000 個樣本,平均的抽樣誤差約 ±0.011;理論上三者的平均和變異數都精確等於目標)。這就是 DDIM 的核心觀察:訓練只看得到右圖(每個時刻的邊際),看不到左圖(兩個時刻之間的耦合),所以耦合可以自由選。
Demo Cη 與步數轉述者補充
同 Demo A 的兩峰資料、VP 時程、精確的 \(\bm\epsilon^*\)。用 DDIM 取樣步(加上 \(\eta\) 的新雜訊)在 \(t\) 上均勻的 \(M\) 步,從 \(T=1\) 走到 \(0.002\),各抽 20,000 個樣本,和資料在 \(t=0.002\) 的分佈比較(用 40,000 個資料樣本算一維 Wasserstein 距離 W₁)。同一組 \(M\) 的三個 \(\eta\) 一起算。
瀏覽器實測(和 Node 原型一致;每個 \(M\) 最多約 5 秒)。每格是 W₁,括號是右邊那一團的平均 ± 標準差(資料:0.998 ± 0.201):
| \(M\) | \(\eta=0\) | \(\eta=0.5\) | \(\eta=1\) |
|---|---|---|---|
| 5 | 0.256(0.747 ± 0.310) | 0.262(0.740 ± 0.310) | 0.294(0.707 ± 0.308) |
| 10 | 0.072(0.923 ± 0.213) | 0.079(0.921 ± 0.209) | 0.092(0.909 ± 0.208) |
| 20 | 0.034(0.968 ± 0.184) | 0.036(0.966 ± 0.180) | 0.045(0.964 ± 0.164) |
| 50 | 0.017(0.986 ± 0.191) | 0.024(0.983 ± 0.187) | 0.031(0.986 ± 0.169) |
在這個例子裡,每個步數下都是 \(\eta=0\)(確定性 DDIM)最接近資料、\(\eta=1\) 最遠,\(\eta=0\) 和 \(\eta=1\) 的差距從 \(M=5\) 的 0.038 縮小到 \(M=20\)、50 的約 0.01,和 Song et al. 原論文在影像上的觀察方向一致(少步時確定性的 DDIM 比 DDPM 式的隨機取樣好)。少步時三者共同的毛病是把兩團往中間拉(\(M=5\) 時右邊那一團的平均只有 0.71–0.75):這是一階方法在大步上的離散化誤差,不是 \(\eta\) 的問題。注意這只是一個一維的例子;書沒有宣稱 \(\eta=0\) 永遠最好,B24 第 1 節也提到 SDE 取樣器的隨機性在步數夠多時可能帶來更多樣的樣本。