Score Function:同一個模型的另一種說法,以及它換來的 SDE
上一講用向量場訓練。這一講換一個角度看同一件事:score \(\nabla\log p_t\)。高斯路徑下,向量場和 score 只差一個線性換算。多了 score,訓練好的 flow model 不必重新訓練,就能變成任意雜訊強度的 SDE。
讀完這頁你應該能夠
- 說明 score \(\nabla\log q(x)\) 的意思,並算出高斯路徑的條件 score。
- 證明邊際 score 是條件 score 的後驗加權平均。
- 推出高斯路徑下 \(u_t^{\text{target}}=a_t\nabla\log p_t+b_tx\) 的 \(a_t\) 和 \(b_t\)。
- 寫出 denoising score matching 的損失,說明網路其實在預測雜訊,以及 \(1/\beta_t^2\) 為什麼會造成數值不穩定。
- 寫出 SDE 擴充技巧,並用 Fokker–Planck 方程一步一步證明。
- 從隨機跳動推出 \(\frac{\sigma^2}{2}\Delta p\) 這一項。
- 解釋理論上所有 \(\sigma_t\) 都一樣、實務上卻不同的原因。
- 說明 Langevin 動力學是 SDE 擴充技巧的特例。
前置知識檢查
這一頁怎麼讀、記號
第 3 講的影片分成兩段。這一頁是上半段(46 分),下半段是 classifier-free guidance。老師說第 10 節的證明和通過這門課無關 28:28,而且就算略過 SDE 也不影響後面 27:53。
逐字稿是 YouTube 自動字幕,有疑問時以黑板和投影片為準。部分學生的提問麥克風沒收到,那些問答的標題是從老師的重述和回答推測的。
| 記號 | 意思 |
|---|---|
| \(\nabla\) | 對 \(x\) 的梯度(\(p_t(x\mid z)\) 有 \(x,z\) 兩個變數,老師特別提醒是對 \(x\)) |
| \(s_t^\theta(x)\) | score 網路 |
| \(\epsilon_t^\theta(x)\) | noise predictor,預測雜訊的網路 |
| \(L_{\text{SM}}\)、\(L_{\text{DSM}}\) | score matching、denoising score matching 損失;講義把後者寫成 \(\mathcal L_{\text{CSM}}\),是同一個 |
| \(a_t,b_t\) | 向量場和 score 的換算係數,第 5 節推導 |
| \(\Delta\) | Laplacian,所有二階偏導數的和 |
| \(\dot\alpha_t,\dot\beta_t\) | \(\alpha_t,\beta_t\) 對 \(t\) 的導數 |
| \(\partial_t\) | 對 \(t\) 偏微分,\(x\) 不動 |
| \(\operatorname{div}\) | 散度,第 2 講的連續方程用過:每個方向的偏導數加起來,代表淨流出 |
01回顧與今天的目標(投影片 1–6)
開場快速走過上一講 00:08:條件路徑、條件向量場、邊際路徑、邊際向量場,以及「對條件向量場做回歸,就學到邊際向量場」。今天的計畫 01:41:
- 用 score 當作新的角度,重新描述已經做過的事。
- 藉此把 ODE 取樣推廣到 SDE,也就是第 1 講定義的 diffusion model。
- 為下半段的 guidance 鋪路(另一頁)。
投影片筆誤:投影片 1 寫「IAP 2026 | Jan 23, 2025」,年份應該是 2026。
02Score 是什麼(投影片 7)
Score 只是一個分佈的函數,和機器學習無關 02:43。對分佈 \(q(x)\):
為什麼用 log?\(\nabla\log q=\nabla q/q\),等於把密度的梯度除以密度。密度很小的地方,\(\nabla q\) 幾乎是 0,但 \(\nabla\log q\) 仍然清楚指路。
03條件 score 與邊際 score
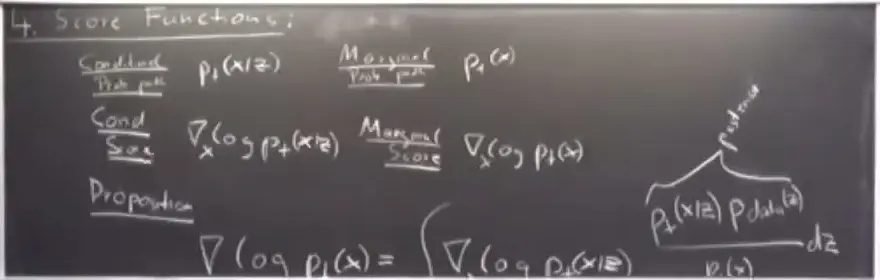
把 score 套到機率路徑上 03:14:條件 score \(\nabla\log p_t(x\mid z)\)、邊際 score \(\nabla\log p_t(x)\)。兩者的關係和向量場完全一樣:
證明 05:27:只用 \(\nabla\log f=\nabla f/f\),正反各用一次。
- 對數的導數:$$\nabla\log p_t(x)=\frac{\nabla p_t(x)}{p_t(x)}$$
- 代入邊際密度,交換梯度和積分(\(p_{\text{data}}(z)\) 不含 \(x\)):$$=\frac{\int\nabla p_t(x\mid z)\,p_{\text{data}}(z)\,\mathrm dz}{p_t(x)}$$
- 反過來用同一條規則,\(\nabla p_t(x\mid z)=p_t(x\mid z)\nabla\log p_t(x\mid z)\):$$\begin{aligned}=\int&\nabla\log p_t(x\mid z)\\&\cdot\frac{p_t(x\mid z)\,p_{\text{data}}(z)}{p_t(x)}\mathrm dz\end{aligned}$$
04高斯路徑的 score(投影片 8–10)
照投影片的三行做。\(p_t(x\mid z)=\mathcal N(\alpha_tz,\beta_t^2I_d)\) 的密度是
$$\begin{aligned}&p_t(x\mid z)\\&=\frac{1}{(2\pi)^{d/2}\beta_t^d}\exp\Big(-\frac{\Vert x-\alpha_tz\Vert^2}{2\beta_t^2}\Big)\end{aligned}$$取對數,前面的係數變成不含 \(x\) 的常數:
$$\log p_t(x\mid z)=\text{常數}-\frac{\Vert x-\alpha_tz\Vert^2}{2\beta_t^2}$$對 \(x\) 取梯度(\(\nabla\Vert x-c\Vert^2=2(x-c)\)):
意思:\(x-\alpha_tz\) 是從高斯中心到 \(x\) 的箭頭,加負號就是「指回中心」。
- 條件 score:\(z_1\) 是 \(-(0.5-1)/0.25=2\);\(z_2\) 是 \(-(0.5+1)/0.25=-6\)。
- 邊際 score:\(0.982\times2+0.018\times(-6)\),約 \(1.856\)。
05向量場和 score 可以互換(投影片 11–12)
老師把條件向量場和條件 score 並排 09:01:兩個都只是 \(z\) 和 \(x\) 的線性組合(各乘一個係數再相加),只差係數。所以可以互相換算。
推導
投影片只寫「代數,見講義」,講義也只說「做一點代數」。實際做一次:我們要找 \(a,b\),讓下面的等式對所有 \(x,z\) 都成立。
$$\begin{aligned}&\Big(\dot\alpha_t-\frac{\dot\beta_t}{\beta_t}\alpha_t\Big)z+\frac{\dot\beta_t}{\beta_t}x\\&=a\Big(\frac{\alpha_t}{\beta_t^2}z-\frac{1}{\beta_t^2}x\Big)+bx\end{aligned}$$- 比較 \(z\) 的係數:\(a\alpha_t/\beta_t^2=\dot\alpha_t-\dot\beta_t\alpha_t/\beta_t\)。兩邊乘 \(\beta_t^2/\alpha_t\),得到 \(a=\beta_t^2\dot\alpha_t/\alpha_t-\dot\beta_t\beta_t\)。
- 比較 \(x\) 的係數:\(-a/\beta_t^2+b=\dot\beta_t/\beta_t\)。代入 \(a\):\(a/\beta_t^2=\dot\alpha_t/\alpha_t-\dot\beta_t/\beta_t\),所以 \(b=\dot\alpha_t/\alpha_t\)。
- 邊際版:條件式兩邊用後驗加權積分。左邊變成邊際向量場,右邊第一項變成邊際 score(第 3 節),\(b_tx\) 不含 \(z\),而後驗積分是 1,所以留下 \(b_tx\)。
注意 \(t\to0\) 時 \(a_t,b_t\) 爆掉:\(t=0\) 時條件路徑不含 \(z\),score 不帶資料資訊,無法反推向量場。
老師的訊息 10:36:很多論文不談向量場,只談 score,你至少知道兩者沒有質的差別,只是重新參數化(同一個東西換一種寫法)。學到一個,就等於學到另一個。
第三種說法:denoiser(講義的 Remark,課堂沒講)
邊際化之後,向量場和 score 都只是後驗平均 \(\mathbb E[z\mid x]\) 的線性換算。所以能估出後驗平均的東西,都能換成它們。這個東西叫 denoiser:\(D_t(x)=\mathbb E[z\mid x]\),給有雜訊的 \(x\),猜乾淨的 \(z\)。
從高斯路徑直接看:邊際 score 是條件 score 的後驗平均,所以 \(\nabla\log p_t(x)=\frac{\alpha_tD_t(x)-x}{\beta_t^2}\)。手算:\(D=0.982\times2+0.018\times(-2)\),等於 \(1.928\);\(\frac{0.5\times1.928-0.5}{0.25}=1.856\),和上面一樣。這就是 CS236 第 13 講的 Tweedie 公式。
講義用向量場寫同一件事:\(D_t(x)=\frac{\beta_tu_t^{\text{target}}(x)-\dot\beta_tx}{\dot\alpha_t\beta_t-\alpha_t\dot\beta_t}\)。手算:分母 \(1\times0.5-0.5\times(-1)=1\),分子 \(0.5\times2.856+0.5=1.928\),又是同一個數。
注意 \(1.928\) 不是任何一個資料點(資料只有 \(2\) 和 \(-2\)),因為它是平均。講義留了一個思考題:denoiser 一定輸出乾淨的資料點嗎?這個例子就是反例。講義也說,在數值或訓練穩定性上,學它有時可能更好。
老師明確說這個換算「至少對高斯機率路徑成立」 10:36。第 8 節的 SDE 擴充技巧則不限高斯,兩者不要混淆。
Demo Ascore 場與轉換公式
- score:用後驗加權平均算(第 3 節),和直接對 \(\log p_t\) 數值微分,預設點都是 \((1.720,1.440)\)。
- 向量場:用後驗加權平均算,和用 \(a_ts+b_tx\) 換算,都是 \((2.520,2.640)\),也就是第 5 節的轉換公式,和第 2 講 Demo B 的讀數相同。
- 拖動 \(t\):\(t\) 小時 score 指向中央的高斯;\(t\) 大時分成三個吸引區。
06Score matching(投影片 13)
現在把上一講的訓練原封不動換成 score。老師說這是定性的複習 12:09。
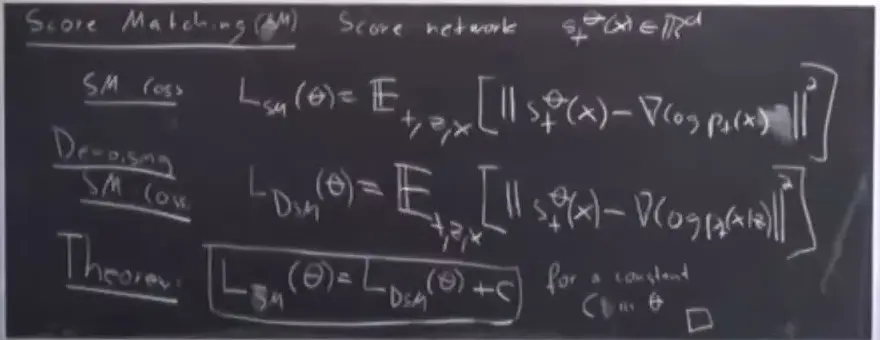
證明不用重做 15:29:邊際 score 和邊際向量場的公式形狀相同,都是「條件量的後驗平均」。第 2 講第 12 節的證明只用到這個形狀,把 \(u^{\text{target}}\) 換成 score 就好。
一點歷史
老師說 score matching 比 diffusion model 早得多 12:40:最早的做法是有人把損失算成可計算的形式,但很貴;幾年後(他印象是 2011 年)才有人提出 denoising 版本,和 denoising autoencoder 有關 17:31。這本來是基礎研究,之後才成為 diffusion model 的關鍵突破。(轉述者補充:最早的 score matching 是 Hyvärinen 2005,denoising 版本是 Vincent 2011,老師記的年份是對的。denoising autoencoder 是把加了雜訊的輸入還原的網路。)CS236 的 第 12 講、第 13 講有詳細的內容。
07去雜訊:網路在預測雜訊(投影片 14–15)
代入 \(x=\alpha_tz+\beta_t\epsilon\),條件 score 大幅簡化 18:32:
$$\begin{aligned}\nabla\log p_t(x\mid z)&=-\frac{x-\alpha_tz}{\beta_t^2}\\&=-\frac{\beta_t\epsilon}{\beta_t^2}=-\frac{\epsilon}{\beta_t}\end{aligned}$$為什麼叫 denoising:\(s_t^\theta\) 其實在預測 \(-\epsilon/\beta_t\)。除了尺度,它就是在猜「加進去的雜訊是什麼」。
數值不穩定,以及 DDPM 的修法
把 \(\beta_t\) 提出來看:
$$\Big\Vert s_t^\theta+\frac{\epsilon}{\beta_t}\Big\Vert^2=\frac{1}{\beta_t^2}\big\Vert\beta_ts_t^\theta+\epsilon\big\Vert^2$$\(t\) 接近 1 時 \(\beta_t\to0\),\(1/\beta_t^2\) 爆掉,那幾筆資料主宰整個損失。例如 \(\beta_t=0.01\) 時權重是 10,000 倍。講義提到,DDPM 的修法是把係數丟掉,並把網路改成預測雜訊:
出處:講義 §4.3。嚴格說,丟掉 \(1/\beta_t^2\) 改變了各個 \(t\) 的相對權重,但因為網路在每個 \(t,x\) 有各自的輸出,最小值點不變(轉述者補充)。Demo C 可以直接比較。
08SDE 擴充技巧
到這裡只是換了說法。現在 score 才真正派上用場 19:02。已知:照邊際向量場的 ODE 走,就跟著 \(p_t\)。問題:如果在 ODE 上加雜訊,還會跟著同一條路徑嗎?
老師問大家 23:29,並先區分:個別軌跡一定不同,這裡問的是 \(X_t\) 的分佈會不會變。他的回答是:直覺上會改變。雜訊在每一點都把東西往四面八方攤開,所以需要在向量場裡加一項來修正,就是 score。
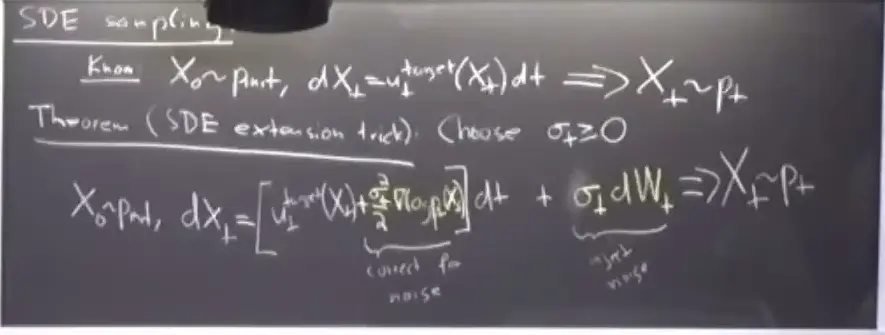
老師說這給了很大的彈性:模型訓練完,\(\sigma_t\) 還可以隨便選,不用重新訓練,一下子多了一整族模型 25:03。
09Fokker–Planck 方程(投影片 16–17)
證明需要連續方程的 SDE 版本 29:00。先定義 Laplacian 30:01:
$$\begin{aligned}\Delta w(x)&=\operatorname{div}(\nabla w)(x)\\&=\sum_{i=1}^d\frac{\partial^2}{\partial x_i^2}w(x)\end{aligned}$$就是把每個方向的二階導數加起來,也等於 Hessian(所有二階偏導數排成的矩陣)的 trace(對角線的和;補充課 A)。
第二項是怎麼來的
老師只給直覺:像熱在介質裡擴散 31:03。講義的附錄有正式證明。下面用一個不用隨機微積分的方式看(轉述者補充)。取一維、\(u=0\),把雜訊想成:每一小段時間 \(h\),粒子以各 1/2 的機率往左或往右跳 \(\Delta\),其中 \(\Delta^2=\sigma^2h\),也就是跳動的變異數是 \(\sigma^2h\)(第 1 講)。
- 帳本:下一刻在 \(x\) 的機率,一半來自左邊、一半來自右邊: $$\begin{aligned}p_{t+h}(x)=\ &\tfrac12p_t(x-\Delta)\\+\ &\tfrac12p_t(x+\Delta)\end{aligned}$$
- Taylor 展開:\(p(x\pm\Delta)\approx p\pm\Delta p'+\tfrac12\Delta^2p''\)。兩式平均,一階項抵消: $$p_{t+h}(x)\approx p_t(x)+\tfrac12\Delta^2p_t''(x)$$
- 除以 \(h\),代入 \(\Delta^2=\sigma^2h\): $$\partial_tp_t(x)=\frac{\sigma^2}{2}p_t''(x)$$
這裡的 \(\tfrac12\) 就是這樣來的,而且雜訊要乘 \(\sqrt h\) 才會讓極限存在。
延伸:補充課 F 的 Fokker–Planck 有完整推導,補充課 C 有粒子計數的例子。
10技巧的證明
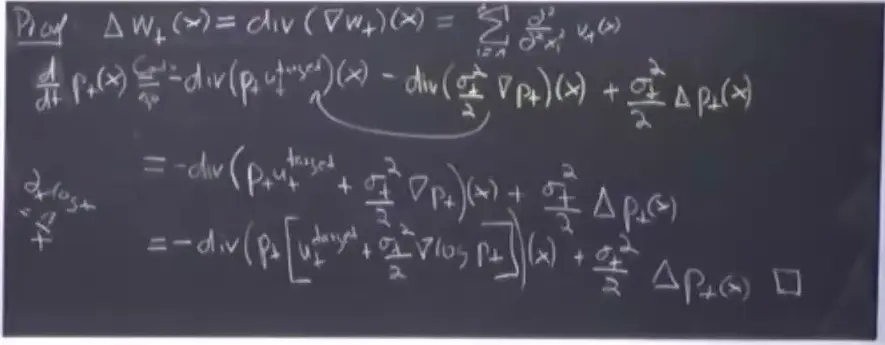
我們要證明:SDE 的向量場 \(u+\frac{\sigma^2}{2}\nabla\log p\),加上 \(\sigma\),讓 \(p_t\) 滿足 Fokker–Planck。整個證明的想法是加一項、減一項 33:15。
- 已知:\(u_t^{\text{target}}\) 和 \(p_t\) 滿足連續方程(第 2 講證的): $$\partial_tp_t=-\operatorname{div}(p_tu_t^{\text{target}})$$
- 加零:同時減去和加上 \(\frac{\sigma_t^2}{2}\Delta p_t\): $$\begin{aligned}\partial_tp_t=&-\operatorname{div}(p_tu_t^{\text{target}})\\&-\frac{\sigma_t^2}{2}\Delta p_t+\frac{\sigma_t^2}{2}\Delta p_t\end{aligned}$$
- 第一個 Laplacian 改寫成 \(\operatorname{div}(\nabla p_t)\) 33:54: $$\begin{aligned}\partial_tp_t=&-\operatorname{div}(p_tu_t^{\text{target}})\\&-\operatorname{div}\Big(\frac{\sigma_t^2}{2}\nabla p_t\Big)+\frac{\sigma_t^2}{2}\Delta p_t\end{aligned}$$
- 用 \(\nabla p_t=p_t\nabla\log p_t\) 35:05,再因為散度是線性的,把兩項併起來: $$\begin{aligned}\partial_tp_t=&-\operatorname{div}\Big(p_t\Big[u_t^{\text{target}}\\&\qquad+\frac{\sigma_t^2}{2}\nabla\log p_t\Big]\Big)\\&+\frac{\sigma_t^2}{2}\Delta p_t\end{aligned}$$
- 對照 Fokker–Planck:這正是向量場 \(u_t^{\text{target}}+\frac{\sigma_t^2}{2}\nabla\log p_t\)、擴散係數 \(\sigma_t\) 的方程。證畢 36:08。
讀出意義:多加的向量場造成的流入,\(-\frac{\sigma^2}{2}\Delta p\),剛好抵銷雜訊造成的 \(+\frac{\sigma^2}{2}\Delta p\)。這也解釋了係數為什麼是 \(\sigma_t^2/2\),不是別的數字。
出處:講義 §4.2 的 Theorem 與證明。
Demo Bscore 修正
- 預設 \(\sigma=1\):粒子貼著黑線,總變異距離(兩個分佈差的絕對值積分再除以 2,0 是相同、1 是完全不重疊) 0.017,方程兩邊差 \(7\times10^{-5}\)。切到只加雜訊:粒子明顯攤開,總變異距離 0.414,方程差 5.2。\(\sigma=2\) 時是 0.032 對 0.602。
- 拖動 \(\sigma\)(\(n=200\)):\(\sigma=0\)、1、2 的總變異距離是 0.021、0.017、0.032,路徑從平滑變成鋸齒,分佈卻不變。這就是定理的內容。
- \(\sigma\) 大時要更多步:\(\sigma=3\) 時,\(n=400\)、100、50、20 的總變異距離是 0.030、0.081、0.175、0.681;\(\sigma=1\)、\(n=20\) 還有 0.044。這是第 12 節說的模擬誤差。
11用 score 取樣(投影片 18–20)
把轉換公式代進 SDE 擴充技巧 38:39,高斯路徑下整條 SDE 只需要 score:
代換只要 \(u_t^{\text{target}}=a_ts+b_tx\),再把 \(\frac{\sigma_t^2}{2}s\) 併進 \(s\) 的係數。學到的是向量場時,反過來寫也可以(講義的總結):
$$\begin{aligned}\mathrm dX_t=\Big[&\Big(1+\frac{\sigma_t^2}{2a_t}\Big)u_t^\theta(X_t)\\&-\frac{\sigma_t^2b_t}{2a_t}X_t\Big]\mathrm dt+\sigma_t\,\mathrm dW_t\end{aligned}$$12為什麼要用 SDE(投影片 21)
理論說所有 \(\sigma_t\) 都走同一條路徑,那何必選?老師 40:11:理論和實務有落差。
- 訓練誤差:網路沒有完美學到向量場或 score。
- 模擬誤差:微分方程要離散化。
有了誤差,不同 \(\sigma\) 的表現就會不同。老師在黑板畫了一條「效能對 \(\sigma\)」的曲線,說理論已經無法告訴你哪個最好,只能實際掃過去試 41:42。講義也註明,「最佳 \(\sigma_t\)」是訓練不完美和計算有限造成的,不是連續極限下的理論性質。
講義另有一個選讀的 Remark:GLASS Flows(Holderrieth 等人 2025)用一個取樣技巧,只靠 ODE 就得到和 SDE 相同的隨機轉移。課堂沒講,這裡只提名字。
老師的結論 42:14:ODE 取樣常常已經很接近最好,用 flow 取樣就能走很遠。SDE 主要在一些下游應用比較重要,對我們來說是不用重新訓練就多出來的工具。下面的 Demo C 正好有一個 SDE 比 ODE 好的小例子,不過那是這個小網路的結果,不代表一般情況。
Demo C訓練 score 網路
和第 2 講的 Demo D 同樣的資料與網路(六群高斯,每群標準差 \(s=0.3\);「落在中心附近」指離最近的中心不到 \(3s\)),只是目標換成雜訊。取樣用第 11 節的式子,\(s=-\epsilon_t^\theta/\beta_t\)。因為 \(a_t,b_t\) 在 \(t=0\) 爆掉、\(\beta_t\) 在 \(t=1\) 為 0,每一步的時間取區間中點來避開這兩端。
- 不加權:預測雜訊的誤差降到 0.987,\(\sigma=0\)、\(n=100\) 時 85.2% 落在中心附近(真實資料 98.9%)。
- 切到原始 DSM:權重 \(1/\beta_t^2\) 讓損失被 \(t\) 接近 1 的少數資料主宰,訓練後誤差是 3.387,取樣 0.0% 落在中心附近,網路等於沒學好。這就是投影片 15 的紅字。兩者的數學目標相同,差別完全在數值。
- 同一個訓練好的網路(不加權),拖動 \(\sigma\)(\(n=100\)):0、0.5、1、1.5、2 分別是 85.2%、88.0%、91.7%、91.2%、61.9%。這個例子有個最佳的 \(\sigma\) 在 1 附近,正是第 12 節的黑板圖。\(\sigma=2\) 時步數不夠:\(n=20\) 是 29.0%,\(n=200\) 回到 73.2%。\(n\ge20\) 時各群比例差大約 0.12–0.20,比第 2 講用 flow matching 訓練的 0.05 大,所以「落在中心」好不代表比例也對。
13Langevin 動力學(投影片 22)
老師說這是給物理和化學背景同學的題外話 42:45。把 SDE 擴充技巧用在完全不動的路徑 \(p_t=p\):密度不變,所以 \(u_t^{\text{target}}=0\),剩下
老師說他不是統計物理學家,不想講太細,只說 \(U\) 是能量或位能 44:20。補一行計算:\(\nabla\log p=-\nabla U\),所以漂移是沿著負能量梯度走,物理上就是力,再加上熱擾動。
講義的 Remark 補充:\(p\) 是高斯時就是 OU 過程(第 10 節的手算)。在溫和的條件下,即使不是從 \(p\) 出發,分佈也會收斂到 \(p\),這也是許多 MCMC 方法(用 Markov 鏈抽樣的方法)的基礎。
延伸:補充課 F 的 Langevin、CS236 第 12 講。
Demo DLangevin
- 從 \(p\) 出發:分佈不動,這就是平衡。\(\sigma=1\)、\(T=5\) 時總變異距離 0.037,右峰比例 30.4%;\(\sigma=2\)、\(T=20\) 時是 0.033、29.9%。
- 全部從 3.5 出發:\(\sigma=1\) 時,右峰比例在 \(T=1\)、5、20 是 100.0%、85.7%、49.0%;\(\sigma=2\)、\(T=20\) 就到 30.0%。粒子要穿過兩峰之間的低谷,這段很慢。
- \(\sigma=0\) 時沒有雜訊,也沒有漂移(係數 \(\sigma^2/2\) 也是 0),粒子完全不動。\(\sigma=0.5\)、\(T=20\) 還有 85.9% 留在右邊。理論上會收斂,但實際上可能要等很久。
14總結(投影片 23–24)
| 向量場 | Score | |
|---|---|---|
| 條件(高斯) | \(\big(\dot\alpha_t-\frac{\dot\beta_t}{\beta_t}\alpha_t\big)z+\frac{\dot\beta_t}{\beta_t}x\) | \(\frac{\alpha_t}{\beta_t^2}z-\frac{1}{\beta_t^2}x\) |
| 邊際 | 條件的後驗平均 | 條件的後驗平均 |
| 損失 | \(L_{\text{CFM}}\),目標 \(\dot\alpha_tz+\dot\beta_t\epsilon\) | \(L_{\text{DSM}}\),目標 \(-\epsilon/\beta_t\) |
| 取樣 | ODE | 可以用來做 SDE(任意 \(\sigma_t\)) |
老師預告 44:51:score 最酷的應用還在後面,也就是下半段的 classifier-free guidance。
和其他頁面的關聯
- CS236 第 12 講:score matching 和 Langevin。第 13 講:denoising score matching、Tweedie。
- CS236 第 16 講:\(\epsilon\) 預測和 \(L_{\text{simple}}\),就是第 7 節的 DDPM 損失。那邊的 \(\lambda_t\) 是同一個權重問題。
- 書 B06(DSM)、B16(四種預測的等價):第 5 節的完整版本。
- 補充課 F:Fokker–Planck 和 Langevin。
常見誤解
- 「Score 是對參數的梯度。」在統計裡 score 常指對參數的梯度。這裡是對 \(x\) 的梯度。
- 「轉換公式對所有路徑都成立。」只對高斯路徑。第 3 節的後驗平均和 SDE 擴充技巧才是一般的。
- 「SDE 取樣要重新訓練。」不用。\(\sigma_t\) 是訓練後才選的。
- 「加雜訊之後分佈一定會變。」只加雜訊會變,加了 score 修正就不變(Demo B)。
- 「SDE 一定比 ODE 好。」理論上相同。實務上老師說 ODE 常常就很好,要看訓練和模擬誤差。
- 「DSM 是另一種模型。」只是換一個訓練目標,高斯路徑下學到的東西等價。
- 「\(\sigma_t\) 越大越好,反正都正確。」\(\sigma\) 越大,模擬需要的步數越多(Demo B)。
- 「\(\epsilon\) 預測和 \(1/\beta_t^2\) 加權完全一樣。」理論上最小值點相同,實際訓練差很多(Demo C)。
自我測驗
1. \(q=\mathcal N(\mu,\tau^2)\) 的 score 是什麼?
2. 算 score 為什麼不用知道正規化常數?
3. 用兩行推出邊際 score 是條件 score 的後驗平均。
4. 直線排程的 \(a_t,b_t\) 是什麼?用它們驗證條件向量場。
5. 代入 \(x=\alpha_tz+\beta_t\epsilon\) 後,條件 score 變成什麼?為什麼叫 denoising?
6. \(\beta_t=0.1\) 和 \(\beta_t=1\) 的資料,在原始 DSM 損失裡權重差多少?DDPM 怎麼處理?
7. 寫出 SDE 擴充技巧,指出哪一項是修正。
8. 證明的關鍵一步是什麼?
9. \(p=\mathcal N(0,1)\),在 \(x=0\) 和 \(x=3\),純擴散讓密度升還是降?
10. 理論上所有 \(\sigma_t\) 都相同,為什麼實務上不同?
11. Langevin 動力學是 SDE 擴充技巧的什麼特例?\(p=\mathcal N(0,1)\) 時是什麼過程?
12. 為什麼 \(t\to0\) 時無法從 score 換回向量場?
延伸閱讀
- Holderrieth & Erives,An Introduction to Flow Matching and Diffusion Models,§4 Score Functions and Score Matching:本頁的定義、定理和證明都對照過 TeX 原文。
- 課程網站的 Lab 1(Langevin)、Lab 2(score matching)。
- 補充課 F Fokker–Planck 與 Langevin。
- CS236 第 13 講、書 B06:denoising score matching 的其他角度。