Classifier-Free Guidance:讓模型聽提示詞的話
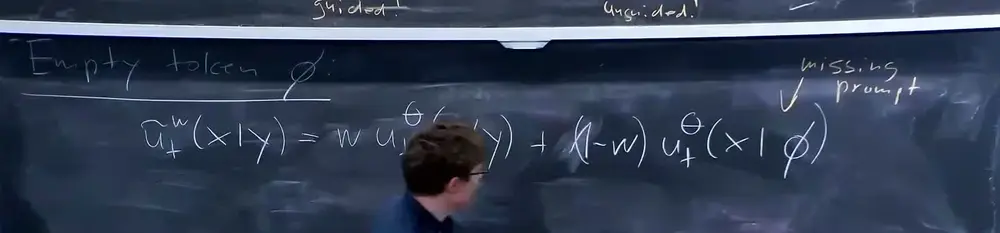
直接把提示詞餵給網路,結果卻不夠貼題。解法是放大「和提示詞有關的那一部分」:\(\tilde u=(1-w)u(x\mid\varnothing)+w\,u(x\mid y)\)。公式來自分類器,卻完全不需要分類器。代價是生成的分佈已經不再是資料分佈。
讀完這頁你應該能夠
- 寫出 vanilla guidance 的訓練和取樣,說明它和無條件版本只差哪裡。
- 用 Bayes 定理,把 \(u(x\mid y)\) 拆成 \(u(x)\) 加上分類器的梯度。
- 解釋 classifier guidance 的兩個困難。
- 一步一步推出 CFG 的公式,並用數字驗算。
- 寫出 CFG 的訓練和取樣演算法,說明丟標籤和每步呼叫兩次的原因。
- 說明 \(w\gt1\) 時為什麼不再是從資料分佈取樣,以及它的好處和壞處。
前置知識檢查
這一頁怎麼讀、記號
逐字稿是 YouTube 自動字幕,有疑問時以黑板和投影片為準。部分學生的提問麥克風沒收到,那些問答的標題是從老師的重述和回答推測的。
| 記號 | 意思 |
|---|---|
| \(y\)、\(\mathcal Y\) | 提示詞或類別標籤;\(\mathcal Y\) 是所有可能的 \(y\) 的集合,例如所有文字,或有限個類別。講義對它沒有任何限制 |
| \(u_t^{\text{target}}(x\mid z)\) | 條件向量場(有公式),訓練目標 |
| \(u_t^{\text{target}}(x\mid y)\) | 導引(guided)向量場:只看提示詞為 \(y\) 的資料的邊際向量場 |
| \(u_t^{\text{target}}(x)\)、\(u_t^{\text{target}}(x\mid\varnothing)\) | 無導引的向量場,後者用空標籤 \(\varnothing\) 表示 |
| \(\tilde u_t(x\mid y)\) | 放大後的向量場 |
| \(w\) | guidance scale,\(w=1\) 是不放大 |
| \(a_t,b_t\) | 上半段的轉換係數,\(u=a_t\nabla\log p_t+b_tx\) |
CS236 對照:第 17 講的 conditional 一節用 score 寫同一件事。\(w\) 的定義差 1:CS236 第 17 講和 Ho & Salimans 的論文都寫成 \((1+w)\epsilon_\theta(\cdot,y)-w\epsilon_\theta(\cdot)\),所以那邊的 \(w=0\) 才是不放大,等於這門課的 \(w=1\)。
01為什麼要 guidance(投影片 24–25)
到目前為止模型只會「生成一張圖」。實際上我們要的是「生成一張蔬菜做的車」 00:09。
數學上,就是從 \(p_{\text{data}}(\cdot\mid y)\) 取樣,而且一個模型要能處理任何 \(y\),不是每個提示詞訓練一個。
02Vanilla guidance(投影片 26)
最直接的做法:把提示詞多餵給網路 01:11。
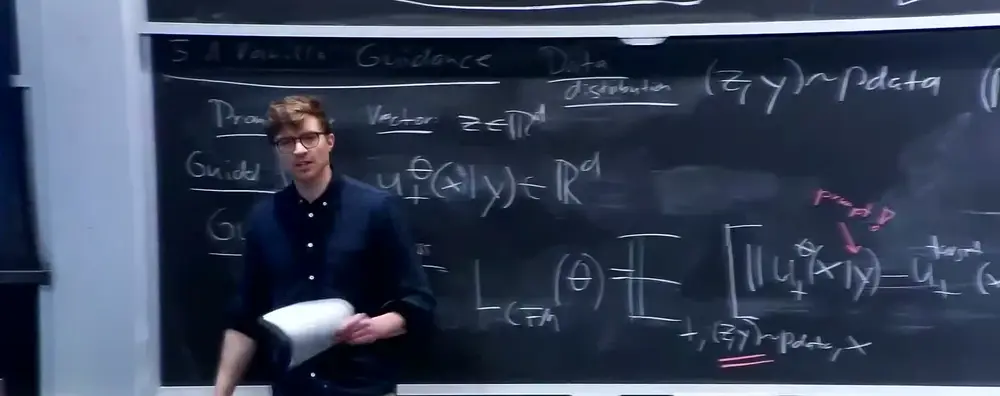
- 資料變成成對的:\((z,y)\sim p_{\text{data}}\),例如圖片和它的說明文字。寫成程式,就是每個 batch 同時回傳 \(z\) 和 \(y\)。
- 網路多一個輸入:\(u_t^\theta(x\mid y)\),也就是輸入 \((x,y,t)\)、輸出 \(\mathbb R^d\) 的向量。
- 損失幾乎不變: $$\begin{aligned}&L_{\text{CFM}}^{\text{guided}}(\theta)\\&=\mathbb E\big[\Vert u_t^\theta(x\mid y)-u_t^{\text{target}}(x\mid z)\Vert^2\big]\end{aligned}$$ 其中 \((z,y)\sim p_{\text{data}}\)、\(t\sim\mathrm{Unif}\)、\(x\sim p_t(\cdot\mid z)\)。
為什麼這樣就對(講義的論證):固定一個 \(y\),把 \(p_{\text{data}}(\cdot\mid y)\) 當成資料分佈,就回到上一講的問題,訓練目標還是條件向量場。再對所有 \(y\) 取期望值,就是上面的式子。網路看得到 \(y\) 但看不到 \(z\),所以學到的是「在提示詞 \(y\) 下」的邊際向量場。
老師說,取樣完全不變,只是每一步都把提示詞餵給網路 04:48。如果世界完全符合理論,這一節就結束了。
03結果不夠好(投影片 27)
老師 05:19:理論上應該已經完成了,實際上卻不理想。我們必須想辦法強化提示詞。
講義列的可能原因:模型欠擬合(underfit,模型太弱或訓練不夠),沒有真的學到邊際向量場;資料本身也不完美,網路上的圖文配對有很多錯誤。後者在 Demo B 會看到。
04Classifier guidance(投影片 28–29)
要去掉分類器,得先有分類器 08:36。
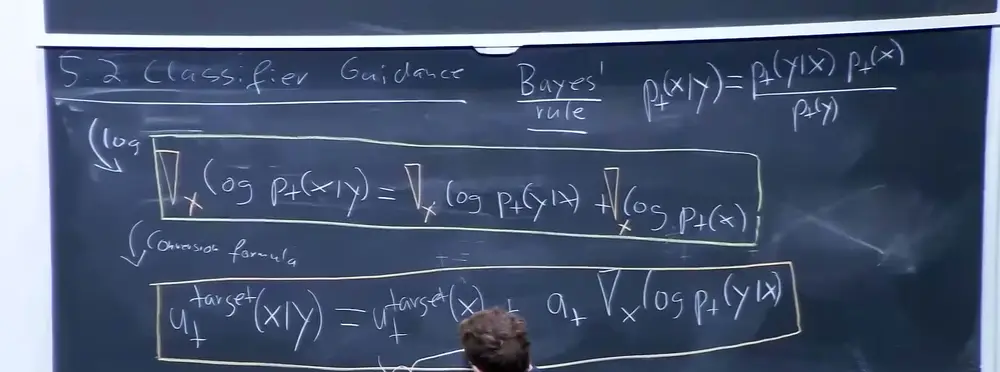
推導
- Bayes 定理(\(x\) 是時間 \(t\) 的有雜訊影像,所以機率都帶下標 \(t\)。這裡和講義一樣用高斯機率路徑,轉換公式才有現成的 \(a_t,b_t\)):$$p_t(x\mid y)=\frac{p_t(y\mid x)\,p_t(x)}{p_t(y)}$$
- 取對數 10:09: $$\begin{aligned}&\log p_t(x\mid y)\\&=\log p_t(y\mid x)+\log p_t(x)\\&\quad-\log p_t(y)\end{aligned}$$
- 對 \(x\) 取梯度:\(\log p_t(y)\) 不含 \(x\),消失: $$\begin{aligned}\nabla\log p_t(x\mid y)=\ &\nabla\log p_t(y\mid x)\\&+\nabla\log p_t(x)\end{aligned}$$ 導引的 score = 分類器的梯度 + 無導引的 score。
- 用轉換公式 \(u=a_t\nabla\log p_t+b_tx\)(對 \(p_t(\cdot\mid y)\) 也成立,因為固定 \(y\) 就是把它當資料分佈): $$\begin{aligned}u(x\mid y)&=a_t\nabla\log p_t(x\mid y)+b_tx\\&=a_t\nabla\log p_t(y\mid x)\\&\quad+a_t\nabla\log p_t(x)+b_tx\end{aligned}$$ 後兩項加起來就是 \(u(x)\):
為什麼 \(p_t(y\mid x)\) 叫分類器 14:23:給一張圖 \(x\),告訴你它是類別 \(y\) 的機率。所以第二項是沿著「讓分類器更相信這是 \(y\)」的方向走。
- 導引 score:\(\mathcal N(1,1)\) 的 \(\log p\) 是 \(-\frac{(x-1)^2}{2}\) 加常數,微分得 \(-(x-1)\),在 0 是 1。
- 無導引 score:\(p(x)\) 是兩個高斯各半的混合,對 0 左右對稱,頂點或谷底的斜率是 0,所以 score 是 0。
- 分類器:Bayes 定理給 \(p(+\mid x)=\frac{p(x\mid+)}{p(x\mid+)+p(x\mid-)}\)(機率各半,\(\tfrac12\) 約掉)。兩個高斯相除,\(\frac{p(x\mid-)}{p(x\mid+)}=e^{\frac{(x-1)^2-(x+1)^2}{2}}=e^{-2x}\),所以 \(p(+\mid x)=\frac{1}{1+e^{-2x}}\)。取 log 是 \(-\log(1+e^{-2x})\),微分得 \(\frac{2e^{-2x}}{1+e^{-2x}}\),在 0 是 1。
放大它
現在做那個直覺的動作 15:54:既然圖不夠貼題,就把和提示詞有關的那部分放大。
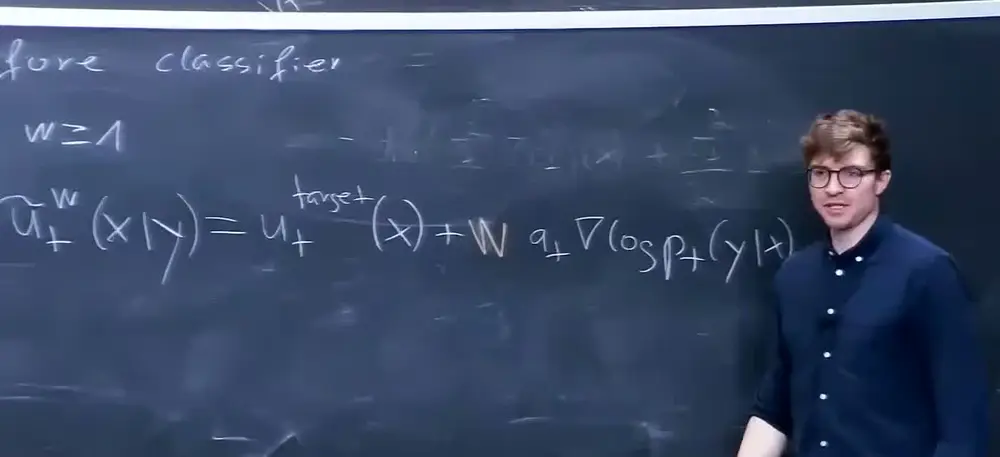
為什麼不是故事的結尾
有學生答出:要多訓練一個分類器 18:38。老師補充:
- 兩個模型,工作量加倍。
- 不能用現成的分類器,因為 \(x\) 是有雜訊的資料,要在有雜訊的影像上訓練。
- \(y\) 是文字時不是一個類別,而是一長串文字,這個機率和它的梯度可能都很難算。
老師說過去真的有人這樣做,diffusion model 有一段時間就是這樣導引的,現在已經不太用了 18:07。講義引用的是 Dhariwal & Nichol (2021) 和 Song et al. (2021),也說它大致已經被 CFG 取代。
05去掉分類器(投影片 30–31)
目標:不訓練分類器,達到同樣的效果 19:39。簡稱 CFG,論文裡常見。
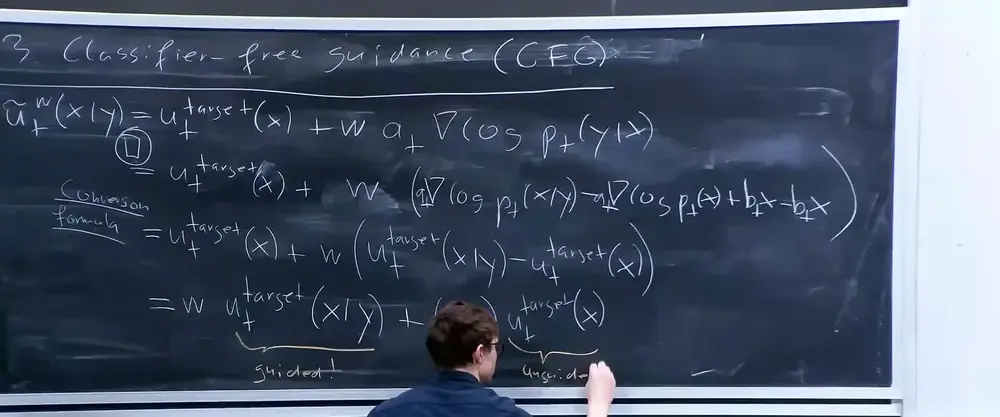
推導
只用上一節的那條 score 等式,把分類器解出來:\(\nabla\log p_t(y\mid x)\) 等於 \(\nabla\log p_t(x\mid y)-\nabla\log p_t(x)\)。
- 代入 22:43: $$\begin{aligned}\tilde u=u(x)+w\,a_t\big(&\nabla\log p_t(x\mid y)\\&-\nabla\log p_t(x)\big)\end{aligned}$$
- 加減 \(w\,b_tx\),湊出轉換公式 23:13: $$\begin{aligned}\tilde u=\ &u(x)\\&+w\big(a_t\nabla\log p_t(x\mid y)+b_tx\big)\\&-w\big(a_t\nabla\log p_t(x)+b_tx\big)\end{aligned}$$
- 認出向量場 23:43:兩個括號分別是 \(u(x\mid y)\) 和 \(u(x)\): $$\tilde u=u(x)+w\big(u(x\mid y)-u(x)\big)$$
- 整理:
課堂 23:13 那一步老師先寫錯,隨即改成把 \(a_t\) 放進括號,上面是修正後的版本。
老師問:這個公式哪裡驚人? 24:45 裡面只有向量場,沒有分類器了。我們從分類器的直覺出發,最後卻不用學它。那個分類器完全是假想的 28:51。
- classifier guidance:\(0+4\times1=4\)。
- CFG:\((1-4)\times0+4\times1=4\)。
Demo A同一個向量,兩種算法
- 讀數最後兩行是同一個向量的兩種算法:一行把分類器 \(p_t(A\mid x)\) 真的算出來再取數值微分,一行只用兩個向量場。預設點都是 \((-4.625,10.030)\)。這就是第 5 節的推導。
- \(w=1\) 時兩行都變成 \(u(x\mid A)=(-1.000,3.400)\),也就是 vanilla guidance。
- 預設點的分類器機率是 0.433,還不太確定。\(w=3\) 時 \(\tilde u\) 比 \(u(x\mid A)\) 長得多,方向也更偏離其他類別:放大的是「怎樣更像 A」這個方向。
06一個網路、空標籤
分類器沒了,但公式裡有兩個向量場,感覺還是要訓練兩個模型?老師說最後一步是個很簡單的技巧 26:34:定義一個空標籤 \(\varnothing\),代表「不告訴你提示詞」,並令
$$u_t(x)=u_t(x\mid\varnothing)$$例如類別是 10 個數字時,就多一個第 11 類。老師的說法是定義一個額外的類別,模型不該知道提示詞時就給它這個類別。
老師 29:57:\(w=4\) 的狗非常貼題。實際上所有模型都用它,沒有它根本不行。講義也說,幾乎所有 AI 生成的圖和影片都大量使用 CFG,\(w\ge4\)。
07訓練與取樣(投影片 32–33)
訓練只要改一行:有時候不告訴模型提示詞 30:27。
- 抽一對 \((z,y)\),抽 \(t\),抽 \(\epsilon\);令 \(x=\alpha_tz+\beta_t\epsilon\)。
- 以機率 \(\eta\) 令 \(y\leftarrow\varnothing\)。
- 損失 \(\Vert u_t^\theta(x\mid y)-(\dot\alpha_tz+\dot\beta_t\epsilon)\Vert^2\),梯度下降。
老師舉的例子是 20% 的時間不給提示詞。網路要學會有提示詞時跟著走,也要學會沒提示詞時怎麼辦。改動非常小,所以才這麼好用,全部包在同一個訓練裡 31:28。
為什麼 \(y=\varnothing\) 學到的正好是 \(u(x)\):丟標籤是隨機決定的,和 \(z\) 無關,所以 \(y=\varnothing\) 的那些資料,就是從整個資料分佈 \(p_{\text{data}}(z)\) 抽的。對這批資料做回歸,等於第 2 講沒有提示詞的訓練,學到的就是無導引的邊際向量場。(這段是轉述者補充,講義只說把 \(\varnothing\) 當成「沒有條件」。)
- 選提示詞 \(y\) 和 \(w\gt1\);抽 \(X_0\sim p_{\text{init}}\)。
- 模擬 \(\mathrm dX_t=\tilde u_t^\theta(X_t\mid y)\,\mathrm dt\),也就是每一步都用上面那個加權的向量場。
- 回傳 \(X_1\)。
講義的 Remark:擴充到 SDE 時,把 \(u_t^\theta(x\mid y)\) 換成 \(\tilde u_t^\theta(x\mid y)\) 就好。\(\tilde u=(1-w)u+wu(\cdot\mid y)\) 這個構造也對任何機率路徑都有意義,高斯只是用來看出分類器的直覺。
08CFG 是 heuristic(投影片 36–37)
有學生問:這在理論上站得住腳嗎?到底是從什麼分佈取樣? 33:33 老師的回答:它是一個 heuristic(經驗法則:有道理、也好用,但沒有嚴格的保證)。
老師的解讀 34:03:可以想成把分佈往定義這個類別的眾數(mode,機率密度最高的地方)推。他還提到一個有趣的現象 34:34:測量文字和圖片的吻合程度,現代模型生成的結果可能比網路上隨機的圖文配對還好。網路資料有錯誤的說明文字,模型某種意義上超越了它。代價是不再從同一個分佈取樣,多樣性會下降。
所以老師的結論是:「從資料分佈取樣」是個好的建模假設,但要知道它只是近似,CFG 已經超出了它。
口頭的小問題:33:01 老師說 Stable Diffusion 3 的 \(w=4\) 是把貢獻「放大三倍,因為 4−1」。依公式,和提示詞有關的項乘的是 \(w=4\),相對於沒有放大的 \(w=1\) 是 4 倍。3 倍是多出來的部分,因為 $$\begin{aligned}\tilde u=\ &u(x\mid y)\\&+(w-1)\big(u(x\mid y)-u(x)\big)\end{aligned}$$
Demo Bw 會做什麼
- 標籤錯誤率 20%:\(w=1\) 時 82.0% 落在 A 群,就是資料裡的 80%(\(w=1\) 忠實重現資料);\(w=2\) 是 97.3%,\(w=4\) 是 100.0%。這就是老師說的比資料還貼題。\(w=0\) 不看提示詞,35.0%,就是三群之一(1,200 個粒子的抽樣誤差讓它不剛好是 33.3%)。
- 副作用:到原點的平均距離從 2.64(\(w=1\))變成 3.32(\(w=4\))、4.04(\(w=10\)):粒子在遠離另外兩群,\(w=10\) 時平均已經跑到圓圈(中心 2.6、半徑 1,也就是到原點 3.6)之外。該群的標準差從 0.50 降到 0.35、0.30,多樣性下降。這和投影片 37 的圖一樣。
- 把錯誤率設成 0:\(w=1\) 已經 100.0%,\(w=4\) 沒有好處,只有扭曲(距離 3.50、標準差 0.33)。錯誤率 50% 時,\(w=1\) 是 51.3%,\(w=4\) 是 85.8%。
09課堂問答與代價
CFG 的代價
老師問大家它有什麼缺點。學生的回答麥克風沒收到,老師接著說:對,這個方法主要靠好的實驗結果來證明 36:04,這是我們得接受的。他再補一個實際的 37:34:每一步要呼叫網路兩次,一次有提示詞、一次沒有,所以效率減半。可以接受,但要記得。
| Vanilla | Classifier guidance | CFG | |
|---|---|---|---|
| 要訓練的模型 | 1 | 2(含有雜訊資料上的分類器) | 1(丟標籤) |
| 每步呼叫網路 | 1 | 1 + 分類器梯度 | 2 |
| 文字提示詞 | 可以 | 很難 | 可以 |
| 取樣自 \(p_{\text{data}}(\cdot\mid y)\) | 理論上是 | \(w\gt1\) 時不是 | \(w\gt1\) 時不是 |
Demo C親手訓練 CFG
和 Demo B 同樣的資料,這次真的訓練:網路輸入多了 4 維的 one-hot(只有一個位置是 1、其他是 0 的向量;四個位置是 A、B、C、\(\varnothing\)),每筆資料有 20% 機率把標籤換成 \(\varnothing\)。3,000 步,電腦上大約 11 秒,手機可能更久。取樣 30 步,每步呼叫網路兩次。
- 標籤錯誤率 20%(預設):提示詞 A,\(w=0\)、1、2、4、8 的正確比例是 33.0%、78.8%、95.6%、99.8%、100.0%,平均距離是 2.52、2.48、2.73、3.16、4.17。正確比例和 Demo B 用公式算的幾乎相同,代表網路真的學到了;距離比公式(2.64、2.90、3.32、3.84)多少有差,\(w=8\) 差最多,約 0.33。
- 標籤完全正確:同樣的 \(w\) 是 32.0%、100.0%、100.0%、100.0%、100.0%。這個簡單資料在 \(w=1\) 就已經正確。真實影像上 vanilla guidance 為什麼不夠貼題,除了標籤錯誤還有欠擬合(模型太弱或訓練不夠,沒學到真正的向量場;講義),這個小例子沒有呈現後者。
- 標籤完全正確時,\(w\) 大的距離和公式差很多:\(w=4\)、8 訓練出來是 3.03、2.81,同樣 30 步的公式向量場是 3.52、4.12。原因可能是粒子被推到訓練資料很少的地方,網路在那裡不準;我沒有進一步驗證。比例不受影響,但這提醒你,大 \(w\) 時網路給的向量場不一定可靠。
10沒講到的投影片(投影片 38–46)
老師說文獻導覽留到下週 37:34。投影片 38–43 是「A guide to the diffusion literature」:時間慣例、加雜訊的幾種說法、前向 SDE 與反向 SDE、flow matching 能連接任意分佈。這一批和第 4 講投影片 35–39 內容相同,放在第 4 講的文獻導覽處理。
老師的預告 38:04:週一講架構和 latent space,把模型放大成真的影像生成器。最後一堂是選修性質的進階主題:離散 diffusion 和 distillation。投影片 46 是參考文獻。
編號的小問題:投影片 15 和 32 都叫 Algorithm 5。投影片 24 標「Section 6」、38 標「Section 5」,順序顛倒,講義的 Guidance 是 §5。黑板也一樣,前兩節寫 5.1、5.2,CFG 卻寫 6.3。
和其他頁面的關聯
- CS236 第 17 講:classifier guidance 和 CFG 的 score 版本。
- 書 B21(§8.1–8.3):同一個主題,有更多細節。
常見誤解
- 「Classifier-free 就是不需要分類器的概念。」推導仍然從分類器出發,只是不用訓練它。那個分類器是假想的。
- 「CFG 更準確地從 \(p_{\text{data}}(\cdot\mid y)\) 取樣。」相反,\(w\gt1\) 時就不是從它取樣了。\(w=1\) 才是。
- 「要訓練兩個網路。」一個就夠,丟標籤讓同一個網路同時學會有條件和沒條件。
- 「\(p(x)\,p(y\mid x)^w\) 就是 CFG 生成的分佈。」那只是單一時刻的 score 的形狀,\(X_1\) 一般不服從它(第 8 節的驗算)。
- 「\(w\) 是訓練時決定的。」\(w\) 是取樣時才選的,訓練時只有丟標籤的機率。
- 「\(w\) 越大越好。」太大時會飽和、塌縮,多樣性消失,甚至跑到資料範圍之外(Demo B)。
- 「條件向量場的 \(z\) 和提示詞 \(y\) 是一樣的。」\(u(x\mid z)\) 是訓練目標,\(u(x\mid y)\) 是網路要學的邊際向量場。
- 「\(1-w\) 是負的,所以公式錯了。」負號正是重點:減去無導引的方向,就是放大兩者的差。
自我測驗
1. Vanilla guidance 和無條件的 flow matching 只差哪兩處?
2. 為什麼 \(\nabla\log p_t(y)\) 是 0?
3. 寫出 \(u(x\mid y)\) 的分解,說明每一項。
4. Classifier guidance 的兩個主要困難?
5. 從 \(\tilde u=u(x)+wa_t\nabla\log p_t(y\mid x)\) 推到 CFG 公式。
6. \(u(x\mid y)=(2,0)\)、\(u(x\mid\varnothing)=(1,1)\)、\(w=3\),\(\tilde u\) 是多少?
7. \(w=0\)、\(w=1\) 分別是什麼?
8. 訓練時為什麼要丟標籤?不丟會怎樣?
9. 取樣 100 步、\(w=4\),要呼叫網路幾次?
10. 老師為什麼說 CFG 是 heuristic?
11. 為什麼生成結果可能比資料更貼題?
延伸閱讀
- Holderrieth & Erives,An Introduction to Flow Matching and Diffusion Models,§5 Guidance:本頁的推導對照過 TeX 原文。
- Ho & Salimans,Classifier-Free Diffusion Guidance:投影片 27、34、35、37 的圖都出自這篇。
- 課程網站的 Lab 3。
- CS236 第 17 講、書 B21。