Latent Space 與網路架構:把模型放大成真的影像生成器
前三講的演算法都只有數學。這一講解決實務上的兩件事:180 萬維的影像怎麼處理(先用 VAE 壓進 latent space),以及 \(u_t^\theta(x\mid y)\) 這個網路到底長什麼樣(diffusion transformer)。最後看 Stable Diffusion 3 和 Meta MovieGen 怎麼把這些全部放在一起。
讀完這頁你應該能夠
- 說明 diffusion model 為什麼比分類器更怕高維,以及兩個原因。
- 解釋只有重建損失的自編碼器為什麼不夠。
- 推出高斯解碼器的負對數概似就是均方誤差,以及兩個高斯之間的 KL。
- 寫出 VAE 損失,說明 \(\beta\) 怎麼取捨,太大時會發生什麼事。
- 用一個數字例子解釋 reparameterization trick 為什麼必要。
- 說出 latent diffusion 的五個步驟。
- 算出時間嵌入的長度和 patch 的數量,手算一次 scaled dot-product attention。
- 說明 DiT 區塊怎麼把影像、文字、時間放進去。
- 看懂論文裡不同的時間慣例、forward process、time reversal 和這門課的對應。
前置知識檢查
- 前幾講:flow matching 的訓練、CFG。
- 高斯密度:$$\begin{aligned}&\mathcal N(x;\mu,\sigma^2I_d)\\&=(2\pi\sigma^2)^{-d/2}\\&\quad\cdot\exp\Big(-\frac{\Vert x-\mu\Vert^2}{2\sigma^2}\Big)\end{aligned}$$
- 變異數的展開(第 5 節會用到):$$\begin{aligned}&\mathbb E[(X-c)^2]\\&=\mathrm{Var}(X)+(\mathbb E[X]-c)^2\end{aligned}$$
- 矩陣乘法、softmax:softmax 把一列數字 \(s_i\) 變成 \(e^{s_i}/\sum_je^{s_j}\),全部是正的,加起來是 1。
- CS236(選讀):第 5 講、第 6 講從 ELBO 的角度講 VAE。
這一頁怎麼讀、記號
| 記號 | 意思 |
|---|---|
| \(x\in\mathbb R^d\)、\(z\in\mathbb R^k\) | 資料、latent,\(k\lt d\) |
| \(\mu_\phi,\sigma_\phi\) | 編碼器輸出的平均和標準差,參數 \(\phi\) |
| \(\mu_\theta\) | 解碼器輸出的平均,參數 \(\theta\) |
| \(\beta\) | VAE 裡 prior loss 的權重。和排程 \(\beta_t\) 無關 |
| \(N,S,L\) | patch 數、提示詞長度、transformer 層數(投影片和講義的 \(N\) 有混用,見第 11 節) |
| \(P\) | patch 的邊長 |
和 CS236 相同的地方:編碼器 \(\phi\)、解碼器 \(\theta\);Lai 的書相反。逐字稿是 YouTube 自動字幕,有疑問時以黑板和投影片為準。部分學生的提問麥克風沒收到,那些問答的標題是從老師的重述和回答推測的。
01為什麼需要 latent space(投影片 1–9)
開場老師先為週一因為暴風雪停課道歉 00:08。今天要放大前面的東西,還缺兩塊:latent space 和網路架構。
老師指著照片的黑色區域 02:10:這個像素是黑的,隔壁也是黑的,給你一半的像素,你就能補出另一半。我們想專注在語意上有意義的部分,不是之後可以補上的細節。
- 輸出也是高維:向量場 \(u_t^\theta:\mathbb R^d\to\mathbb R^d\),輸入輸出都是 180 萬維。ImageNet 分類器只輸出 1,000 維。
- 要呼叫很多次:取樣時要跑網路 50 到 100 次。
投影片筆誤:投影片 1 寫「IAP 2026 | Jan 28, 2025」,年份應該是 2026。
02自編碼器(投影片 10–11)
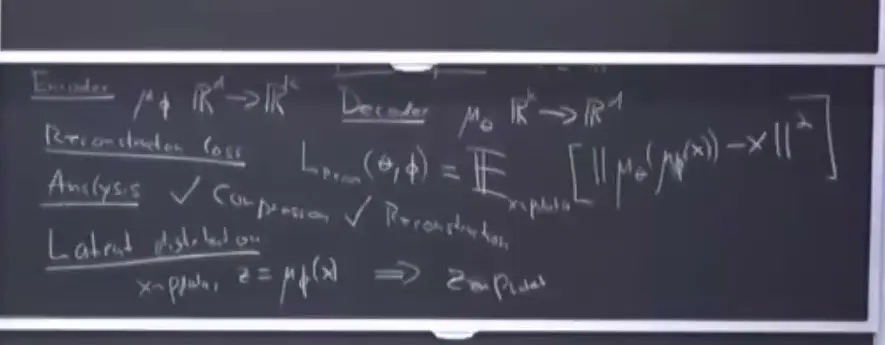
板書筆誤:黑板和投影片 11 一開始寫 \(k\lt n\),學生指出來後老師改成 \(k\lt d\) 06:16。投影片的 \(n\) 沒有改。
03自編碼器的問題(投影片 12)
檢查一下 08:51:壓縮,有;重建,有。但老師強調:我們做這件事不是為了自編碼器本身,是為了之後在 latent 上訓練 diffusion model。
把所有資料編碼得到的分佈叫 latent 分佈:\(x\sim p_{\text{data}},\ z=\mu_\phi(x)\Rightarrow z\sim p_{\text{latent}}\)。重建損失完全沒有管它長什麼樣。
壓縮成功了,第二步卻變難了 10:57。學生後來問「可訓練」是什麼意思,老師說很難形式化,就是指:在這個 latent space 上訓練 diffusion model 會不會容易 33:07。
04VAE:編碼變成機率
為了能討論 latent 的分佈,先把編碼和解碼都變成機率的 12:35。老師提醒:這裡只把 VAE 當成做 latent diffusion 的工具,不是當生成模型本身。
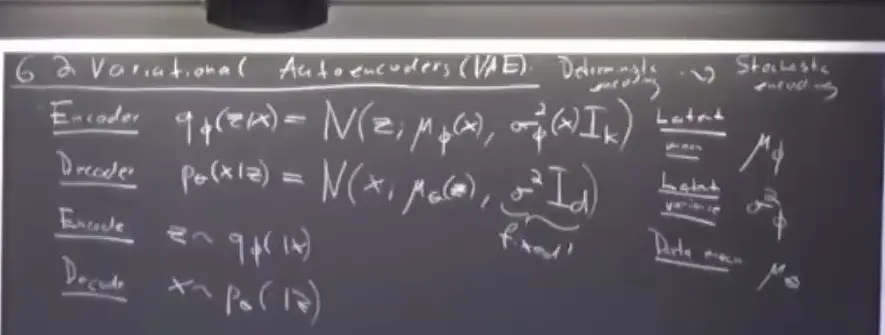
講義的一般形式是解碼器變異數 \(\sigma_\theta^2(z)\) 也能學,損失會多一項 \(\frac d2\log\sigma_\theta^2(z)\)(解碼器的信心);老師和 Lab 都把它固定。另外,如果兩個變異數都是 0,VAE 就退回標準的自編碼器。
重建損失變成什麼
現在要求:把 \(x\) 編碼成隨機的 \(z\) 之後,解碼器給原本的 \(x\) 高機率。寫成損失,就是負對數概似(概似 likelihood:資料固定時,模型給它的機率密度):
$$\begin{aligned}&L_{\text{Recon}}(\phi,\theta)\\&=\mathbb E_{x\sim p_{\text{data}},\,z\sim q_\phi(\cdot\mid x)}\\&\qquad\big[-\log p_\theta(x\mid z)\big]\end{aligned}$$口誤:18:22 老師說「我們希望負對數概似要高」,應該是對數概似高、負對數概似低。損失是要最小化的,黑板上的式子沒錯。
代入高斯密度 18:53:
$$\begin{aligned}&-\log\mathcal N(x;\mu_\theta(z),\sigma^2I_d)\\&=\frac{\Vert x-\mu_\theta(z)\Vert^2}{2\sigma^2}+\frac d2\log(2\pi\sigma^2)\end{aligned}$$第二項和參數無關。所以就是均方誤差,和自編碼器只差兩點:多一個係數,而且 \(z\) 是抽樣的。
05KL 散度與 prior loss(投影片 13–16)
什麼叫好的分佈?老師問,學生答:高斯 20:57。於是要讓 latent 分佈接近高斯,用 KL 散度衡量「接近」。
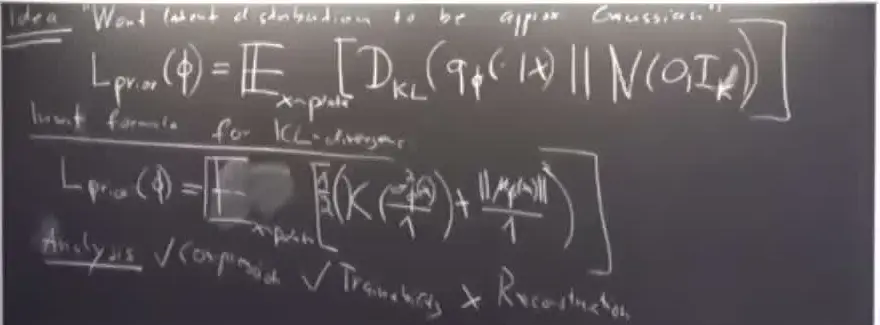
老師提醒它嚴格說不是距離 22:00;後來學生也提到它不對稱 36:55:一般來說 \(D_{\text{KL}}(q\Vert p)\neq D_{\text{KL}}(p\Vert q)\)。
高斯之間的 KL:推導
課堂直接給公式,講義有證明。先做 \(d=1\),\(q=\mathcal N(\mu_q,\sigma_q^2)\),\(p=\mathcal N(\mu_p,\sigma_p^2)\):
- 對數相減: $$\begin{aligned}&\log q(x)-\log p(x)\\&=\tfrac12\log\frac{\sigma_p^2}{\sigma_q^2}\\&\quad+\frac{(x-\mu_p)^2}{2\sigma_p^2}-\frac{(x-\mu_q)^2}{2\sigma_q^2}\end{aligned}$$
- 對 \(x\sim q\) 取期望值。最後一項:\(\mathbb E_q[(x-\mu_q)^2]=\sigma_q^2\),所以是 \(-\tfrac12\)。
- 中間那項用變異數的展開:\(\mathbb E_q[(x-\mu_p)^2]=\sigma_q^2+(\mu_q-\mu_p)^2\)。
- 合起來,令 \(\alpha=\sigma_q^2/\sigma_p^2\): $$\begin{aligned}D_{\text{KL}}=\frac12\Big(&\alpha-\log\alpha-1\\&+\frac{(\mu_q-\mu_p)^2}{\sigma_p^2}\Big)\end{aligned}$$
多維(對角)時每個座標各加一次:
- \(q=\mathcal N(1,1)\):\(\tfrac12(0+1)=0.5\)。
- \(q=\mathcal N(0,4)\):\(\tfrac12(4-\ln4-1)\),約 \(0.807\)。
- \(q=\mathcal N(0,1)\):0。
代入 \(p=\mathcal N(0,I_k)\),\(\sigma_p=1\)、\(\mu_p=0\) 26:18:
$$\begin{aligned}&L_{\text{prior}}(\phi)\\&=\mathbb E_x\Big[\tfrac12\mathcal K\big(\sigma_\phi^2(x)\big)+\tfrac12\Vert\mu_\phi(x)\Vert^2\Big]\end{aligned}$$意思:\(\sigma_\phi^2\) 推向 1,\(\mu_\phi\) 推向 0。
單獨用它不行 28:23:最小值點是不管 \(x\) 是什麼,一律輸出 \(\mu=0,\sigma=1\)。這完全忽略資料,也就談不上重建。
06合併兩個損失
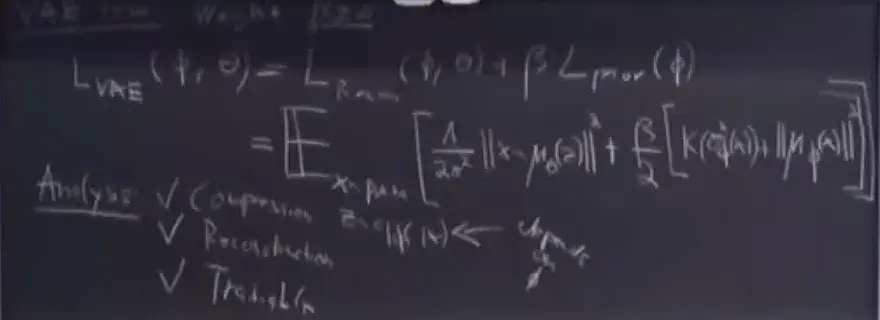
\(\beta\) 在重建和分佈好不好之間取捨 34:19。老師說實務上 \(\beta\) 選得相當小,這是個經驗問題。講義也說,現代的自編碼器都 \(\beta\ll1\)。
課堂問答
講義的實務補充,以及 VAE 損失的另一種解讀
實務補充(講義 §6.2):KL warm-up,先用 \(\beta=0\),再慢慢調高;解碼器的變異數常常固定,學它在數值上很敏感;純像素的 MSE 容易過於平滑,實際會加 perceptual loss(在預訓練網路的特徵上比差異);也常加對抗損失(多訓練一個判別器)讓結果更銳利,代價是訓練不穩定。
另一種解讀(講義附錄):把編碼器和解碼器都看成 \((x,z)\) 的聯合分佈:\(q_\phi(x,z)=p_{\text{data}}(x)q_\phi(z\mid x)\)、\(p_\theta(x,z)=p_\theta(x\mid z)\mathcal N(z;0,I_k)\)。展開它們的 KL:
$$\begin{aligned}&D_{\text{KL}}(q_\phi\Vert p_\theta)=\mathbb E[\log p_{\text{data}}(x)]\\&+\mathbb E_x\big[D_{\text{KL}}(q_\phi(\cdot\mid x)\Vert\mathcal N(0,I_k))\big]\\&-\mathbb E[\log p_\theta(x\mid z)]\end{aligned}$$第一項是常數,後兩項正是 \(\beta=1\) 的 VAE 損失。所以 VAE 是在讓兩個聯合分佈接近。CS236 的 第 6 講從 ELBO 得到同一個式子。
講義附錄:VAE 本身就能生成,為什麼還要 latent diffusion?
VAE 也是生成模型:抽 \(z\sim\mathcal N(0,I_k)\) 再解碼,得到 \(p_\theta(x)=\int p_\theta(x\mid z)\mathcal N(z;0,I_k)\mathrm dz\)。它學得好不好,可以用 KL 的 chain rule 看。聯合分佈等於邊際乘條件,取 log 再分開期望值:
$$\begin{aligned}&D_{\text{KL}}(q(x,z)\Vert p(x,z))\\&=D_{\text{KL}}(q(x)\Vert p(x))\\&\quad+\mathbb E_{x\sim q}\big[D_{\text{KL}}(q(z\mid x)\Vert p(z\mid x))\big]\end{aligned}$$第二項 \(\ge0\),所以聯合的 KL 比邊際的 KL 大。\(q_\phi\) 對 \(x\) 的邊際就是 \(p_{\text{data}}\),所以 \(\beta=1\) 的 VAE 損失是 \(D_{\text{KL}}(p_{\text{data}}\Vert p_\theta)\) 的上界(差一個常數)。對 \(z\) 同樣拆,它也是 \(D_{\text{KL}}(q_\phi(z)\Vert\mathcal N(0,I_k))\) 的上界。
為什麼不停在 VAE:上界和真正的 KL 之間有差距,講義叫 amortization gap,只有 \(q_\phi(z\mid x)=p_\theta(z\mid x)\) 時才是 0。訓練結束時它通常還在,所以 \(q_\phi(z)\neq\mathcal N(0,I_k)\)。解碼器訓練時看的是 \(q_\phi(z)\),改從 \(\mathcal N(0,I_k)\) 抽等於走出訓練時的分佈。講義說這其實是好事:實務上 flow 和 diffusion 比 VAE 的解碼器能力強,把生成的難題交給 latent 上的模型比較合理。Demo A 的 \(\beta=0\) 可以看到這一點。
ELBO 和 variational:同一個損失也可以寫成 \(L_{\text{VAE}}=-\mathbb E_x[\text{ELBO}(x)]+\text{常數}\),其中 $$\begin{aligned}&\text{ELBO}(x)\\&=\mathbb E_{q_\phi}\Big[\log\frac{p_\theta(x\mid z)\mathcal N(z;0,I_k)}{q_\phi(z\mid x)}\Big]\\&\le\log p_\theta(x)\end{aligned}$$ 真正的後驗 \(p_\theta(z\mid x)\) 算不出來,因為分母 \(p_\theta(x)\) 算不出來,所以用 \(q_\phi\) 當替代品,這就是 variational 的意思。
重建和生成的拉鋸:FID 是衡量兩堆圖片分佈差多遠的分數,越小越好(CS236 第 15 講)。量「編碼再解碼」的叫 rFID,量「latent 模型生成再解碼」的叫 gFID。rFID 低代表 latent 留了很多資訊,latent 分佈也比較難學,gFID 往往變高;反過來也一樣。所以要找一個分工點:壓得夠多,又不會讓重建太差。
07Reparameterization trick(投影片 17)
老師問:這個損失還有什麼問題? 39:27 問題在期望值的抽樣分佈本身就依賴 \(\phi\)。深度學習的慣例是抽樣後對固定的樣本微分,這裡這樣做不是損失的正確梯度。
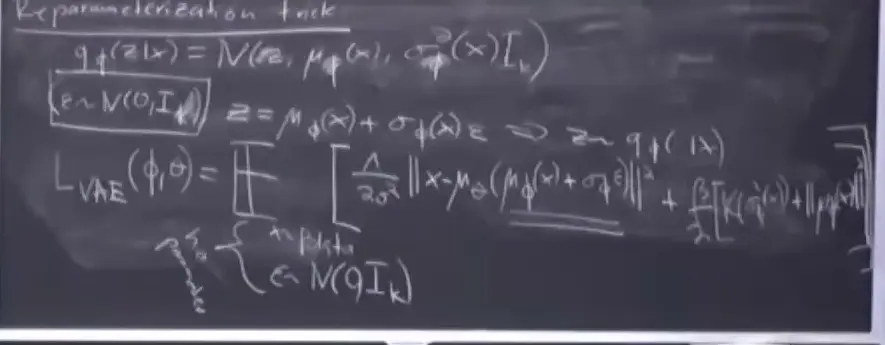
- 天真的做法:先抽 \(z\),再對 \(\mu\) 微分 \(z^2\)。\(z\) 當常數,得到 0。錯了。
- 換參數:\(z=\mu+\epsilon\),\(\frac{\partial}{\partial\mu}(\mu+\epsilon)^2=2(\mu+\epsilon)\)。平均是 \(2\mu\)。正確。
Demo AVAE 加 latent diffusion
真的跑一次整條流程:8×8 手寫數字(\(d=64\),1,797 張),VAE 壓到 \(k=2\),再用第 2 講的 flow matching 在 latent 上訓練,最後解碼。電腦上大約 5 秒跑完,手機可能更久。固定 \(\sigma^2=0.1\),latent 訓練前先標準化。
- \(\beta=0\):純自編碼器。重建誤差 0.0938(只猜平均圖是 0.1334),編碼器的 \(\sigma\) 只有 0.024,幾乎是確定性的。\(\mu\) 的平均在 (−0.921, 0.133),沒有對準原點,所以直接解碼 \(\mathcal N(0,I)\) 的樣本很差(到最近訓練圖的誤差 0.2475),但 latent flow matching 仍然有 0.0581:它學的是實際的 latent 分佈,不在乎是不是高斯。
- \(\beta=1\)、\(\beta=5\):KL 從 3.554 降到 0.999,\(\mu\) 的平均從 (−0.544, 0.161) 回到原點附近的 (0.022, 0.077),直接解碼的誤差降到 0.1137、0.0668。代價在 \(\beta=5\) 才看得出來:\(\beta=1\) 的重建還是 0.0938,\(\beta=5\) 變差到 0.1039。\(\beta=5\) 時 latent 已經接近高斯,latent flow matching(0.0686)和直接解碼差不多。
- \(\beta=20\):posterior collapse。KL 只剩 0.010,\(\sigma\) 平均 0.981,\(\mu\) 的標準差不到 0.09:編碼器幾乎不管輸入。重建誤差 0.1362,比只猜平均圖還差,重建那一列都是同一張模糊的圖。注意最近訓練圖的誤差是 0.0812,看起來不算差:模糊的平均圖本來就不會離每張圖太遠。所以這個數字只能當參考,要一起看圖。
08Latent diffusion(投影片 18–19)
- 資料:\(x_1,\dots,x_N\)。
- 編碼:全部轉成 latent(VAE 直接取平均 \(\mu_\phi(x)\))。
- Latent 資料:得到 \(z_1,\dots,z_N\),小得多。
- Latent diffusion model:對這份資料訓練 diffusion model。
- 解碼:取樣後,把 latent 解回資料空間。
講義的補充:訓練時從 \(q_\phi(z\mid x)\) 抽樣,解碼時取平均而不抽樣,避免雜訊造成的瑕疵。投影片和老師說的編碼是取平均。兩者略有差別,都是常見做法。
- Stable Diffusion:\(3\times256^2=196{,}608\) 變成 \(4\times32^2=4{,}096\),48 倍。
- FLUX 2.0:\(3\times1024^2=3{,}145{,}728\) 變成 \(32\times64^2=131{,}072\),24 倍。
延伸:CS236 第 17 講的 latent diffusion。
09網路的三個輸入(投影片 20–23)
輸出呢?老師問,答案是另一個 latent,和 \(x\) 同形狀 58:29。三個輸入形狀各不相同,要先都變成向量序列。
講義說,低維的玩具例子把 \(x,y,t\) 接起來丟進 MLP 就夠了,這頁 Demo A 的 latent flow matching 也是用 MLP。影像、影片、蛋白質這類高維資料才需要專門的架構。
時間:一個數字變成高維向量
\(t\) 只有一維,其他輸入都很高維。為了讓它「有份量」,用不同頻率的 sin、cos 把它展開,講義稱為 Fourier features 58:59:
老師說這有各種寫法,重點是得到一個 \(d\) 維、長度固定的向量 58:59。頻率取等比數列,讓它同時有慢和快的變化(轉述者的解讀)。
提示詞
這些模型別人已經訓練好了,直接拿來用 59:59。CLIP 是 OpenAI 的對比學習模型,給出和影像相關的文字嵌入。對比學習是讓配對的圖片和文字嵌入靠近、不配對的遠離(這句是轉述者補充)。如果條件只是類別標籤,就更簡單:每個類別學一個嵌入向量(講義 §6.1)。
Demo B時間嵌入
- \(t\) 只差 0.01,內積就從 1 掉到 0.477;差 0.05 時是 0.147,差 0.2 時是 −0.189;差 0.001 時才是 0.988。也就是很接近的時間,嵌入已經明顯不同,網路比較容易分辨。內積只和時間差有關,因為 \(\cos a\cos b+\sin a\sin b=\cos(a-b)\)。
- 不管 \(t\) 是多少,長度都是 1.000;用投影片的 \(1/\sqrt d\) 會是 0.707。
10Patchify(投影片 24)
影像(或 latent)是 \(C\times H\times W\) 的陣列,transformer(把向量序列變成向量序列的網路)要的是向量序列。做法和 vision transformer 一樣,切成小方塊,每塊攤平 61:30:
Demo Cpatch 的數量
11Attention 與 DiT(投影片 25–28)
Scaled dot-product attention
老師舉手調查,多數人學過,所以講得快 64:35。它把向量序列變成向量序列。輸入三樣:queries、keys、values。
\(d_h\) 從哪裡來:實際用的是 multi-head attention(講義)。把 \(d\) 維的向量投影成 \(h\) 組 \(d_h=d/h\) 維的 Q、K、V,各做一次 Attn,接起來再乘一個矩陣回到 \(d\) 維。這樣每一組可以看不同的關聯。
怎麼讀:每個 query 和所有 key 算內積,內積大代表「相關」。softmax 把它變成權重,輸出就是 values 的加權平均。除以 \(\sqrt{d_h}\) 避免維度高時內積太大,讓 softmax 塌成只有一個(轉述者補充,出自 Vaswani et al.)。
- 內積:1 和 0。除以 \(\sqrt2\):0.707 和 0。
- softmax:\(e^{0.707}=2.028\)、\(e^0=1\),得到權重 0.670、0.330。
- 輸出:\(0.670\times10+0.330\times20\),約 13.30。
DiT 區塊
| 輸入 | 怎麼進去 | 意思 |
|---|---|---|
| 影像 \(x\) | self-attention,\(Q=K=V=x\) | patch 之間互相看 |
| 提示詞 \(y\) | cross-attention,\(Q=x\),\(K=V=y\) | 每個 patch 去看相關的文字 |
| 時間 \(t\) | AdaLN | 正規化(把數值調成固定的平均和尺度)後的縮放和平移由時間決定 |
講義的形式:\((\gamma,\beta)=g(\tilde t)\),\(\text{AdaNorm}_{\tilde t}(x)=(1+\gamma)\odot\text{Norm}(x)+\beta\)(這裡 \(\beta\) 又是另一個東西)。講義的式子印成 Norm(H),應是 Norm(x)。\(\odot\) 是逐元素相乘。一個區塊依序做 self-attention、cross-attention、MLP,每一步都是殘差(把輸出加回原本的 \(x\)):\(x\leftarrow x+g(\tilde t)\cdot(\cdots)\)。
最後一步:每個向量乘 \(\tilde W\in\mathbb R^{d\times C'}\) 變回 \(C'\) 維,再拼回 \(C\times H\times W\),就是輸出的速度 \(u\)。Lab 裡的類別條件 DiT 更簡單,沒有 cross-attention,時間和類別都走 AdaNorm(講義)。
老師說他相信只有實作才算懂,所以這裡只給總覽 66:36。
U-Net(講義有,課堂沒講)
DiT 之前的主流。它是摺積網路(用同一組小窗口掃過整張圖的網路),輸入輸出都是影像形狀:編碼器把長寬縮小、channel 增加,例如 \(3\times256\times256\to512\times32\times32\);中間處理;解碼器還原;對應層之間有殘差連接,整體形狀像 U。原本是做影像分割的,因為輸入輸出同形狀,很適合表示向量場。CS236 的 第 17 講也提到它。
Demo Dattention
12兩個實際模型(投影片 29–33)
| Stable Diffusion 3 | Meta MovieGen | |
|---|---|---|
| 資料 | 影像(資料集 LAION) | 影片 |
| 訓練 | flow matching,直線排程(第 2 講) | 相同 |
| Guidance | CFG,\(w\) 在 2.0–5.0(第 3 講) | CFG |
| Latent | 預訓練 VAE | 預訓練的 temporal autoencoder,時間和長寬各縮 8 倍(講義) |
| 架構 | MM-DiT | 適應影片的 DiT,patch 是 3D 的 |
| 文字嵌入 | CLIP(粗略)、T5-XXL(細節);講義說共 3 種 | UL2、ByT5、MetaCLIP(講義) |
| 參數量 | 80 億 | 300 億 |
| 取樣 | 50 步 | — |
| 硬體 | — | 6,144 張 H100 GPU |
老師的重點:這些模型用的就是前幾講的東西 68:08。SD3 的 MM-DiT 差別在:文字序列不只被影像看,也會在網路裡一路被處理 69:39。
影片的 DiT 要改什麼?學生提到時間一致性,老師說都對,也是很大的挑戰,但他想講的是最直接的一點:patch 要從 2D 變成 3D,也就是連時間一起切 72:12。他也提醒,這裡的「時間」是影片的時間軸,和 flow matching 的 \(t\) 是兩回事 71:42。
影片的 latent 特別關鍵,所有東西都要再乘上影格數,這也是現在影片通常很短的原因 70:41。
講義的補充:SD3 論文試過多種 flow 和 diffusion 的做法,flow matching 表現最好;取樣用 Euler 法。CLIP 給整句粗略的嵌入,T5 給逐字的序列,所以 MM-DiT 讓影像 patch 也去看文字序列。MovieGen 為了長影片會把影片切段分別編碼再接起來(temporal tiling),三種文字嵌入的用途分別是細節理解(UL2)、字元層級(ByT5,例如要求畫面出現特定文字)和圖文共享空間(MetaCLIP)。
13文獻導覽(投影片 34–39)
讀論文時你會遇到不一樣的寫法,老師說它們本質上是同一件事 73:13。這一節就是第 3 講投影片 38–43 留下來的內容。
| 主題 | 這門課 | 其他文獻 |
|---|---|---|
| 時間 | 資料 \(t=1\),雜訊 \(t=0\)(flow matching、rectified flow、stochastic interpolant) | Score SDE:資料 \(t=0\),雜訊 \(t\to\infty\) |
| 離散 | ODE/SDE | DDPM:離散的 Markov chain,損失用 ELBO(真正目標的一個下界);DDIM 大致是 probability flow ODE |
| 加雜訊 | 機率路徑 \(\mathcal N(\alpha_tz,\beta_t^2I_d)\) | 內插函數 \(I_t(\epsilon,z)=\alpha_t\epsilon+\beta_tz\);或 forward SDE \(\mathrm dX_t=a_t(X_t)\mathrm dt+\sigma_t\mathrm dW_t\) |
| 目標 | 連續方程、Fokker–Planck | forward SDE 的 time reversal,需要 score |
符號不一致:投影片 36 的內插寫成 \(\alpha_t\epsilon+\beta_tz\),\(\alpha,\beta\) 和這門課的排程相反(這門課是 \(\alpha_tz+\beta_t\epsilon\))。它是在描述 stochastic interpolant 的一般形式,看的時候要注意。
講義附錄的細節:forward process 和 time reversal
離散時間的缺點:要事先決定離散化,損失是 ELBO,只是下界。Song 等人(2020)指出離散版本近似連續的 SDE;連續時間時下界變緊,第 2、3 講的定理都是等式。兩者用的其實是同樣的損失。
Forward process 就是一種機率路徑:SDE \(\mathrm d\bar X_t=a_t\bar X_t\mathrm dt+\bar\sigma_t\mathrm d\bar W_t\),條件分佈是高斯,也就是高斯路徑。但要在訓練時不模擬,必須有閉式解,所以漂移一定是線性的;而且要 \(t\to\infty\) 才真的變高斯,有限時間到不了 \(p_{\text{init}}\)。閉式解是 \(\alpha_t=\exp\int_0^ta_r\mathrm dr\)、\(\beta_t^2=\alpha_t^2\int_0^t\bar\sigma_r^2/\alpha_r^2\mathrm dr\)。
Time reversal(Anderson 1982):反向 SDE 的漂移是 \(-u_t+\sigma_t^2\nabla\log p_t\)。對生成來說我們只用最後一點,是不是「真的」時間反轉並不重要,所以不必用它,probability flow ODE 常常更好。CS236 的 第 16 講、補充課 F 用的就是這個角度。
為什麼這門課選 flow matching
老師自認有偏見:他喜歡這個框架,因為簡單,SDE 只是選項;而且推導從頭到尾沒有用到起點必須是高斯 76:50。講義也說 diffusion model 只能用高斯起點,這是 flow matching 和 stochastic interpolant 的優勢。
14總結與下一講(投影片 40)
| 部件 | 出處 | 這一講怎麼放大 |
|---|---|---|
| 訓練目標 | 第 2 講 | flow matching,直線排程,不變 |
| 提示詞 | 第 3 講 | CFG;文字用預訓練嵌入 |
| 資料 | — | 先用 VAE 壓到 latent space |
| 網路 | — | DiT:patch、attention、AdaLN |
| 取樣 | 第 1 講 | Euler 法約 50 步,再解碼 |
老師預告 79:53:週五是加分課,把 diffusion 的原理用到語言模型,通過這門課不需要它。那堂課的複習頁是第 5 講。
和其他頁面的關聯
- CS236 第 5 講、第 6 講:VAE 當生成模型的完整推導。
- 書 B03:同一個 VAE,但編碼器和解碼器的記號相反。
- CS236 第 17 講的 latent diffusion。
常見誤解
- 「VAE 是這裡的生成模型。」在 latent diffusion 裡,VAE 只負責壓縮和還原,生成是 latent 上的 flow 或 diffusion。
- 「prior loss 讓 latent 分佈變成高斯。」它只是拉向高斯,\(\beta\) 通常很小;整體 latent 分佈是混合,不是高斯。所以才要 diffusion。
- 「\(\beta\) 越大,latent 越好。」太大會 posterior collapse,編碼器不管輸入(Demo A 的 \(\beta=20\))。
- 「Reparameterization 是讓計算變快。」它是讓梯度正確。不做的話梯度是錯的,不是慢。
- 「Latent 就是一條普通向量。」它通常保留 channel × 高 × 寬的形狀,所以還能切 patch。
- 「影片 DiT 的時間就是 \(t\)。」影片時間軸是資料的一個維度;\(t\) 是 flow 的時間,兩者無關。
- 「Patchify 會壓縮資料。」它只是換排法,數字總數不變。真正壓縮的是 VAE。
- 「DDPM、Score SDE 和 flow matching 是三種不同的模型。」高斯路徑下,差別主要是時間慣例和推導方式,訓練的損失相同。
自我測驗
1. Diffusion model 比分類器更怕高維的兩個原因?
2. 只有重建損失的自編碼器缺什麼?
3. 為什麼高斯解碼器的負對數概似是 MSE?
4. \(q=\mathcal N(2,1)\)、\(p=\mathcal N(0,1)\),KL 是多少?\(q=\mathcal N(0,0.25)\) 呢?
5. 只用 prior loss 訓練,最小值點是什麼?
6. 為什麼需要 reparameterization trick?舉一個數字例子。
7. Latent diffusion 的五個步驟?
8. 投影片 22 的 \(1/\sqrt d\) 哪裡錯?
9. \(16\times64\times64\) 的 latent,\(P=4\),\(N\) 和 \(C'\) 是多少?
10. \(Q=(0,1)\)、\(K_1=(1,0)\)、\(K_2=(0,1)\)、values 為 10、20、\(d_h=1\),手算 attention。
11. Self-attention 和 cross-attention 差在哪?
12. 影片的 DiT 最直接的改動是什麼?這裡的時間是 \(t\) 嗎?
13. 讀到一篇 data at \(t=0\)、用 forward SDE、目標是 score 的論文,要怎麼對應回這門課?
延伸閱讀
- Holderrieth & Erives,An Introduction to Flow Matching and Diffusion Models,§6 與 VAE、文獻導覽兩個附錄:本頁都對照過 TeX 原文。
- 課程網站的 Lab 3。
- CS236 第 6 講、書 B03:VAE。