離散 diffusion 與離散 flow matching:用同一套配方生成文字
文字是一串離散的 token,沒有「往某個方向走一點」這回事,所以 ODE 和 SDE 都不能用。這一講把它們換成 continuous-time Markov chain(CTMC),向量場換成速率矩陣。神奇的是第 2 講的配方幾乎一字不改就能搬過來,而且最後要學的東西,從回歸變成了分類。
讀完這頁你應該能夠
- 說明為什麼離散空間沒有 ODE 和 SDE,以及 CTMC 用什麼取代向量場。
- 寫出速率矩陣的兩個條件,解釋 \(Q_t(y\mid x)\) 乘上 \(h\) 為什麼近似機率。
- 手算兩狀態 CTMC 的轉移機率,以及一步 Euler 的機率。
- 解釋因子化為什麼必要,算出它把多大的東西縮成 \(d\times V\)。
- 驗證 factorized mixture path 是條件機率路徑,並說明它和連續路徑的差別。
- 用流入和流出解釋 Kolmogorov forward equation,手算驗證一個例子。
- 推出條件速率矩陣的形式,解釋 \(\dot\kappa_t/(1-\kappa_t)\) 為什麼會爆炸。
- 證明離散 marginalization trick,推出邊際速率只差一個後驗機率。
- 寫出 discrete flow matching 損失,說明為什麼交叉熵學到的是後驗。
- 說明 masked diffusion 怎麼運作,以及它和自迴歸模型的取捨。
前置知識檢查
- 第 2 講的配方:條件路徑、條件向量場、marginalization trick(第 2 講叫邊際化技巧)。這一講每一步都和它一一對應。
- 條件機率、貝氏定理:\(P(A\mid B)=P(B\mid A)P(A)/P(B)\),以及全機率公式 \(P(B)=\sum_AP(B\mid A)P(A)\)。
- 簡單的微分方程:\(u'=-cu\) 的解是 \(u(0)e^{-ct}\)(補充課 B)。
- Softmax、交叉熵:softmax 把一列分數變成機率;真實類別的機率是 \(q\) 時,交叉熵是 \(-\log q\)。第 12 節會推導它為什麼學得到機率。
- 選讀:補充課 G:連續時間 Markov 鏈從頭講指數分佈和速率,比這一講慢得多。覺得第 2 節太快就先讀它。
這一頁怎麼讀、記號
| 記號 | 意思 |
|---|---|
| \(\mathcal V=\{v_1,\dots,v_V\}\) | 字母表(vocabulary),大小是 \(V\) |
| \(S=\mathcal V^d\) | 狀態空間:長度 \(d\) 的所有序列,共 \(V^d\) 個 |
| \(x_j\)、\(z_j\) | 序列第 \(j\) 個位置的 token |
| \(Q_t(y\mid x)\) | 從 \(x\) 跳到 \(y\) 的速率。條件號右邊是出發點 |
| \(Q_t(v_i,j\mid x)\) | 只把第 \(j\) 個位置換成 \(v_i\) 的速率 |
| \(\delta_z(x)\) | \(x=z\) 時是 1,否則是 0 |
| \(\kappa_t\) | 排程:\(\kappa_0=0,\ \kappa_1=1\),遞增 |
| \(p_{1\mid t}(z\mid x)\) | 看到 \(t\) 時的狀態 \(x\),資料點是 \(z\) 的機率(後驗) |
| \(h\)、\(n\) | 取樣的步長、步數,\(h=1/n\) |
逐字稿是 YouTube 自動字幕,有疑問時以黑板和投影片為準(例如字幕把 \(\theta\) 聽成 feeder、autoregressive 聽成 auto aggressive、KV caching 聽成 KB caching)。部分學生的提問麥克風沒收到,那些問答的標題是從老師的重述和回答推測的。老師說這一講速度比較快(02:41),因為前四講的原理可以直接搬用;也說這段內容不影響這門課的通過(51:37)。這一頁會把他跳過的步驟補上。投影片 1 寫「IAP 2026 | Jan 30, 2025」,年份應該是 2026。另外,第 3、4 講的投影片和第 3 講的預告都說這堂也會講 distilled models,但這堂的投影片已經拿掉,影片也沒有講;想看的話,可以讀書的 B28。
01文字沒有方向(投影片 2–5)
前四講的資料都是 \(\mathbb R^d\) 裡的向量。向量場告訴你「往這個方向走一點」。可是文字呢?
老師的問法是:從字母 Y 往字母 X 的「方向」是什麼 05:24?沒有這種東西。token 之間沒有加法,「貓 + 0.3 個單位」沒有意義。所以 \(\mathrm dX_t=u_t\,\mathrm dt\) 這個寫法整個不能用;SDE 也一樣,不能加高斯雜訊。能做的只有一件事:跳,也就是把一個 token 換成另一個。我們能指定的只有「多快換」。
先看整張對照表,後面每一節都在填它:
| 連續(第 1–4 講) | 離散(這一講) | |
|---|---|---|
| 狀態空間 | \(\mathbb R^d\) | \(S=\mathcal V^d\) |
| 過程 | ODE/SDE | CTMC |
| 網路要給的 | 向量場 \(u_t(x)\) | 速率矩陣 \(Q_t(y\mid x)\) |
| 起點 | 高斯 | 均勻分佈,或全部 [MASK] |
| 分佈怎麼變 | 連續方程 | Kolmogorov forward equation |
| 路徑 | 把質量搬過去 | 原地淡出、淡入 |
| 學的東西 | 回歸:預測速度 | 分類:預測 token |
02CTMC 與速率矩陣(投影片 6)
從黑板上的定義開始 03:19。字母表 \(\mathcal V\) 可以是英文字母,也可以是胺基酸。狀態空間從 \(\mathbb R^d\) 換成 \(S=\mathcal V^d\):一個狀態就是長度 \(d\) 的序列 \(x=(x_1,\dots,x_d)\)。
什麼是速率
時間是連續的,「下一步跳走的機率」就沒有意義了,因為沒有下一步。所以我們講速率:每單位時間跳走多少。速率 \(Q\) 乘上一段很短的時間 \(h\),才是機率:
$$P(\text{在 }h\text{ 內從 }x\text{ 跳到 }y)\approx h\,Q_t(y\mid x)$$(R1):跳走的速率不能是負的,什麼都不做就是 0 了,老師說「比什麼都不做還少」不可能 05:54。(R2):只有留下和離開兩個選項,所以「留下的速率」就是負的總離開速率,兩者互相抵消 06:24。把 \(y\) 全部加起來:
$$\sum_{y\in S}Q_t(y\mid x)=0$$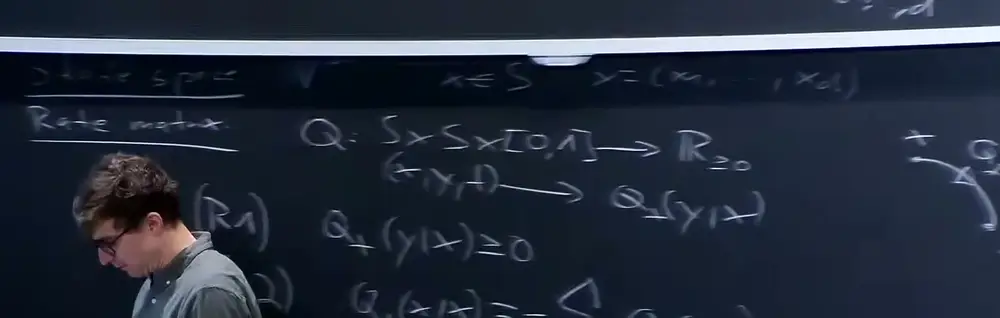
什麼是 CTMC
\(X_t\) 是一個隨機過程,每個時間都是 \(S\) 裡的一個隨機元素,而且沒有記憶 07:55:
$$\begin{aligned}&p(X_{t+h}\mid X_t,X_{t_1},\dots,X_{t_k})\\&=p(X_{t+h}\mid X_t)\end{aligned}$$過去對未來沒有影響,只有現在有。(講義提醒,ODE 和 SDE 其實也是 Markov 過程,只是不在離散空間。)所以它完全由起點和轉移機率 \(p_{t+h\mid t}(y\mid x)\) 決定。怎麼把它和速率矩陣接起來?這就是這裡的「ODE」08:55:
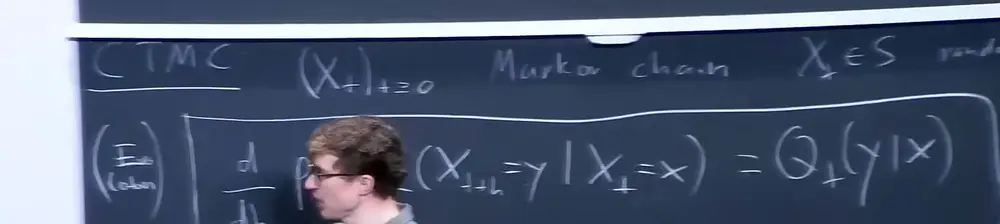
這條式子和前面「\(h\) 很小時機率約 \(hQ\)」是同一件事:\(h=0\) 時機率是 0,往上長的斜率是 \(Q\)。反過來,隨便拿一個 CTMC,用這條式子定義 \(Q\),一定滿足那兩個條件嗎?講義驗算了:
- (R1):\(y\ne x\) 時,\(h=0\) 的機率是 0(時間沒過,不可能跑掉)。機率不能是負的,所以它只能往上走,導數 \(\ge0\)。
- (R2):跳到別處的機率總和是「1 減去留下的機率」,對它微分: $$\begin{aligned}&\sum_{y\ne x}Q_t(y\mid x)\\&=\frac{\mathrm d}{\mathrm dh}\Big|_{h=0}\big(1-p_{t+h\mid t}(x\mid x)\big)\\&=-Q_t(x\mid x)\end{aligned}$$
另一個方向由一個定理保證:只要 \(Q_t\) 有界、對時間連續,就恰好有一個 CTMC 滿足演化條件(講義的定理,附錄有完整證明,做法是把它看成線性 ODE)。所以機器學習的做法是合法的:網路只要輸出 \(Q_t\),對應的 CTMC 就存在而且唯一,和第 1 講的 ODE 一樣。
延伸:補充課 G §1 從「每步機率」推到速率,§2 講跳躍時間為什麼是指數分佈。
03兩個狀態的例子(投影片 7)
\(S=\{a,b\}\),兩邊互相切換的速率都是 \(\lambda\) 10:29。第 \(x\) 行是「從 \(x\) 出發」:
$$Q=\begin{array}{c|cc}&a&b\\\hline a&-\lambda&\lambda\\b&\lambda&-\lambda\end{array}$$檢查條件:非對角 \(\lambda\ge0\),每行加起來是 0。投影片說「把導數算出來就能驗證」下面的答案,但沒說答案怎麼來。我們直接算。設從 \(a\) 出發,\(h\) 之後在 \(a\) 和 \(b\) 的機率是 \(p_a,p_b\)。再過很短的 \(\Delta\),\(p_a\) 從 \(b\) 流入 \(\lambda\Delta p_b\),向 \(b\) 流出 \(\lambda\Delta p_a\):
$$p_a'=\lambda p_b-\lambda p_a,\qquad p_b'=\lambda p_a-\lambda p_b$$令 \(u=p_a-p_b\),兩式相減:
$$\begin{gathered}u'=-2\lambda u\\\Rightarrow\ u(h)=u(0)\,e^{-2\lambda h}=e^{-2\lambda h}\end{gathered}$$因為 \(u(0)=1-0=1\)。再加上 \(p_a+p_b=1\),解兩個未知數:
最後這一點老師特別提 12:02:時間夠長,鏈就忘了自己從哪裡來,變成一半一半,他叫它 total chaos。\(\lambda\) 越大,忘得越快。
老師口頭念的時候沒有念係數 \(\tfrac12\)(11:00),以投影片和講義為準。
後面會用到的細節:\(p'_a\) 那條式子就是「流入減流出」,第 8 節的 KFE 只是把它寫成一般形式。Demo A 在第 5 節之後。
04因子化(投影片 8–9)
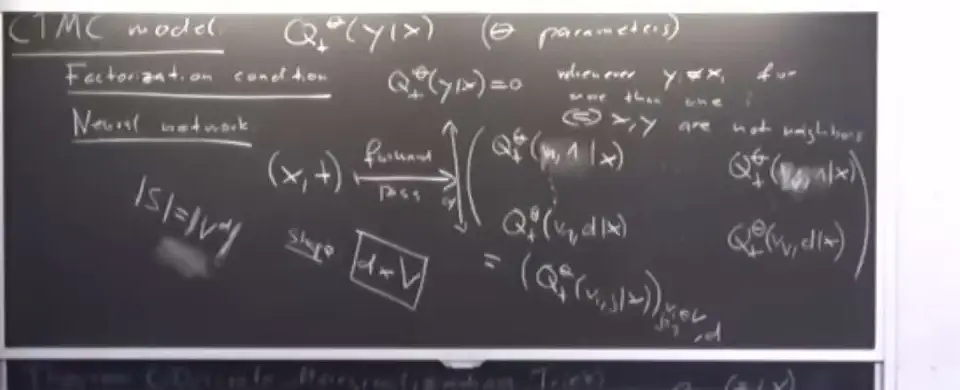
現在把 \(Q_t\) 參數化成神經網路 \(Q_t^\theta\) 12:33。問題馬上出現。模擬時,給定現在的 \(x\),要知道跳到每個 \(y\) 的速率,也就是矩陣的一整行。這一行有多長?\(|S|=V^d\)。
所以要加限制:一次只准改一個 token。兩個序列最多差一個位置,就叫鄰居(用 Hamming distance(兩個序列有幾個位置不同)的話,就是距離不超過 1 14:35)。
14:05 字幕是「more than two tokens」,圖上是剛好兩個;定義是超過一個就不是鄰居。
這不會限制能走到哪裡:跳兩次就可以同時改兩個位置,只是不能在同一瞬間 20:07。
限制之後,網路只要輸出每個位置換成每個 token 的速率 15:37:
$$(x,t)\mapsto\begin{pmatrix}q_1(v_1)&\cdots&q_1(v_V)\\\vdots&&\vdots\\q_d(v_1)&\cdots&q_d(v_V)\end{pmatrix}$$這個表是 \(d\) 列、\(V\) 行,\(q_j(v_i)\) 是 \(Q_t^\theta(v_i,j\mid x)\) 的簡寫。\(Q_t^\theta(v_i,j\mid x)\) 就是 \(Q_t^\theta(y\mid x)\),其中 \(y\) 是把 \(x\) 的第 \(j\) 個位置換成 \(v_i\) 的序列。上面的例子從 141 兆縮成 \(10\times26=260\) 個數:隨長度線性成長,不再是指數。每一列自己就是一個速率矩陣的一行,要滿足:
$$\begin{aligned}&Q_t^\theta(v,j\mid x)\ge0\quad(v\ne x_j)\\&Q_t^\theta(x_j,j\mid x)=-\sum_{v\ne x_j}Q_t^\theta(v,j\mid x)\end{aligned}$$這種輸出形狀正是序列模型擅長的,比如輸出維度 \(V\)、長度 \(d\) 的 transformer。
05怎麼模擬(投影片 10–11)
取樣需要起點。高斯在離散空間沒有定義,最普通的選擇是均勻分佈 21:45:每個序列機率一樣,等於每個位置各抽一個均勻的 token。接著我們想要:
$$X_0\sim p_{\text{init}},\qquad X_{t+h}\sim p_{t+h\mid t}(\cdot\mid X_t)$$但這行不通 23:49:我們有的是速率,不是轉移機率。解法和 Euler 法一樣,做一階 Taylor 展開 24:19:
$$\begin{aligned}&p_{t+h\mid t}(y\mid x)\\&\approx p_{t\mid t}(y\mid x)\\&\quad+h\frac{\mathrm d}{\mathrm dh}\Big|_{h=0}p_{t+h\mid t}(y\mid x)\\&=\delta_y(x)+hQ_t^\theta(y\mid x)\end{aligned}$$第一項:時間沒過,人還在原地,所以 \(y=x\) 時機率是 1,否則是 0,這就是 \(\delta_y(x)\)。第二項:定義。
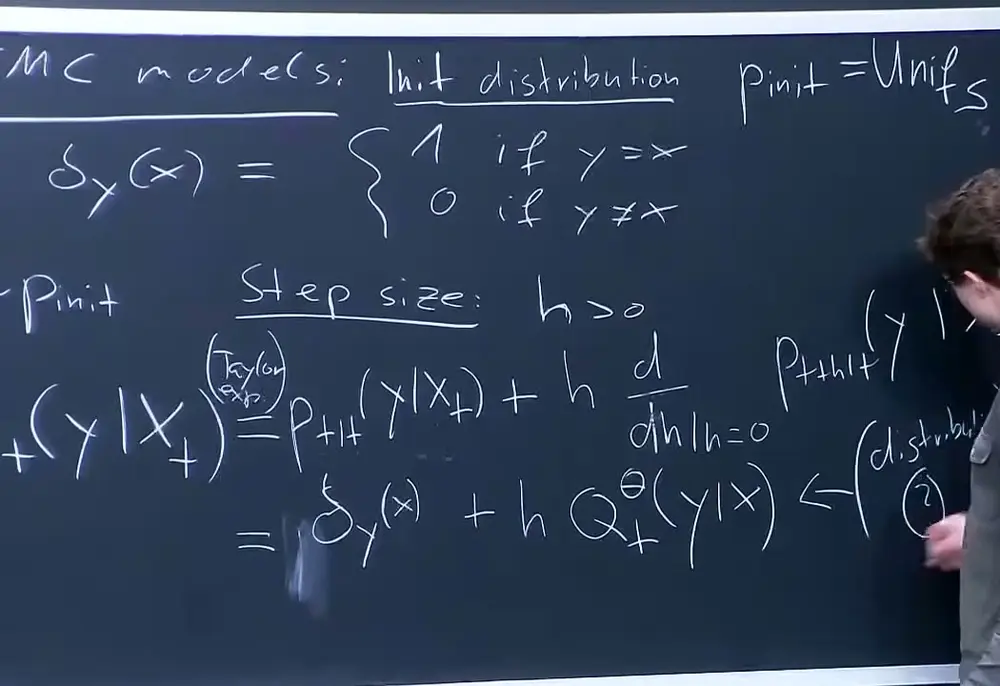
老師接著問:這真的是機率分佈嗎 26:57?對 \(y\) 加起來:
$$\begin{aligned}&\sum_y\big(\delta_y(x)+hQ_t^\theta(y\mid x)\big)\\&=1+h\cdot0=1\end{aligned}$$靠的就是 (R2) 的「每行和為 0」,這也是當初那樣設計的原因。另外還要不能是負的:\(y\ne x\) 時 \(hQ\ge0\) 沒問題;\(y=x\) 時要 \(1+hQ_t(x\mid x)\ge0\),也就是 \(h\) 要夠小,小到 \(h\times\) 總離開速率 \(\le1\)。講義說的「for small \(h\)」就是這個條件;Demo A 可以看到超過時會怎樣。
每個位置分開更新
因子化之後,實作上每個位置各自獨立更新(投影片 10,也叫 τ-leaping),而且可以平行 27:57:
| 行 | 演算法 |
|---|---|
| 1–3 | \(t\leftarrow0,\ h\leftarrow1/n\),抽 \(X_0\sim p_{\text{init}}\) |
| 4–5 | 做 \(n\) 次:一次 forward pass(把輸入跑過網路一次),得到 \(d\times V\) 的速率表 \(q_j(v)\) |
| 6–8 | 對每個位置 \(j\)(平行):令 \(x\) 是目前的 token,定義 \(\tilde p_j(v\mid x)\):\(v\ne x\) 時是 \(hq_j(v)\),\(v=x\) 時是 \(1-h\sum_{v'\ne x}q_j(v')\) |
| 9 | 從這個類別分佈(有限個結果,各有一個機率)抽出新的 token |
| 11–13 | \(t\leftarrow t+h\),最後回傳 \(X_1\) |
老師說沒有時間解釋為什麼可以這樣做 27:27,這裡補上。這和精確的一步有什麼差別?獨立更新時,兩個位置可能在同一步都跳,但鄰居限制說這個速率是 0。差多少?
延伸:補充課 G §6 用具體例子講 τ-leaping 的代價。
Demo A兩狀態 CTMC
- \(\lambda=1\)、\(h=0.01\):藍線貼著橘線。\(t=1\) 精確值 0.568,3000 條鏈實測 0.560。把 \(\lambda\) 拉大,曲線掉得更快,軌跡也跳得更頻繁。
- \(h=0.25\)、\(0.5\):藍線開始偏離,\(t=1\) 的理論值是 0.531、0.500。原因:精確解每過 \(h\),\(u=p_a-p_b\) 乘上 \(e^{-2\lambda h}\);Euler 乘的是它的一階近似 \(1-2\lambda h\)。\(h\lambda=0.5\) 時這個數是 0,一步就到一半。
- \(h=0.8\)、\(1.2\):\(h\lambda=0.8\) 時 \(1-2\lambda h=-0.6\) 是負的,藍線上下鋸齒震盪,\(t=0.8\) 時是 0.200,精確值 0.601:還是機率,但完全錯了。\(h\lambda=1.2\) 時留下的機率是 \(-0.20\),根本不能抽,這就是第 5 節的條件。
06目標與配方(投影片 12–14)
到這裡有了模型,還不知道怎麼訓練。目標和第 1 講一字不差,只把 ODE 換成 CTMC、高斯換成均勻分佈 32:31:
配方也一樣。投影片 13 是第 2 講的三行兩列;投影片 14 把向量場換成速率矩陣,最後一欄合成一格(老師說這裡比較簡單,第 15 節再說明)。
| 路徑 | 要學的場 | 損失 | |
|---|---|---|---|
| 條件 | \(p_t(x\mid z)\) | \(Q_t^z(y\mid x)\) | DFM loss |
| 邊際 | \(p_t(x)\) | \(Q_t(y\mid x)\) |
接下來四節照這張表一格一格走。
07機率路徑(投影片 15–19)
定義和第 2 講幾乎相同,只是積分換成加總 34:32。條件機率路徑是一組 \(S\) 上的分佈 \(p_t(x\mid z)\),兩端滿足:
$$p_0(\cdot\mid z)=p_{\text{init}},\qquad p_1(\cdot\mid z)=\delta_z$$也就是一開始完全不知道 \(z\),最後全部質量都在 \(z\) 上。對資料平均,就是邊際機率路徑:
$$p_t(x)=\sum_{z\in S}p_t(x\mid z)\,p_{\text{data}}(z)$$代入 \(t=0\):\(\sum_zp_{\text{init}}(x)p_{\text{data}}(z)=p_{\text{init}}(x)\),因為 \(p_{\text{data}}\) 加起來是 1。代入 \(t=1\):\(\sum_z\delta_z(x)p_{\text{data}}(z)=p_{\text{data}}(x)\),因為只有 \(z=x\) 那一項留下。所以邊際路徑確實連接雜訊和資料。
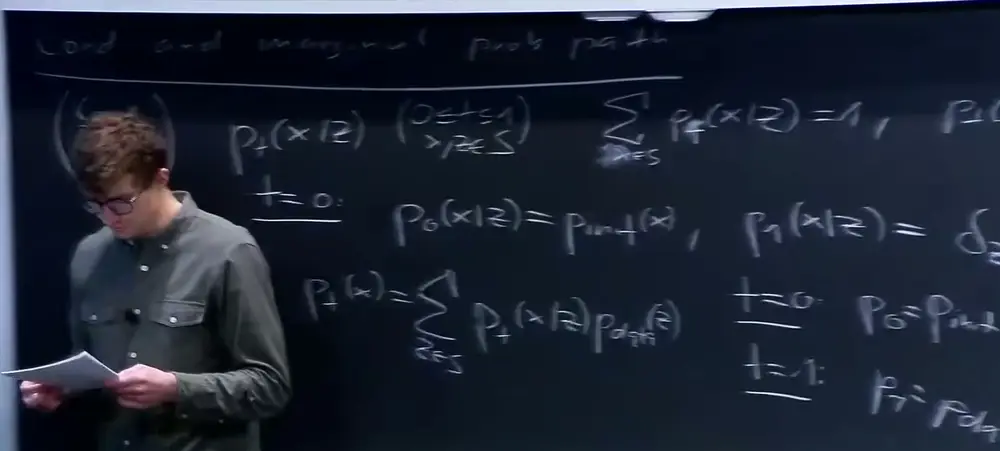
Factorized mixture path
最常用的例子。取排程 \(\kappa_t\),\(\kappa_0=0,\kappa_1=1\),遞增(投影片的小圖用 \(\kappa_t=t^{0.7}\))。每個位置各自獨立,把均勻分佈和「資料的尖峰」混起來 38:12:
實際抽樣很簡單 39:14:每個位置擲一枚硬幣,決定留資料或換成雜訊。下面的 \(\text{Bernoulli}(\kappa_t)\) 就是這枚硬幣,機率 \(\kappa_t\) 得 1,否則得 0。
$$\begin{gathered}m_j\sim\text{Bernoulli}(\kappa_t),\quad\xi_j\sim p_{\text{init}}^{(j)}\\x_j=m_jz_j+(1-m_j)\xi_j\end{gathered}$$為什麼這就是上面的公式?\(x_j=v\) 有兩條路:硬幣留資料而且 \(z_j=v\),機率 \(\kappa_t\delta_{z_j}(v)\);或硬幣換雜訊而且雜訊剛好是 \(v\),機率 \((1-\kappa_t)p_{\text{init}}^{(j)}(v)\)。兩者相加就是方括號,各位置獨立就是連乘。
投影片紅框要你自己檢查它是條件路徑:\(t=0\) 時 \(\kappa=0\),方括號是 \(p_{\text{init}}^{(j)}(x_j)\),連乘是 \(p_{\text{init}}(x)\) ✓。\(t=1\) 時 \(\kappa=1\),方括號是 \(\delta_{z_j}(x_j)\),連乘只有所有位置都對才是 1,就是 \(\delta_z(x)\) ✓。
- 投影片 15 寫「Noise each token independently with probability \(\kappa_t\)」。從公式看,加雜訊的機率是 \(1-\kappa_t\),\(\kappa_t\) 是留下資料的機率。老師後來也改口 59:25,講義也寫 \(1-\kappa_t\)。
- 講義寫排程要滿足 \(\frac{\mathrm d}{\mathrm dt}\dot\kappa_t\ge0\),多了一次微分,應該是 \(\dot\kappa_t\ge0\),也就是遞增。第 9 節會看到,否則速率會變成負的。
淡入淡出,不是搬運
這是和第 2 講最大的差別 40:46。投影片 16 是第 2 講的玩具例子,投影片 17、19 把它離散化成格點,投影片 18 提醒:機率是 teleported,不是在空間裡移動。高斯路徑會把質量推過去,中間狀態有質量走在路上;這裡完全不走路,一邊變淡、另一邊變濃。老師說,從運輸變成了淡入淡出 40:46。
講義的圖解釋得更清楚:上面一列是條件路徑(最後變成單一格子),下面一列是邊際路徑(最後變成棋盤)。Demo B 就是這張圖,而且可以真的用 CTMC 跑。老師也提醒,這個路徑目前還沒有用處,只是先指定「資料怎麼被破壞」41:16。
08Kolmogorov forward equation(投影片 20)
為了下面的證明,需要一條描述「分佈怎麼隨時間變」的式子。它是第 2 講連續方程的離散版本 49:34。
注意 \(Q_t(x\mid y)\) 是從 \(y\) 到 \(x\),方向和 \(y\) 當目的地時相反。把 \(y=x\) 那一項拆出來,用 (R2) 改寫,意思就很清楚:
$$\begin{aligned}\frac{\mathrm d}{\mathrm dt}p_t(x)&=\underbrace{\sum_{y\ne x}Q_t(x\mid y)p_t(y)}_{\text{流入}}\\&\quad-\underbrace{\sum_{y\ne x}Q_t(y\mid x)p_t(x)}_{\text{流出}}\end{aligned}$$第 3 節的 \(p_a'=\lambda p_b-\lambda p_a\) 就是它。
為什麼成立
先證必要性:假設 \(X_t\sim p_t\)。第一步把 \(t\) 的導數寫成 \(h\) 的導數,第二步是全機率公式(現在在 \(x\),對 \(h\) 之前在哪裡分情況),第三步交換加總和導數,第四步是演化條件:
$$\begin{aligned}&\frac{\mathrm d}{\mathrm dt}p_t(x)=\frac{\mathrm d}{\mathrm dh}\Big|_{h=0}p_{t+h}(x)\\&=\frac{\mathrm d}{\mathrm dh}\Big|_{h=0}\sum_yp_{t+h\mid t}(x\mid y)p_t(y)\\&=\sum_y\Big[\frac{\mathrm d}{\mathrm dh}\Big|_{h=0}p_{t+h\mid t}(x\mid y)\Big]p_t(y)\\&=\sum_yQ_t(x\mid y)p_t(y)\end{aligned}$$充分性:把 \(p_t\) 看成一個向量,KFE 就是線性 ODE \(\dot p_t=Q_tp_t\)。起點相同、方程相同,解唯一(ODE 的存在唯一性)。所以任何滿足 KFE 的 \(p_t\) 都一定是 CTMC 的真實分佈。
延伸:補充課 G §3 把這條式子叫 master equation,手算了三狀態的例子,並連到 \(e^{tQ}\)(那裡的記號 \(Q(j,i)\) 是 \(i\to j\))。
09條件速率矩陣(投影片 21–24)
第二格:對每個資料點 \(z\),要一個 \(Q_t^z\),它的 CTMC 會沿著條件路徑走 42:18:
$$\begin{aligned}&X_0\sim p_{\text{init}},\ X_t\text{ 是 }Q_t^z\text{ 的 CTMC}\\&\Rightarrow\ X_t\sim p_t(\cdot\mid z)\end{aligned}$$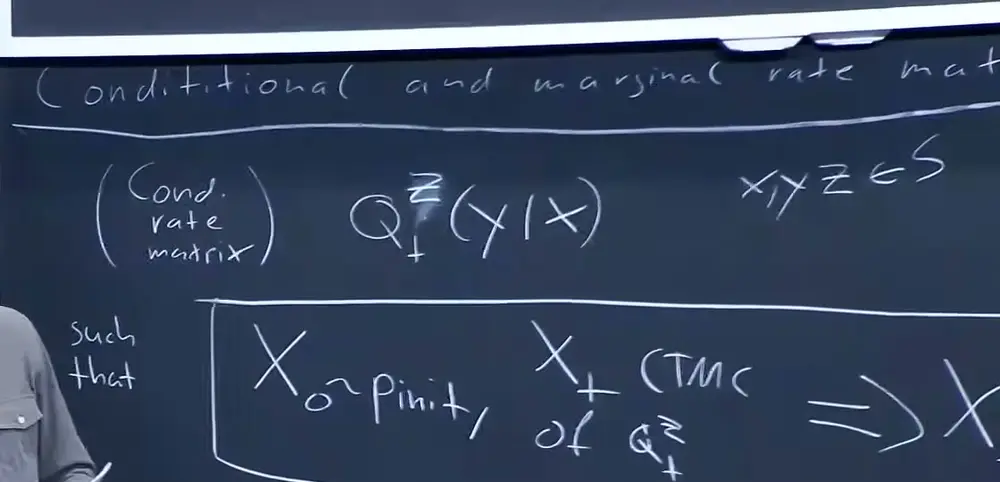
Factorized mixture path 的答案非常簡單 55:47。每個位置只有一個規則:如果現在不對,就以某個速率跳到正確的 token;如果已經對了,就不動。
把四種情況列出來(係數都乘上 \(\dot\kappa_t/(1-\kappa_t)\)):
| 情況 | 係數 | 意思 |
|---|---|---|
| \(x_j=z_j\) | 0 | 已經對了,全部是 0 |
| \(x_j\ne z_j\),\(v_i=z_j\) | 1 | 跳到正確的 token |
| \(x_j\ne z_j\),\(v_i\ne z_j\) 也 \(\ne x_j\) | 0 | 不去錯的地方 |
| \(x_j\ne z_j\),\(v_i=x_j\) | \(-1\) | 負的離開速率,(R2) |
投影片 21 和講義的第三種情況寫成 \(v_i\ne z_j,x_j\ne z_j\),沒有排除 \(v_i=x_j\),和第四種重疊;上面的表補上了。另外投影片 21 寫「rates only non-negative for one token updates」,意思應該是 non-zero:多個 token 的速率是 0。
因子 \(\dot\kappa_t/(1-\kappa_t)\) 從哪裡來
講義直接驗算(下面會做)。先用一個更直接的想法看它為什麼長這樣。一個位置「還沒對」的機率是多少?條件路徑說,不對的機率是 \((1-\kappa_t)(1-\tfrac1V)\),正比於 \(1-\kappa_t\)。設 \(s(t)=1-\kappa_t\)。如果「還沒對的」都以速率 \(r_t\) 跳到正確的 token,那麼每單位時間 \(s\) 減少 \(r_ts\):
$$\begin{aligned}\dot s&=-r_t\,s\\-\dot\kappa_t&=-r_t(1-\kappa_t)\\r_t&=\frac{\dot\kappa_t}{1-\kappa_t}\end{aligned}$$所以速率就是「要減少的量,除以還剩下的量」。這也解釋了為什麼 \(\dot\kappa_t\ge0\) 是必要的(否則速率是負的)。
因子在 \(t\to1\) 時爆炸(投影片 23)。老師的解釋是 58:21:到 \(t=1\) 時必須百分之百在正確的位置,如果現在還不對,就得趕快跳。上面的式子也看得出來:剩下的越少,同樣的減少量要的速率越高。
補充(講義沒提):第 2 節的存在唯一定理要求 \(Q_t\) 有界,這裡在 \(t=1\) 無界。實作上不會碰到,因為取樣最後算的是 \(t=1-h\)。
驗證它真的走在路徑上
各位置獨立,所以先看單一位置(\(d=1\),寫成 \(p_{\text{init}}(x)\)、\(z\)),驗算 KFE。定義 \(c=\dot\kappa_t/(1-\kappa_t)\)。從路徑微分開始:
$$\begin{aligned}&\frac{\mathrm d}{\mathrm dt}p_t(x\mid z)\\&=\frac{\mathrm d}{\mathrm dt}\big[(1-\kappa_t)p_{\text{init}}(x)+\kappa_t\delta_z(x)\big]\\&=\dot\kappa_t\big(\delta_z(x)-p_{\text{init}}(x)\big)\end{aligned}$$把 \(\dot\kappa_t\) 寫成 \(c(1-\kappa_t)\),分配進去。\((1-\kappa_t)\delta_z(x)\) 拆成 \(\delta_z(x)-\kappa_t\delta_z(x)\),後面兩項合起來正好是 \(p_t(x\mid z)\):
$$\begin{aligned}&c\big[(1-\kappa_t)\delta_z(x)\\&\quad-(1-\kappa_t)p_{\text{init}}(x)\big]\\&=c\big[\delta_z(x)-\kappa_t\delta_z(x)\\&\quad-(1-\kappa_t)p_{\text{init}}(x)\big]\\&=c\big(\delta_z(x)-p_t(x\mid z)\big)\end{aligned}$$另一邊算 KFE 的右邊。\(y\ne x\) 時 \(Q_t^z(x\mid y)=c\,\delta_z(x)\)(目的地 \(x\) 是 \(z\) 才有速率);\(y=x\) 時 \(Q_t^z(x\mid x)=c(\delta_z(x)-1)\)。所以:
$$\begin{aligned}&\sum_yQ_t^z(x\mid y)p_t(y\mid z)\\&=c\,\delta_z(x)\sum_{y\ne x}p_t(y\mid z)\\&\quad+c(\delta_z(x)-1)p_t(x\mid z)\\&=c\,\delta_z(x)\big(1-p_t(x\mid z)\big)\\&\quad+c(\delta_z(x)-1)p_t(x\mid z)\\&=c\big(\delta_z(x)-p_t(x\mid z)\big)\end{aligned}$$兩邊相等 ✓。中間用了機率總和是 1:\(\sum_{y\ne x}p_t(y\mid z)=1-p_t(x\mid z)\)。最後一步展開後 \(\delta_z(x)p_t(x\mid z)\) 一正一負消掉。
左邊:\(\frac{\mathrm d}{\mathrm dt}p(A)=\frac{\mathrm d}{\mathrm dt}\big(\tfrac{1-t}3+t\big)=\tfrac23\)。右邊:從 \(B\) 和 \(C\) 流入 \(2\cdot\tfrac16+2\cdot\tfrac16=\tfrac23\) ✓。
\(B\) 也一樣:左邊 \(-\tfrac13\);右邊沒有流入,流出 \(2\cdot\tfrac16=\tfrac13\) ✓。
多個位置:連乘的導數是每次微一個因子(乘積法則),例如 \(d=2\):
$$\begin{aligned}&\frac{\mathrm d}{\mathrm dt}\big[p^{(1)}(x_1)p^{(2)}(x_2)\big]\\&=\dot p^{(1)}(x_1)\,p^{(2)}(x_2)+p^{(1)}(x_1)\,\dot p^{(2)}(x_2)\end{aligned}$$第一項只有第一個位置在跳,第二項只有第二個位置在跳。所以一次只改一個位置的因子化速率,剛好對應這兩項。這就是講義說「可以假設 \(d=1\)」的原因。
10離散 marginalization trick(投影片 25)
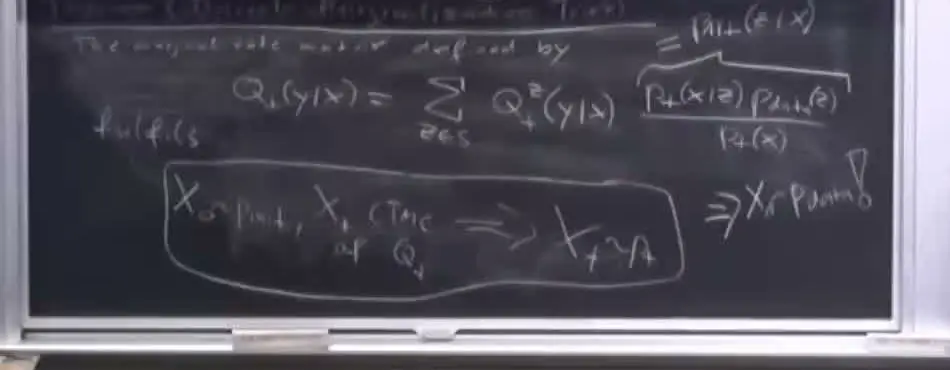
條件速率矩陣本身沒用:它已經知道終點 \(z\),只會生成那一個資料點 46:57。要把它變成不知道 \(z\) 也能用的東西。做法和第 2 講一模一樣:對後驗平均 44:23。
讀法:現在在 \(x\),不知道終點是誰。對每個可能的終點 \(z\),看「如果它是終點,我該怎麼跳」,再用「它是終點的機率」加權。後驗 \(p_{1\mid t}(z\mid x)\) 是貝氏定理:先驗 \(p_{\text{data}}(z)\) 乘上概似 \(p_t(x\mid z)\),除以 \(p_t(x)\)。
為什麼是合法的速率矩陣(投影片沒寫,講義只陳述):每個 \(Q_t^z\) 的非對角 \(\ge0\)、每行和為 0,乘上非負權重再加起來,這兩個性質都保留。
證明(照黑板,每一步補上理由)
要證的是 \(Q_t\) 滿足 KFE,然後第 8 節的「若且唯若」就結束了 52:07:
$$\begin{aligned}&\frac{\mathrm d}{\mathrm dt}p_t(x)\\&\overset{(i)}{=}\frac{\mathrm d}{\mathrm dt}\sum_zp_t(x\mid z)p_{\text{data}}(z)\\&\overset{(ii)}{=}\sum_z\Big[\frac{\mathrm d}{\mathrm dt}p_t(x\mid z)\Big]p_{\text{data}}(z)\\&\overset{(iii)}{=}\sum_z\Big[\sum_yQ_t^z(x\mid y)p_t(y\mid z)\Big]\\&\qquad\quad\cdot p_{\text{data}}(z)\\&\overset{(iv)}{=}\sum_yp_t(y)\Big[\sum_zQ_t^z(x\mid y)\\&\qquad\quad\cdot\frac{p_t(y\mid z)p_{\text{data}}(z)}{p_t(y)}\Big]\\&\overset{(v)}{=}\sum_yQ_t(x\mid y)\,p_t(y)\end{aligned}$$- \((i)\):邊際路徑的定義。\((ii)\):\(p_{\text{data}}\) 不依賴 \(t\),導數可以穿過加總。
- \((iii)\):這是整個證明的關鍵:對條件路徑用 KFE,因為 \(Q_t^z\) 就是這樣定義的。
- \((iv)\):交換兩個加總,然後乘一個 \(p_t(y)\) 再除一個 \(p_t(y)\)(\(p_t(y)=0\) 時,每個 \(p_t(y\mid z)p_{\text{data}}(z)\) 都是 0,那一項本來就沒有貢獻)。
- \((v)\):方括號正好是 \(Q_t(x\mid y)\) 的定義,只是起點叫 \(y\)。
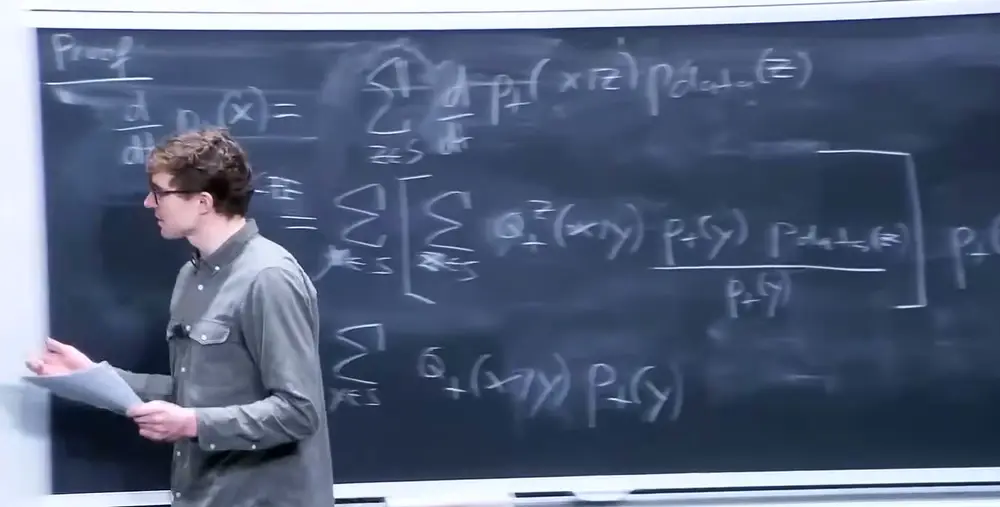
投影片 25 左欄把 \(Q_t(y\mid x)\) 叫「Marginal Vector Field」,標題還留著「and Score」,都是從連續版複製過來的;老師在 59:55 也說是筆誤,應該是 marginal rate matrix。
Demo B淡入淡出的路徑
- 棋盤、\(n=100\):拖 \(t\),格子是原地變濃或變淡,沒有東西在移動。\(t=0.5\) 時 TV 是 0.070,\(t=1\) 時對資料是 0.060。4000 個粒子撒在 72 個格子上,光抽樣誤差就有約 0.05,所以這已經是極限了。粒子只靠每個位置的跳躍,就學會了棋盤這種兩個 token 相關的分佈。
- 改步數:\(t=1\) 對資料的 TV,棋盤是 0.167(\(n=5\))、0.085(20)、0.060(100);對角線是 0.319、0.085、0.028。步數少時,一步的跳躍機率很大,兩個位置常常同時跳,還沒「看到」對方的新值。這就是第 5 節說的離散化誤差。
- 單一點(第 9 節的條件 CTMC):不管幾步,TV 都是 0.000,每個 token 平均跳 0.92 次:剛好是 \(1-\tfrac1{12}\),因為有 \(\tfrac1{12}\) 的機率一開始就抽對,不用跳。改 \(\kappa=t^2\):路徑的時間表變了,終點不變(棋盤 \(n=100\) 是 0.065);但 \(n=5\) 時單一點的 TV 變成 0.099,因為這個排程最後一步的 \(h\times\) 速率只有 0.889,不到 1,有些 token 來不及跳。
公式
粒子
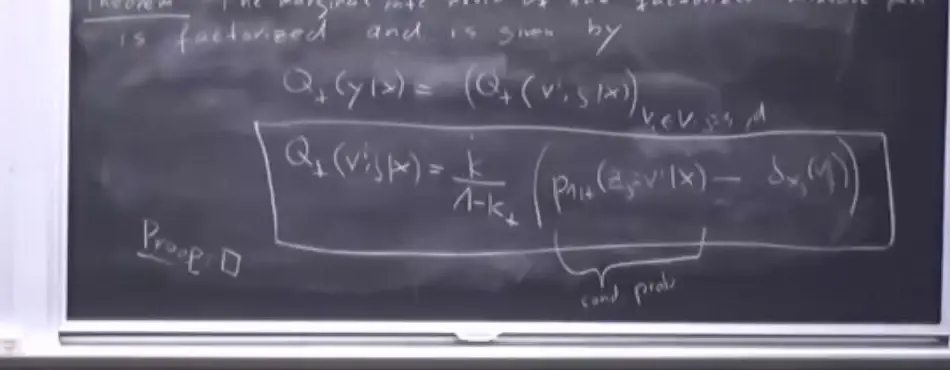
11邊際速率只差一個分類器(投影片 26)
定理的公式要對 \(V^d\) 個 \(z\) 加總,看起來還是不能算。但 factorized mixture path 有一個漂亮的結果 62:15:
和條件版只差一個地方:已知的終點 \(\delta_{z_j}(v_i)\) 換成了「終點是 \(v_i\) 的機率」64:43。其他都知道,這是唯一的未知量。
證明。先看因子化:\(x,y\) 不是鄰居時,每個 \(Q_t^z(y\mid x)\) 都是 0,加權平均還是 0。接著代入定理,把不依賴 \(z\) 的部分提出來(\(c=\dot\kappa_t/(1-\kappa_t)\)):
$$\begin{aligned}&Q_t(v_i,j\mid x)\\&=\sum_zQ_t^z(v_i,j\mid x)\,p_{1\mid t}(z\mid x)\\&\overset{(i)}{=}c\sum_z\big(\delta_{z_j}(v_i)-\delta_{x_j}(v_i)\big)\\&\qquad\quad\cdot p_{1\mid t}(z\mid x)\\&\overset{(ii)}{=}c\Big(\sum_z\delta_{z_j}(v_i)p_{1\mid t}(z\mid x)\\&\qquad\quad-\delta_{x_j}(v_i)\Big)\\&\overset{(iii)}{=}c\big(p_{1\mid t}(z_j=v_i\mid x)-\delta_{x_j}(v_i)\big)\end{aligned}$$\((i)\) 代入條件速率。\((ii)\) \(\delta_{x_j}(v_i)\) 不依賴 \(z\),提出來後剩 \(\sum_zp_{1\mid t}(z\mid x)=1\)。\((iii)\) 把所有 \(z_j=v_i\) 的 \(z\) 的機率加起來,就是 \(z_j=v_i\) 的邊際機率。
手算:資料只有 aa 和 bb
取最小的例子:\(d=2\),字母表 \(\{a,b\}\),\(p_{\text{data}}\) 是 aa、bb 各一半,均勻雜訊,\(\kappa_t=t\)。兩個 token 完全相關,但每個位置單獨看都是一半一半。在 \(t=0.5\),因子 \(c=2\),單一位置「對」的機率是 \(0.25+0.5=0.75\),「不對」是 \(0.25\)。
現在 \(x=\) ab:\(p_t(x\mid\text{aa})=0.75\times0.25=0.1875\),\(p_t(x\mid\text{bb})\) 也是 \(0.1875\),後驗各半。位置 1 換成 b:\(2\times0.5=1\);位置 2 換成 a:也是 \(1\)。速率比 aa 時大 5 倍:序列不合法,所以比較急著改。
Demo C後驗與速率
- 起點 uniform、\(t=0.50\)、x = (a, a):應該看到上面手算的 0.9、0.1、速率 0.2。
- 改成 x = (a, b):後驗回到 0.5、0.5,速率變成 1:序列不合法,急著改。
- 起點 mask、x = (a, M):後驗是 1 和 0。位置 1 全部是 0(不會再動),位置 2 的 M 只會跳到 a(圖在第 13 節)。
- 調 \(P(\text{aa})\):先驗直接影響後驗。\(t\) 越接近 1,先驗越不重要。
12損失與訓練(投影片 27–28)
老師的重點 67:21:這是一個條件機率,換句話說就是分類器,而分類大家都會訓練。
網路輸入含噪序列 \(x\)(和時間 \(t\)),輸出 \(d\times V\) 的表,每個位置過一次 softmax,就是這個位置的 \(V\) 類分類。損失是每個位置的交叉熵:
為什麼這樣學到的是後驗
訓練時用的是真實的 \(z_j\),沒有人告訴網路「後驗」是多少。為什麼學得到?先看最簡單的情況:固定 \(x\),兩類。設真實的機率是 \(\pi\),網路輸出 \(q\)。平均損失是:
$$f(q)=-\pi\log q-(1-\pi)\log(1-q)$$對 \(q\) 微分,令它為 0:
$$\begin{aligned}f'(q)=-\frac\pi q+\frac{1-\pi}{1-q}&=0\\\pi(1-q)&=(1-\pi)q\\q&=\pi\end{aligned}$$也就是最小值正好是真實機率(\(V\) 類也一樣,這是交叉熵的基本性質)。而資料的抽法是:先抽 \(z\),再抽 \(x\)。同一個 \(x\) 會由不同的 \(z\) 產生,比例正好是後驗 \(p_{1\mid t}(z\mid x)\)。所以網路對這個 \(x\) 看到的標籤,平均起來就是後驗。
這和第 2 講的 conditional flow matching 是同一招:用條件的目標訓練,學到的是邊際的量。那裡是回歸,最佳解是條件平均;這裡是分類,最佳解是條件機率。老師的總結 71:56:flow matching 到頭來就是回歸,discrete flow matching 到頭來就是分類。
演算法
| 投影片 28 的行 | 做什麼 |
|---|---|
| 2 | 抽一筆資料 \(z\) |
| 3 | 抽 \(t\sim\text{Unif}[0,1]\),算 \(\kappa=\kappa_t\) |
| 4–10 | 破壞資料:每個位置 \(m_j\sim\text{Bernoulli}(\kappa)\)、\(\xi_j\sim p_{\text{init}}^{(j)}\)、\(x_j=m_jz_j+(1-m_j)\xi_j\) |
| 11 | forward pass:\(\ell_j=f_\theta(x,t)_j\),softmax 得到每個位置的機率 |
| 12 | \(\mathcal L=\sum_j-\log p^\theta_{1\mid t}(z_j\mid x)\) |
| 13 | 更新參數 |
\(f_\theta\) 可以就是一般的 transformer,不用改 70:55。訓練完,用第 5 節的演算法取樣,把預測的機率代入邊際速率。整個流程完全沒有用到 CTMC 的模擬,訓練時只抽一個 \(t\)、破壞一次資料,和 flow matching 一樣是 simulation-free。
13Masked diffusion(投影片 29–36)
實務上常見的版本 72:27:不用均勻雜訊,在字母表裡加一個新 token [MASK],它只用來告訴模型「這裡的資訊沒了」。起點是全部遮住:
$$p_{\text{init}}=\delta_{[\text{MASK}]^d}$$破壞資料就是「每個位置以機率 \(1-\kappa_t\) 遮住」。這是前面框架的特例,公式都不用改。
代入公式會發生什麼(補充,老師沒有推)
看邊際速率。兩種情況:
- \(x_j\) 已經不是 [MASK]:在這條路徑上,非 mask 的 token 一定是真的(雜訊只會是 mask)。所以 \(p_{1\mid t}(z_j=x_j\mid x)=1\),其他是 0。代入公式,速率全是 0:揭開之後就不會再改。
- \(x_j\) 是 [MASK]:跳到 \(v\) 的速率是 \(\frac{\dot\kappa_t}{1-\kappa_t}p_{1\mid t}(z_j=v\mid x)\)。對所有 \(v\) 加起來,因為 \(z_j\) 不可能是 mask,總和是 \(\frac{\dot\kappa_t}{1-\kappa_t}\)。
第二點很有趣:每個位置「什麼時候揭開」的速率,和網路輸出無關。\(\kappa_t=t\) 時,\(t\) 時刻已揭開的比例就是 \(t\);網路決定的只有「揭開成什麼」。
Mask 版本還直接解決了加條件的問題:你想固定的部分就不要遮 76:36。例如改一段程式碼的中間:只遮那一段,其他留著。這也回答了第 5 節的問題。
延伸:CS236 第 18 講(SEDD)用另一條路做離散 diffusion:先定一個加噪的 CTMC,再用機率比值把它倒過來(補充課 G §5),學的是 score 的比值。均勻和 absorbing(類似 mask)兩種雜訊在補充課 G §4 有比較。注意 CS236 的 \(t=0\) 是資料,時間方向相反。書的 B32 講的也是這個主題。
Demo D訓練一個小模型
- mask、\(n=20\):補位正確 97.3%(獨立抽 74.0%),bigram 分數 −2.304(獨立抽 −2.932,真實名字 −2.054)。樣本有 ishan、karlen、zayven、clayson,也有 dahmk 這種不太像的。只有 1.3% 剛好是訓練集裡的名字,所以它不是在背資料。
- 揭開的比例:\(t=0.5\) 時,\(n=20\) 是 50.4%、\(n=100\) 是 49.6%,和網路無關,就是第 13 節算的 \(\kappa_t\)。看軌跡:順序是亂的。\(n=5\) 顯示 60.8%,是因為最接近 0.5 的格子是 \(t=0.6\)。
- 損失:mask 在 \(t=0\) 是 17.6(什麼都沒看到,只能猜邊際分佈),\(t=0.5\) 是 8.9,\(t=0.95\) 是 1.67。uniform 同樣的時間是 18.4、12.2、3.87,比較高,因為它分不出哪個 token 是真的、哪個是雜訊。uniform 的軌跡裡,token 也會被改好幾次(mask 不會)。
- 固定 token:選「第 1 個是 m」,mask 模型生成 mareel、martin、marise 這類名字,不用重新訓練:這就是第 13 節說的編輯。這只是近似:網路訓練時,\(t=0\) 從來沒看過已揭開的 token。「第 4 個是 a、最長 6」的 bigram 分數 −1.895 比真實名字還高,不是模型變好:名字變短,補位多,_ 接 _ 的分數很高,不能拿來比。
訓練完:不同 \(t\) 的損失。
14和自迴歸模型比較(投影片 37)
老師說這還在爭論,兩邊都有取捨,他不打算告訴你誰比較好,留給這個領域和未來決定 77:38。
| 投影片的說法 | 說明 | |
|---|---|---|
| 優點 | 多個 token 平行生成 → 更快? | 自迴歸模型(ChatGPT 那種)一次一個、由左到右 |
| 任何順序生成 → 文字編輯? | 只遮住想改的那段程式碼,其他固定 76:06 | |
| 新的機率路徑 → 能設計有語意的嗎? | 例如路徑本身是摘要一段文字;現在的路徑都很簡單 76:36 | |
| 缺點 | 沒有 KV caching → 更慢? | 工程上的挑戰;老師說有人在做,可能會解決 77:06 |
| 要學會任意順序生成 → 更難學? | 可能更難,也可能更容易 | |
| 由左到右本身有語意 → 值得嗎? | 他舉例:把他講的話寫下來,就是從左到右;他也不會從最後一張投影片開始講 77:38 |
什麼是 KV caching(背景補充,非課堂內容)
第 4 講的 attention 要用 key 和 value。自迴歸生成時,已經生成的 token 不會改,它們的 key、value 也不會變,算過一次存起來,每個新 token 只要算自己那一份。Diffusion 模型每一步都可能改很多位置,輸入每步都不同,每一步通常要重新跑整段序列。所以「平行生成所以比較快」和「不能用快取所以比較慢」是互相拉扯的。
老師最後補一個例子 78:08:由左到右的順序在某些應用沒那麼重要,比如蛋白質序列,沒有像句子那樣由左往右累積語意的結構(DNA 雖然是單向轉錄,但整體也不是)。所以大家可能會依應用選擇。
15Generator matching 與全課回顧(投影片 38–42)
投影片 38、39 是第 6 節那兩張表的複習。老師說明了那個合併的格子 79:08:其實離散版本也有條件損失和邊際損失,他為了省時間跳過了。
那個合併的格子(背景補充)
連續版的條件和邊際損失只差一個和 \(\theta\) 無關的常數,所以梯度相同。離散版也一樣:DFM 損失(條件形式)對每個 \(x\)、\(j\) 是 \(-\sum_vp_{1\mid t}(v\mid x)\log q(v)\),它等於「後驗和 \(q\) 的 KL」(邊際形式)加上「後驗的熵」(分佈本身的不確定度),而熵不依賴 \(\theta\)。訓練只會用到條件形式,所以投影片合成一格。
為什麼同一個配方在向量場和速率矩陣上都行得通(投影片 40)?老師說他整堂課都沒提自己的研究,最後提一下 79:39:這個原理跟 ODE 和 CTMC 其實都沒什麼關係,它只需要一個 Markov 過程。這就是 Generator Matching(Holderrieth et al.)。講義的 remark 補充:generator 是向量場和速率矩陣的推廣,可以針對各種資料和狀態空間建模,例如流形上的幾何資料、文字加影像的混合狀態、跳躍過程。
配方的骨架是:
- 選一條從雜訊到單一資料點的條件路徑。
- 找到走在這條路徑上的條件「generator」(向量場、速率矩陣……)。
- 對後驗平均,得到邊際的;用該過程的守恆方程(連續方程、KFE……)證明它走在邊際路徑上。
- 用條件的目標訓練,學到邊際的量。
五講的主線:
| 講 | 問的問題 | 答案 |
|---|---|---|
| 1 | 怎麼把雜訊變成資料? | 解 ODE/SDE |
| 2 | 向量場怎麼學? | flow matching:條件目標+回歸 |
| 3A、3B | 加雜訊的 SDE 呢?提示詞呢? | score matching;classifier-free guidance |
| 4 | 高維度的真實影像呢? | latent space、DiT |
| 5 | 沒有向量的資料呢? | CTMC、速率矩陣;分類 |
投影片 41、42 是課程回顧和致謝。這是這門課的最後一講 80:11,沒有 Lab。
常見誤解
- 「Discrete diffusion 裡有擴散。」沒有 SDE、也沒有 ODE。過程是 CTMC,「diffusion」只是歷史名字。
- 「速率就是機率。」速率乘上很短的時間才近似機率,它可以大於 1。對角線還是負的。
- 「\(Q_t(y\mid x)\) 是 \(y\) 到 \(x\)。」條件號右邊是出發點,所以是 \(x\to y\)。KFE 裡的 \(Q_t(x\mid y)\) 是 \(y\to x\)。
- 「路徑把機率搬過去。」Mixture path 沒有搬運,只是淡入淡出;中間的狀態不需要「在路上」。
- 「\(\kappa_t\) 是加雜訊的機率。」投影片 15 這樣寫,但其實 \(\kappa_t\) 是留下資料的機率,加雜訊是 \(1-\kappa_t\)。
- 「條件速率每個位置獨立,所以生成的 token 也獨立。」條件路徑是獨立的,邊際不是。邊際速率的後驗看的是整段 \(x\),相關性就在那裡(Demo D 的「獨立抽」對照)。
- 「速率爆炸所以取樣會出問題。」Euler 算的是 \(h\times\) 速率;\(\kappa_t=t\) 時最後一步剛好是 1。
- 「CFG 可以照搬。」老師的說法是,CFG 靠向量相加,token 沒有向量可加,所以不能照第 3 講那樣做 31:30。他沒有說離散模型不能加條件:可以把提示詞當成額外的輸入,mask 版本還可以直接固定不想改的部分(第 13 節)。
自我測驗
1. 為什麼文字不能用 ODE 或 SDE?
2. \(Q=\begin{pmatrix}-3&1\\3&-1\end{pmatrix}\)(第 1 行是從 \(a\) 出發)。\(h=0.1\) 時,從 \(a\) 出發的一步 Euler 機率?
3. 上一題 \(h=0.5\) 會怎樣?
4. 兩狀態、\(\lambda=2\)、\(h=0.25\),精確的 \(p(a\mid a)\)?
5. \(V=4\)(DNA)、\(d=100\):一行有多大?因子化之後呢?
6. 字母表 5 個 token,均勻雜訊,\(z_1=A\),\(\kappa=0.5\),\(x_1=A\) 和 \(x_1=B\) 的機率?
7. KFE 的右邊,\(y=x\) 那一項代表什麼?
8. 條件速率矩陣的四種情況是什麼?用一句話說。
9. 為什麼因子是 \(\dot\kappa_t/(1-\kappa_t)\)?
10. 邊際速率和條件速率差在哪?
11. 資料 aa、bb 各半,均勻雜訊,\(t=0.5\),\(\kappa_t=t\),\(x=\) bb,位置 1 換成 a 的速率?
12. 為什麼訓練用真實的 \(z_j\) 當標籤,學到的卻是後驗?
13. Mask 路徑上,已揭開的 token 為什麼不會再改?
14. Masked diffusion 怎麼做到只改中間一段?
15. Generator matching 說的是什麼?
延伸閱讀
- Holderrieth & Erives,An Introduction to Flow Matching and Diffusion Models,§7 與 CTMC 存在唯一性的附錄:本頁都對照過 TeX 原文。
- 補充課 G:連續時間 Markov 鏈、CS236 第 18 講:另一條路的離散 diffusion。
- 書 B32:第 12 章的離散狀態空間 diffusion。