Guidance:用一個額外的方向,把生成推向你要的條件
Part C 從這裡開始:理論統一之後,怎麼實際控制 diffusion model 生成什麼。核心是一行貝氏定理:條件 score = 無條件 score + 「條件對 \(\mathbf x_t\) 的梯度」。Classifier guidance(CG)另外訓練一個吃雜訊輸入的分類器來估這個梯度;classifier-free guidance(CFG)乾脆用同一個網路同時學條件和無條件的 score,用兩者的差代替分類器。兩者都有一個強度 \(\omega\):\(\omega=1\) 是精確的條件分佈,\(\omega>1\) 換來更貼近條件、更少多樣性。這一頁也先指出一個書反覆強調的細節:\(\omega\ne1\) 時,guided 取樣器生成的分佈,一般不是那個看起來很自然的「傾斜密度」。
讀完這頁你應該能夠
- 寫出條件 score 的貝氏分解,並說明條件化怎麼改變取樣用的速度場(PF-ODE)。
- 寫出 guidance 的共同模板 \(\nabla\log p_t(\mathbf x_t)+w_t\mathcal G_t\),並把 CG、CFG、training-free guidance 都放進去。
- 推出 CG 的 \(\omega\)-縮放 score,說明 \(\omega\) 的三種範圍,以及 CG 的訓練方式和限制。
- 從 CG 推出 CFG 的 \(\omega\mathbf s(\mathbf x\mid\mathbf c)+(1-\omega)\mathbf s(\mathbf x)\),說明怎麼用 condition dropout 同時訓練條件和無條件模型。
- 區分「固定時刻的傾斜密度」和「guided 取樣器實際產生的分佈」。
前置知識
- B08:反向 SDE 與 PF-ODE \(f(t)\mathbf x-\frac12g^2(t)\nabla\log p_t\);B16:四種預測的換算。
- B15:條件化技巧與「邊際 oracle = 條件 oracle 的後驗平均」。
- 貝氏定理:\(p(\mathbf x\mid\mathbf c)=p(\mathbf x)p(\mathbf c\mid\mathbf x)/p(\mathbf c)\);對 \(\mathbf x\) 取 log 梯度時,\(p(\mathbf c)\) 消失。
「書 §」標出原文位置。灰框「轉述者補充」是書裡沒有的內容;藍框「推導」展開書中省略的步驟。
01第 8 章:從生成到可控生成書 第 8 章開頭
diffusion model 是強大的生成框架。在無條件的設定下,目標是學 \(p_{\text{data}}(\mathbf x)\),不需要外部輸入就生成樣本。但許多應用需要條件生成:輸出要滿足使用者指定的條件。這可以透過引導一個無條件模型,或直接學條件分佈 \(p_0(\mathbf x\mid\mathbf c)\) 來達成,由條件 \(\mathbf c\)(例如標籤、文字描述或草圖)引導生成過程。
這一章建立在條件 score 的一個有原則的觀點上:它分解成一個無條件方向,加上一個把樣本推向條件、同時保持真實感的 guidance 方向。書解釋為什麼 guidance 是必要的,說明條件 score 怎麼成為控制的統一介面,並綜覽近似或取代 guidance 項的方法。接著區分控制(滿足條件)和對齊(在條件下滿足人類偏好),描述怎麼把偏好納入同一個框架。最後討論不需要額外 reward model(一個為更符合人類偏好的輸出打更高分的學出來的評分器)就能直接最佳化偏好的方法。
書對這一章的學習目標與閱讀建議(轉述)
目標:理解條件化怎麼修改 diffusion 取樣時用的速度場;推出 classifier guidance 和 classifier-free guidance 背後的關鍵想法,理解 guidance 強度怎麼控制條件化;理解 training-free guidance 怎麼用特定任務的損失或量測模型引導一個預先訓練好的 diffusion model,包括逆問題;區分精確的條件取樣和代理(surrogate)引導的動態,以及它們在固定時刻的傾斜密度解讀;理解偏好對齊(從 RLHF 到 DPO 再到 Diffusion-DPO)怎麼進一步把一個條件生成模型推向被偏好的輸出。閱讀建議:這一章假設讀者熟悉第 4 章和第 6 章的 Score SDE/PF-ODE 圖像;主要關心可控生成的讀者,可以把後面的偏好對齊留到第二遍再讀。本頁涵蓋前兩個目標;第三、四個在 B22,最後一個在 B23。
02Guidance 的共同模板書 §8.1
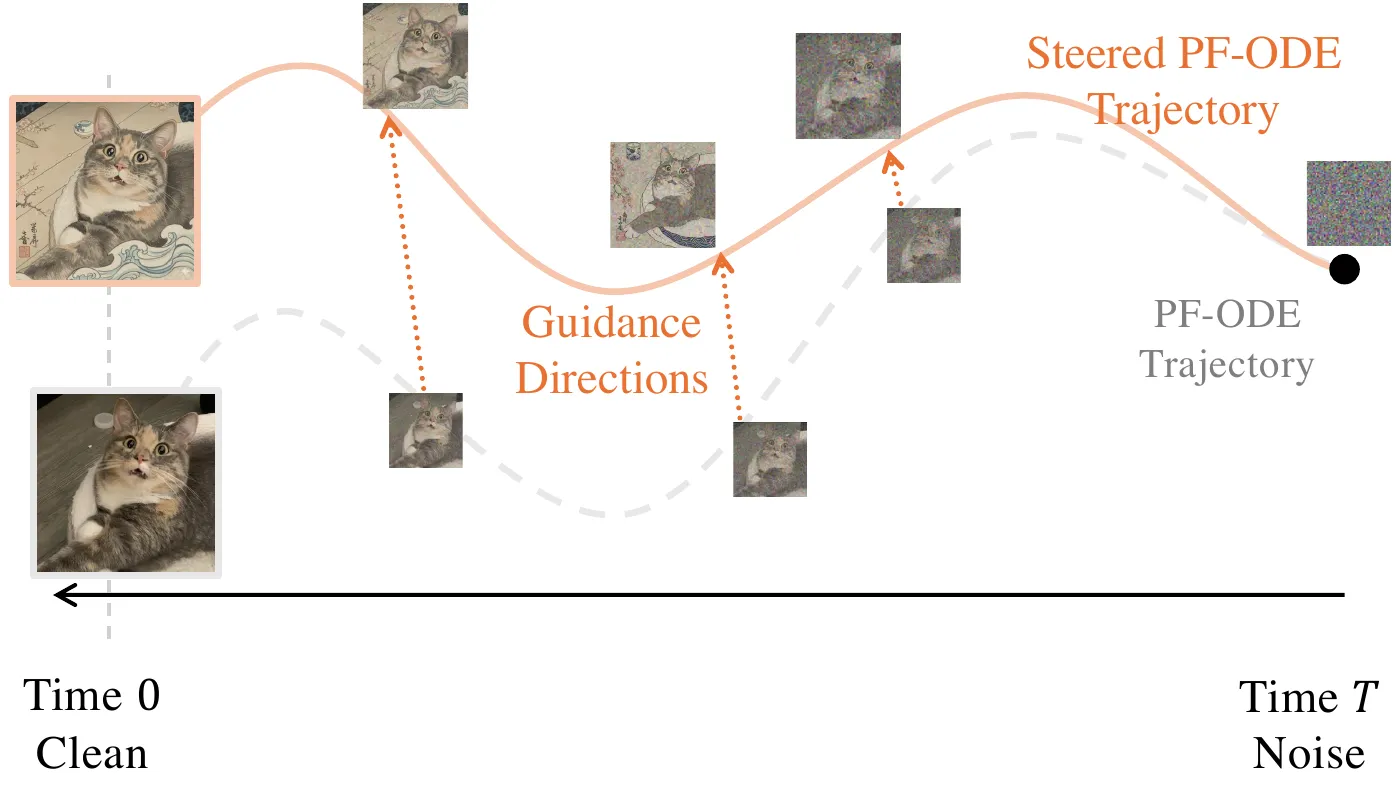
diffusion model 的生成過程以由粗到細的方式進行,為可控生成提供了彈性的框架。每一步移除一點雜訊,樣本變得更清楚,逐步顯露更多結構和細節。這個性質讓我們能控制生成過程:在學到的、隨時間變化的速度場上加一個 guidance 項,就能引導生成的軌跡反映使用者的意圖。
guidance 取樣的有原則的基礎,是條件 score 的貝氏分解。對每個雜訊等級 \(t\),
這個恆等式說明:精確的條件反向動態,就是在無條件 score 上加 guidance 項 \(\nabla_{\mathbf x_t}\log p_t(\mathbf c\mid\mathbf x_t)\)。之後會看到:classifier guidance(Dhariwal & Nichol 2021)直接估這一項;classifier-free guidance(Ho & Salimans 2021)把它隱含地估成「聯合學出的條件 score 和無條件 score 之差」;更一般的 training-free 方法則改用特定任務的代理 guidance 方向。
有了精確的條件 score,PF-ODE 變成
$$\frac{d\mathbf x(t)}{dt}=f(t)\mathbf x(t)-\frac12g^2(t)\underbrace{\nabla_{\mathbf x_t}\log p_t(\mathbf x(t)\mid\mathbf c)}_{\text{條件 score}}=f(t)\mathbf x(t)-\frac12g^2(t)\Big[\nabla_{\mathbf x_t}\log p_t(\mathbf x(t))+\nabla_{\mathbf x_t}\log p_t(\mathbf c\mid\mathbf x(t))\Big].$$在精確的 score 和精確的積分下,從對應的終端邊際 \(p_T(\mathbf x_T\mid\mathbf c)\) 出發,這個動態還原 \(p_0(\mathbf x_0\mid\mathbf c)\)。標準的 diffusion 建構會選擇終端的加噪方式,使 \(p_T(\mathbf x_T\mid\mathbf c)\) 可以由平常那個和條件無關的先驗近似。書為了清楚,用 score 預測來寫以下的討論;因為標準的 \(\mathbf x\)、\(\bm\epsilon\)、score、\(\mathbf v\) 預測在換算有定義的地方彼此由隨時間變化的線性變換相連,同樣的 guidance 修正可以用 B16 的換算寫成其他參數化。
為什麼條件化只是換一個 score
前向加噪過程不看 \(\mathbf c\):給定 \(\mathbf x_0\),\(\mathbf x_t\) 的分佈和 \(\mathbf c\) 無關。所以以 \(\mathbf c\) 為條件時,前向過程完全一樣,只是起點換成 \(p_0(\cdot\mid\mathbf c)\),邊際變成 \(p_t(\cdot\mid\mathbf c)\)。B08 的 PF-ODE 推導逐字照搬,把 \(p_t\) 換成 \(p_t(\cdot\mid\mathbf c)\) 就好。貝氏分解的推導在第 3 節。
guidance 方向的幾種實例
- Classifier guidance(CG)。第 3 節。CG 在加噪過的資料 \(\mathbf x_t\)(把乾淨的有標籤樣本破壞到等級 \(t\) 得到)上訓練一個時間條件的分類器 \(p_{\bm\psi}(\mathbf c\mid\mathbf x_t,t)\)。取樣時,它的輸入梯度提供 guidance 項 \(\nabla_{\mathbf x_t}\log p_{\bm\psi}(\mathbf c\mid\mathbf x_t,t)\approx\nabla_{\mathbf x_t}\log p_t(\mathbf c\mid\mathbf x_t)\),再加到無條件 score 上(Dhariwal & Nichol 2021)。
- Classifier-free guidance(CFG)。第 4 節。CFG 直接訓練一個條件模型 \(\mathbf s_{\bm\phi}(\mathbf x_t,t,\mathbf c)\approx\nabla_{\mathbf x_t}\log p_t(\mathbf x_t\mid\mathbf c)\);無條件模型是在訓練的一部分步驟裡,隨機把條件換成一個特殊的空標記,聯合學出來的。
- Training-free(代理)guidance。在標準的前向加噪建構下,先抽 \((\mathbf x_0,\mathbf c)\sim p_{\text{data}}\),再抽 \(\mathbf x_t\sim p_t(\cdot\mid\mathbf x_0)\),前向核不額外依賴 \(\mathbf c\),所以給定 \(\mathbf x_0\) 時 \(\mathbf c\perp\mathbf x_t\)。因此 $$p_t(\mathbf c\mid\mathbf x_t)=\int p(\mathbf c\mid\mathbf x_0)\,p(\mathbf x_0\mid\mathbf x_t)\,d\mathbf x_0.$$ 這個後驗平均一般算不出來,促使 training-free 方法改成建構一個特定任務的代理 guidance 方向。B22 的 training-free(基於損失的)guidance 不直接計算條件概似 \(p_t(\mathbf c\mid\mathbf x_t)\),而是從一個現成的損失 \(\ell(\mathbf x_t,\mathbf c;t)\) 出發,它衡量目前的樣本多滿足想要的條件,損失越小越符合。由這個損失定義正的 guidance 位勢 $$\mathbf h_t(\mathbf x_t;\mathbf c):=\exp\big(-\tau\,\ell(\mathbf x_t,\mathbf c;t)\big),\qquad\tau>0,$$ 損失低的樣本得到較大的位勢值。對應的 guidance 方向記作 \(\mathcal G_t(\mathbf x_t,\mathbf c):=\nabla_{\mathbf x_t}\log\mathbf h_t(\mathbf x_t;\mathbf c)=-\tau\nabla_{\mathbf x_t}\ell(\mathbf x_t,\mathbf c;t)\)。Classifier guidance 自然地放進同一個圖像:在母體層級,它的 guidance 位勢是 \(\mathbf h_t(\mathbf x_t;\mathbf c)=p_t(\mathbf c\mid\mathbf x_t)\),實務上由學到的分類器 \(p_{\bm\psi^\times}(\mathbf c\mid\mathbf x_t,t)\) 近似;等價地,學到的分類器對應損失 \(\ell(\mathbf x_t,\mathbf c;t)=-\log p_{\bm\psi^\times}(\mathbf c\mid\mathbf x_t,t)\)、\(\tau=1\)。
\(p_t(\mathbf c\mid\mathbf x_t)\) 那一行(書的腳註)
因為標準的前向核滿足 \(p_t(\mathbf x_t\mid\mathbf x_0,\mathbf c)=p_t(\mathbf x_t\mid\mathbf x_0)\),有 \(p(\mathbf c\mid\mathbf x_0,\mathbf x_t)=p(\mathbf c\mid\mathbf x_0)\),就是正文的式子。白話:「雜訊圖 \(\mathbf x_t\) 是類別 \(\mathbf c\) 的機率」,等於「對所有可能的乾淨圖 \(\mathbf x_0\) 取平均的乾淨分類器」。這和 B15 的條件化模式(邊際 = 條件的後驗平均)是同一個結構。
在母體層級,上面三種建構共用同一個加法的 guidance 模板。給定正的位勢 \(\mathbf h_t(\mathbf x_t;\mathbf c)\) 和 guidance 強度 \(w_t\ge0\),定義 guided score 場
基於損失的 guidance 用 \(\mathcal G_t=-\tau\nabla_{\mathbf x_t}\ell\);精確的 classifier guidance 用 \(\mathcal G_t=\nabla_{\mathbf x_t}\log p_t(\mathbf c\mid\mathbf x_t)\);classifier-free guidance 則透過條件與無條件 score 之差,表達同一個母體的 guidance 方向。
在每個固定的時刻 \(t\),只要可正規化,上面的 guided score 就是傾斜密度
$$\widetilde p_t^{\text{tilt}}(\mathbf x_t\mid\mathbf c)\propto p_t(\mathbf x_t)\,\mathbf h_t(\mathbf x_t;\mathbf c)^{w_t}$$的 score。這給出一個有用的能量解讀:基礎密度偏好 diffusion model 支持的樣本,位勢則把它們往想要的條件重新加權。實務上,上面 guided score 的學出來或代理的版本被插進反向時間的動態。重要的是,這個傾斜密度只是一個固定時刻的解讀:這一族 \(\{\widetilde p_t^{\text{tilt}}(\cdot\mid\mathbf c)\}_t\) 不必和 guided 取樣器產生的邊際一致。因此,對一般的損失或 guidance 時程,從 \(T\) 積分 guided PF-ODE 到 0,一般不會產生依 \(\widetilde p_0^{\text{tilt}}(\cdot\mid\mathbf c)\) 分佈的樣本。這個解讀要成立所需的跨時間一致性,書在 §8.4(B22)討論。
為什麼「每個時刻都對」拼起來不等於「生成的分佈對」(轉述者的直覺)
B17 說過:PF-ODE 會生成 \(\{p_t\}\) 這條路徑,是因為 \(\{p_t\}\) 本身滿足同一條 Fokker–Planck 方程;速度場只是那條方程「解出來」的結果。把每個時刻的 score 換成 \(\widetilde p_t^{\text{tilt}}\) 的 score,等於把速度場換掉;但 \(\{\widetilde p_t^{\text{tilt}}\}\) 這串密度一般不是同一個前向過程下的一條 Fokker–Planck 解(\(p_t\) 是 \(p_0\) 加噪的結果,\(p_t\cdot\mathbf h_t^w\) 卻不是 \(p_0\cdot\mathbf h_0^w\) 加噪的結果)。速度場對不上任何一條真正的密度路徑,最後落在哪裡就沒有保證。只有 \(w_t=1\)、\(\mathbf h_t=p_t(\mathbf c\mid\mathbf x_t)\) 時,\(\widetilde p_t^{\text{tilt}}=p_t(\cdot\mid\mathbf c)\) 恰好是條件資料加噪的路徑。Demo A 量出這個差距有多大。
guidance 對取樣軌跡的效果如上圖所示。同樣的原則也可以疊在一個已經是條件的模型上,讓額外的控制訊號修改它的取樣動態。
從控制到更好的對齊:直接偏好最佳化
強的控制可能「符合條件、卻不符合偏好」:一個樣本可能滿足條件訊號(例如提示詞),卻偏離人類真正偏好的樣子。書把這件事形式化成在 \(t=0\) 用一個偏好評分傾斜條件目標:
$$\widetilde p_0^{\text{tilt}}(\mathbf x_0\mid\mathbf c)\propto p_0(\mathbf x_0\mid\mathbf c)\exp\big(\lambda_{\text{pref}}\,r(\mathbf x_0,\mathbf c)\big),\qquad\lambda_{\text{pref}}>0,$$\(r(\mathbf x_0,\mathbf c)\) 是一個乾淨樣本 \(\mathbf x_0\) 和條件 \(\mathbf c\) 的純量對齊評分,值越大表示越被偏好;\(\lambda_{\text{pref}}\) 控制偏好重新加權的強度。在之後介紹的 KL 正則化表述中(B23),最佳解恰好是這個形式,基礎分佈是參考策略、\(\lambda_{\text{pref}}=1/\beta\)。
現有達成這種可控性的方法,通常收集人類對模型生成結果相對品質的標註,再微調條件 diffusion model 去對齊這些偏好,常常透過基於人類回饋的強化學習(RLHF)。但 RLHF 是一個複雜、常常不穩定的程序:先擬合一個捕捉人類偏好的 reward model,再用強化學習微調條件 diffusion model 去最大化這個估計的 reward,同時限制策略偏離原本模型的程度。這自然引出問題:能不能完全拿掉 reward model 的訓練階段?書用 Diffusion-DPO(Wallace et al. 2024)回答,它是原本為大型語言模型發展的 Direct Preference Optimization(Rafailov et al. 2023)的改編。如 §8.5(B23)所述,Diffusion-DPO 直接從成對的選擇學偏好傾斜,讓條件 diffusion model 不需要另外的 reward model 就能微調成對齊偏好。
03Classifier guidance書 §8.2
CG 的基礎
令 \(\mathbf c\) 是從分佈 \(p(\mathbf c)\) 抽出的條件變數,例如類別標籤、說明文字或其他輔助資訊。目標是從 \(p_0(\mathbf x\mid\mathbf c)\) 取樣。在基於 diffusion 的條件生成中,做法是執行時間邊際為 \(p_t(\cdot\mid\mathbf c)\) 的反向時間動態,它的漂移依賴條件 score \(\nabla_{\mathbf x_t}\log p_t(\mathbf x_t\mid\mathbf c)\),\(t\in[0,T]\)。所以一條標準而有效的路就是估這個量。(書的註腳:原則上,如果 \(p(\mathbf c\mid\mathbf x)\) 可得且校準良好,也可以用拒絕抽樣或重要性抽樣從無條件生成器得到 \(p_0(\mathbf x\mid\mathbf c)\);但對高維或罕見的條件,這很少實用。)
一個基於貝氏定理的基本洞見是:條件 score 可以分解成
$$\nabla_{\mathbf x_t}\log p_t(\mathbf x_t\mid\mathbf c)=\nabla_{\mathbf x_t}\log\Big(\frac{p_t(\mathbf x_t)\,p_t(\mathbf c\mid\mathbf x_t)}{p(\mathbf c)}\Big)=\underbrace{\nabla_{\mathbf x_t}\log p_t(\mathbf x_t)}_{\text{無條件 score}}+\underbrace{\nabla_{\mathbf x_t}\log p_t(\mathbf c\mid\mathbf x_t)}_{\text{分類器梯度}},$$\(p_t(\mathbf c\mid\mathbf x_t)\) 表示以 \(\mathbf x_t\) 為條件的 \(\mathbf c\) 的機率,它從時間 \(t\) 的雜訊輸入預測條件 \(\mathbf c\)。(書的腳註:最後一個等號裡 \(\nabla_{\mathbf x_t}\log p(\mathbf c)=0\),因為 \(p(\mathbf c)\) 不依賴 \(\mathbf x_t\)。)
這個分解啟發了 Dhariwal & Nichol (2021) 提出的 Classifier Guidance(CG)。為了把母體恆等式和實務上用的學出來的分類器分開,先看 oracle 的量。對 guidance 尺度 \(\omega\ge0\),在每個固定時刻 \(t\) 定義
$$\widetilde p_t^{\text{CG},\omega}(\mathbf x_t\mid\mathbf c)\propto p_t(\mathbf x_t)\,p_t(\mathbf c\mid\mathbf x_t)^\omega.$$它的 score 是
所以 \(\omega\) 縮放 classifier-guidance 方向。\(\omega=1\) 時,貝氏定理給出 \(\widetilde p_t^{\text{CG},1}(\mathbf x_t\mid\mathbf c)=p_t(\mathbf x_t\mid\mathbf c)\),上式還原精確的條件 score。對一般的 \(\omega\),\(\widetilde p_t^{\text{CG},\omega}\) 給出 guided 場在固定時刻的「回火」(tempered)解讀;它是不是也形成 guided 取樣器的邊際路徑,在 §8.4(B22)討論。純量 \(\omega\ge0\) 調節分類器的影響:
- \(\omega=1\):還原真正的條件 score \(\nabla_{\mathbf x_t}\log p_t(\mathbf x_t\mid\mathbf c)\)。
- \(\omega>1\):放大分類器訊號,通常提高條件的忠實度(常以多樣性為代價)。
- \(0\le\omega<1\):降低分類器訊號的權重,通常提高樣本多樣性、同時減弱條件化。
為什麼 \(p(\mathbf c\mid\mathbf x)^\omega\) 會讓樣本「更像那一類、更不多樣」
\(p(\mathbf c\mid\mathbf x)\) 在 0 到 1 之間;取 \(\omega>1\) 次方會把不確定的區域(例如 0.6)壓得比確定的區域(例如 0.99)更多。所以傾斜密度把質量從「兩類交界、分類器拿不定主意」的地方,搬到「分類器很有把握」的地方:那通常是遠離其他類的那一側。結果是:樣本更典型、更容易被認出是那一類,但涵蓋的範圍變窄。Demo A 在兩類重疊的一維資料上看這件事。
CG 的實務近似
實務上,CG 是一個(對 diffusion model 而言)training-free 的方法,用來引導一個預先訓練好的無條件 diffusion model \(\mathbf s_{\bm\phi^\times}(\mathbf x_t,t)\approx\nabla_{\mathbf x_t}\log p_t(\mathbf x_t)\)。CG 只在取樣時套用,不修改 diffusion model 本身。為此,另外訓練一個時間相關的分類器 \(p_{\bm\psi}(\mathbf c\mid\mathbf x_t,t)\),從不同雜訊等級 \(t\) 的雜訊輸入預測條件 \(\mathbf c\)。分類器用標準的方式最小化交叉熵訓練:
$$\mathbb E_{t\sim\mathcal U[0,T],\,(\mathbf x,\mathbf c)\sim p_{\text{data}},\,\bm\epsilon\sim\mathcal N(\mathbf 0,\mathbf I)}\Big[-\log p_{\bm\psi}(\mathbf c\mid\mathbf x_t,t)\Big],$$\((\mathbf x,\mathbf c)\sim p_{\text{data}}\) 表示成對的標註資料,\(\mathbf x_t=\alpha_t\mathbf x+\sigma_t\bm\epsilon\) 是時間 \(t\) 的雜訊輸入。分類器必須跨雜訊等級訓練,通常把 \(t\)(或等價的雜訊等級表示)當輸入,才能在整條 diffusion 路徑上逼近 \(p_t(\mathbf c\mid\mathbf x_t)\)。訓練之後,分類器提供的梯度當作真正概似梯度的替代:\(\nabla_{\mathbf x_t}\log p_{\bm\psi^\times}(\mathbf c\mid\mathbf x_t,t)\approx\nabla_{\mathbf x_t}\log p_t(\mathbf c\mid\mathbf x_t)\)。
交叉熵訓練為什麼學到 \(p_t(\mathbf c\mid\mathbf x_t)\)
固定 \(t\),交叉熵 \(\mathbb E_{(\mathbf x_t,\mathbf c)}[-\log p_{\bm\psi}(\mathbf c\mid\mathbf x_t,t)]\) 對每個 \(\mathbf x_t\) 是 \(\mathbb E_{\mathbf c\mid\mathbf x_t}[-\log p_{\bm\psi}(\mathbf c\mid\mathbf x_t)]\),在 \(p_{\bm\psi}=p_t(\cdot\mid\mathbf x_t)\) 時最小(Gibbs 不等式:交叉熵 = 熵 + KL)。而 \((\mathbf x_t,\mathbf c)\) 正是照上一節的生成方式抽的,所以學到的是正確的雜訊後驗 \(p_t(\mathbf c\mid\mathbf x_t)\),而不是乾淨分類器 \(p(\mathbf c\mid\mathbf x_0)\)。這和 B15「條件目標的最小化解是後驗平均」是同一個道理。
用 CG 推論
推論時,學到的分類器梯度 \(\nabla_{\mathbf x_t}\log p_{\bm\psi^\times}(\mathbf c\mid\mathbf x_t,t)\) 加到無條件 score 的估計上、乘上 \(\omega\),得到 oracle 場的一個學出來的近似:
$$\mathbf s^{\text{CG}}_{\text{model}}(\mathbf x_t,t,\mathbf c;\omega):=\underbrace{\mathbf s_{\bm\phi^\times}(\mathbf x_t,t)}_{\text{無條件方向}}+\omega\underbrace{\nabla_{\mathbf x_t}\log p_{\bm\psi^\times}(\mathbf c\mid\mathbf x_t,t)}_{\text{guidance 方向}}\approx\mathbf s^{\text{CG}}(\mathbf x_t,t,\mathbf c;\omega).$$反向時間 SDE 或 PF-ODE 裡的無條件 score 估計,就換成 \(\mathbf s^{\text{CG}}_{\text{model}}(\mathbf x_t,t,\mathbf c;\omega)\),藉此把生成軌跡引向符合條件 \(\mathbf c\) 的樣本。
優點與限制
CG 提供一個簡單而有彈性的條件生成機制,可以透過 \(\omega\) 明確控制條件化的強度。它可以用在任何預先訓練好的無條件 diffusion model 上,只需要另外一個分類器。但它有明顯的限制:
- 訓練成本:分類器必須在所有雜訊等級上運作,訓練的計算量很大。
- 穩健性:分類器必須對嚴重破壞的輸入 \(\mathbf x_t\) 泛化得好,特別是大的 \(t\),這可能很有挑戰。
- 分開訓練:分類器和 diffusion model 獨立訓練,可能和學到的資料分佈不完全對齊。
Demo Aguidance 強度 ω 做了什麼轉述者補充
一維、兩類資料:\(c=0\) 是 \(\mathcal N(-1,0.6^2)\)、\(c=1\) 是 \(\mathcal N(1,0.6^2)\),各占一半,兩類明顯重疊。DDPM 式 VP 時程(\(\beta(t)=0.1+19.9t\)),所有 score 和分類器都是精確的(給定類別時是高斯),所以這裡 CG 和 CFG 完全相同。目標類別 \(c=1\)。2,000 個樣本從精確的 \(p_1\) 出發,用 guided PF-ODE(RK4 200 步)倒著積分到 \(t=0.002\)。下圖比較:生成的直方圖、精確的條件分佈 \(p_0(x\mid c=1)\),以及固定時刻的傾斜密度 \(\widetilde p_0^{\text{CG},\omega}\propto p_0(x)\,p_0(c=1\mid x)^\omega\)。
瀏覽器實測:
| \(\omega\) | guided 平均 | 標準差 | \(x>0\) | 傾斜密度平均 | 標準差 | \(x>0\) |
|---|---|---|---|---|---|---|
| 0 | −0.030 | 1.176 | 49.6% | 0.000 | 1.166 | 49.9% |
| 0.5 | 0.586 | 0.856 | 73.5% | 0.860 | 0.723 | 87.6% |
| 1 | 0.977 | 0.606 | 94.5% | 1.000 | 0.600 | 95.1% |
| 2 | 1.370 | 0.431 | 100% | 1.077 | 0.543 | 98.6% |
| 4 | 1.799 | 0.345 | 100% | 1.133 | 0.510 | 99.8% |
| 8 | 2.334 | 0.295 | 100% | 1.186 | 0.484 | 100% |
三件事。(1) \(\omega=0\) 是無條件的混合(平均 0、一半在右邊),\(\omega=1\) 精確地還原 \(p_0(x\mid c=1)\)(平均 0.977、標準差 0.606,真值 1、0.6),這是書的兩個端點。(2) \(\omega>1\) 時,「更符合條件、更少多樣」看得很清楚:落在 \(x>0\) 的比例從 95% 升到 100%,標準差從 0.6 縮到 0.3。(3) 但 guided 取樣器的分佈和傾斜密度差很多,而且差距隨 \(\omega\) 變大:\(\omega=8\) 時傾斜密度的平均只有 1.19(它仍然被 \(p_0\) 壓在資料附近),guided 樣本的平均卻跑到 2.33,幾乎整團落在 \(x\in[1.7,3.3]\),比 \(c=1\) 這一類本身的典型位置還遠,那裡在 \(p_0\) 下的密度已經很低。這就是書說的「傾斜密度只是固定時刻的解讀」:每個時刻的 guided score 都是某個傾斜密度的 score,但沿著時間積分下來,樣本被推得比任何一個傾斜密度都遠。實務上常見大 \(\omega\) 讓影像顏色過飽和、偏離真實分佈,和這個現象一致。
04Classifier-free guidance書 §8.3
CFG 的基礎
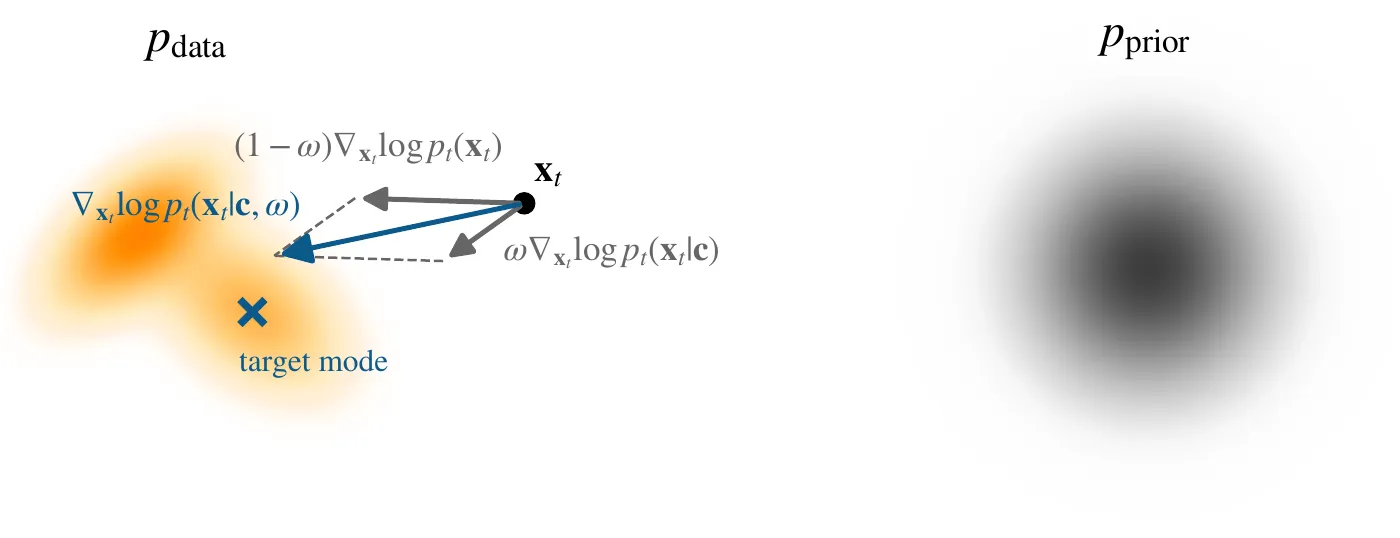
Classifier-free guidance(CFG;Ho & Salimans 2021)把 classifier-guidance 方向改用條件與無條件 score 表達,因此不需要另外訓練分類器。貝氏定理給出
$$\nabla_{\mathbf x_t}\log p_t(\mathbf c\mid\mathbf x_t)=\nabla_{\mathbf x_t}\log p_t(\mathbf x_t\mid\mathbf c)-\nabla_{\mathbf x_t}\log p_t(\mathbf x_t).$$代入 CG 的 \(\omega\)-縮放 score,得到 oracle 的 CFG 場
在精確的 score 下,這在代數上和 CG 的 guided 場完全相同。\(\omega=1\) 時化成精確的條件 score。對其他的 guidance 強度,它在固定時刻的傾斜密度解讀,要和 guided 動態產生的邊際區分開來(§8.4,B22)。超參數 \(\omega\) 同樣扮演控制條件資訊影響力的關鍵角色(取 \(\omega\ge0\)):
- \(\omega=0\):模型表現得像一個無條件 diffusion model,完全忽略條件。
- \(\omega=1\):模型使用條件 score,沒有額外的 guidance。
- \(\omega>1\):模型更強調條件 score、更不強調無條件 score,加強和 \(\mathbf c\) 的對齊,但通常降低多樣性。
CFG 對應的傾斜密度,以及另一種常見的 \(\omega\) 慣例
CFG 場是 \(\omega\log p_t(\mathbf x_t\mid\mathbf c)+(1-\omega)\log p_t(\mathbf x_t)\) 的梯度,所以固定時刻的傾斜密度是 \(p_t(\mathbf x_t\mid\mathbf c)^\omega\,p_t(\mathbf x_t)^{1-\omega}\),用貝氏定理就是 \(p_t(\mathbf x_t)\,p_t(\mathbf c\mid\mathbf x_t)^\omega\)(差一個常數),和 CG 的一樣。
慣例。Ho & Salimans (2021) 原文把 guidance 寫成 \((1+w)\,\bm\epsilon(\mathbf x,\mathbf c)-w\,\bm\epsilon(\mathbf x)\);和書的 \(\omega\) 對照是 \(\omega=1+w\)。所以文獻裡的「guidance scale 7.5」是指哪一種慣例,要看實作;常見的開源程式碼用的是 \(\bm\epsilon(\mathbf x)+s\,(\bm\epsilon(\mathbf x,\mathbf c)-\bm\epsilon(\mathbf x))\),這時 \(s\) 就是書的 \(\omega\)。用 \(\bm\epsilon\) 或 score 寫都一樣,因為兩者只差一個 \(-1/\sigma_t\)(B16)。
CFG 的訓練與取樣
透過 CFG 聯合訓練無條件和條件 diffusion model。CFG 需要一個同時支援條件與無條件預測的 diffusion model。它不訓練兩個分開的模型,而是用單一模型 \(\mathbf s_{\bm\phi}(\mathbf x_t,t,\mathbf c)\),訓練時隨機把條件輸入換成一個空標記 \(\varnothing\):用空輸入時,模型學無條件預測 \(\mathbf s_{\bm\phi}(\mathbf x_t,t,\varnothing)\);用原本的條件時,學條件預測 \(\mathbf s_{\bm\phi}(\mathbf x_t,t,\mathbf c)\)。空條件以機率 \(p_{\text{uncond}}\) 使用,這是使用者指定的條件 dropout 機率。完整的訓練程序和標準的無條件訓練並列如下。guidance 權重 \(\omega\) 只在取樣時引入,不是這個訓練目標的一部分。
| 無條件 DM | 條件 DM 的 CFG 訓練(需要:無條件 dropout 機率 \(p_{\text{uncond}}\)) |
|---|---|
| 重複: | 重複: |
| \(\mathbf x\sim p_{\text{data}}(\mathbf x)\) | \((\mathbf x,\mathbf c)\sim p_{\text{data}}(\mathbf x,\mathbf c)\) |
| 以機率 \(p_{\text{uncond}}\) 令 \(\mathbf c\leftarrow\varnothing\) | |
| \(t\sim\mathcal U[0,T]\) | \(t\sim\mathcal U[0,T]\) |
| \(\bm\epsilon\sim\mathcal N(\mathbf 0,\mathbf I)\) | \(\bm\epsilon\sim\mathcal N(\mathbf 0,\mathbf I)\) |
| \(\mathbf x_t=\alpha_t\mathbf x+\sigma_t\bm\epsilon\) | \(\mathbf x_t=\alpha_t\mathbf x+\sigma_t\bm\epsilon\) |
| 對 \(\nabla_{\bm\phi}\Vert\mathbf s_{\bm\phi}(\mathbf x_t,t)-\mathbf s\Vert^2\) 走一步梯度 | 對 \(\nabla_{\bm\phi}\Vert\mathbf s_{\bm\phi}(\mathbf x_t,t,\mathbf c)-\mathbf s\Vert^2\) 走一步梯度 |
| 直到收斂 | 直到收斂 |
轉述者注:演算法裡的回歸目標 \(\mathbf s\) 是 DSM 的條件 score \(\nabla_{\mathbf x_t}\log p_t(\mathbf x_t\mid\mathbf x)=-\bm\epsilon/\sigma_t\)(B06)。實作上常改用 \(\bm\epsilon\)-prediction,兩者只差一個時間權重(B15、B16),Demo B 用的就是 \(\bm\epsilon\)-prediction。
為什麼一個網路就能學兩個 score(轉述者補充)
DSM 的最小化解是條件 score 的後驗平均(B15)。在丟掉條件的那些樣本上,網路看到的輸入是 \((\mathbf x_t,t,\varnothing)\),而 \(\mathbf x_t\) 來自所有類別混在一起的資料,所以對應的最小化解是 \(\nabla\log p_t(\mathbf x_t)\);在保留條件的樣本上,輸入 \((\mathbf x_t,t,\mathbf c)\) 只來自類別 \(\mathbf c\),最小化解是 \(\nabla\log p_t(\mathbf x_t\mid\mathbf c)\)。兩者共享參數,但因為輸入不同,網路可以同時表示兩個函數。代價是:無條件分支只看到 \(p_{\text{uncond}}\) 比例的訓練樣本,通常比條件分支學得差。Demo B 看得到這一點。
用 CFG 做條件取樣。模型 \(\mathbf s_{\bm\phi^\times}(\mathbf x_t,t,\mathbf c)\) 用上面的演算法訓練好之後,CFG 組成學到的 guided 場
$$\mathbf s^{\text{CFG}}_{\text{model}}(\mathbf x_t,t,\mathbf c;\omega):=\omega\underbrace{\mathbf s_{\bm\phi^\times}(\mathbf x_t,t,\mathbf c)}_{\text{條件 score 估計}}+(1-\omega)\underbrace{\mathbf s_{\bm\phi^\times}(\mathbf x_t,t,\varnothing)}_{\text{無條件 score 估計}}\approx\mathbf s^{\text{CFG}}(\mathbf x_t,t,\mathbf c;\omega).$$取樣時,反向時間 SDE 或 PF-ODE 裡的無條件 score 估計換成 \(\mathbf s^{\text{CFG}}_{\text{model}}\)。所以 CFG 把學到的條件和無條件 score 估計組合起來,定義一個修改過的取樣場。這個表述只要調 \(\omega\) 就能做可控生成,在條件化強度和樣本多樣性之間提供一個簡單的訓練後取捨,不需要另外訓練的分類器或無條件 diffusion model。
Demo B訓練一個 CFG 模型轉述者補充
同一個兩類資料和時程。一個 MLP(兩層、每層 48 個神經元)輸入 \(x_t\)、\(t\) 的特徵,加上條件的 one-hot(空條件 \(\varnothing\) 是全 0),用 \(\bm\epsilon\)-prediction 訓練 4,000 步,條件 dropout \(p_{\text{uncond}}=0.3\)。取樣時把 \(\bm\epsilon\) 換成 score(\(\mathbf s=-\hat{\bm\epsilon}/\sigma_t\)),用 CFG 組合,PF-ODE(RK4 100 步)從 1,000 個起點倒著解。下圖比較學到的模型和 Demo A 的精確 guided 取樣。
瀏覽器實測(和 Node 原型一致;訓練的純計算約 8 秒)。學到的模型 / 精確 score,兩者用同樣的取樣器(RK4 100 步、1,000 個起點):
| \(\omega\) | 平均 | 標準差 | \(x>0\) |
|---|---|---|---|
| 0 | 0.097 / −0.022 | 1.235 / 1.187 | 56.1% / 50.1% |
| 1 | 0.998 / 0.981 | 0.652 / 0.616 | 94.9% / 94.9% |
| 2 | 1.346 / 1.375 | 0.459 / 0.438 | 99.9% / 100% |
| 4 | 1.673 / 1.803 | 0.324 / 0.352 | 100% / 100% |
一個網路、隨機丟掉 30% 的條件,就同時學到了條件和無條件兩個 score:\(\omega=1\) 時幾乎和精確的一樣。誤差最大的是 \(\omega=0\):無條件分支偏右(56% 落在右邊,應該是 50%)。這符合上面補充框的預期:無條件分支只看到 30% 的訓練樣本,而且它要學的是雙峰的分佈,比單峰的條件分佈難。\(\omega=4\) 時學到的模型的平均比精確的少 0.13:外插 \(\omega(\mathbf s_c-\mathbf s_\varnothing)\) 會把兩個分支的誤差放大 \(\omega\) 倍。對照:在 Node 用 \(p_{\text{uncond}}=0.2\)、3,000 步訓練,\(\omega=0\) 的平均偏到 0.23,偏差更大。