Score SDE:把一排雜訊等級變成連續的時間,生成就是解微分方程
DDPM 和 NCSN 都用一串離散的雜訊等級。如果在資料和雜訊之間插入越來越多的等級,極限就是一條隨機微分方程(SDE):資料隨著時間被連續地加上雜訊。這一頁看 DDPM 和 NCSN 怎麼都變成同一種形式的前向 SDE、前向過程的擾動核怎麼算、為什麼把它倒過來需要的唯一未知量就是時間相依的 score,以及另一個確定性的選擇:probability flow ODE。它和反向 SDE 走的路完全不同,卻在每個時刻有相同的分佈。
讀完這頁你應該能夠
- 從 NCSN 和 DDPM 的離散加雜訊步驟,推出它們共同的形式 \(\mathbf x_{t+\Delta t}\approx\mathbf x_t+\mathbf f\Delta t+g\sqrt{\Delta t}\,\boldsymbol\epsilon\),寫出各自的 \(\mathbf f\)、\(g\),並取極限得到前向 SDE。
- 對仿射漂移 \(\mathbf f=f(t)\mathbf x\),推導擾動核 \(p_t(\mathbf x_t\mid\mathbf x_0)\) 的平均和變異數,說明「simulation-free」的意思。
- 寫出 Anderson 的反向 SDE,說明它唯一的未知量是時間相依的 score,並解釋為什麼反向過程裡的雜訊不會破壞生成(Langevin 的觀點)。
- 寫出 PF-ODE,說明它和反向 SDE 的異同、它的兩個優點,以及漂移裡的 \(\tfrac12\) 不是「把雜訊拿掉」得來的。
前置知識
- B04:DDPM 的前向過程;B07:NCSN 的雜訊等級、NCSN 與 DDPM 的對照表。
- B05:Langevin SDE、Euler–Maruyama、布朗運動的增量;B06:Tweedie 公式。
- 常微分方程、布朗運動、SDE 的入門:CS236 補充課 B、補充課 E;Fokker–Planck:補充課 F。書的附錄 A(B33)也有 SDE 的速成。
「書 §」標出原文位置。灰框「轉述者補充」是書裡沒有的內容;藍框「推導」展開書中省略的步驟。書在這一節引用了後面幾節的推導(擾動核在 §4.4.3、反向 SDE 的直覺推導在 §4.6.2、Fokker–Planck 在 §4.2),本頁在需要的地方先補上簡短版本,並標明完整推導在哪一頁。
01第 4 章在做什麼書 第 4 章開頭
章首引言:「只有一種精確呈現定律的方式,那就是用微分方程。」(Richard P. Feynman)
到目前為止,我們從兩個觀點研究了 diffusion model:變分觀點(第 2 章),以及從 EBM 自然長出來的 score 觀點(第 3 章)。現在跨出下一步,進入連續時間的框架。它的核心是 Score SDE(Song et al. 2020),提供一個把 DDPM 和 NCSN 放進同一個框架的連續時間觀點。
與其只用有限個雜訊等級,不如想像在資料和雜訊之間插入越來越多的中間等級。在連續時間的極限下,雜訊等級隨時間平滑地變化,得到基本的圖像:
$$p_{\text{data}}\ \xrightarrow{\ \text{前向 SDE}\ }\ p_T\approx p_{\text{prior}},\qquad p_{\text{prior}}\ \xrightarrow{\ \text{反向動態}\ }\ p_{\text{data}}.$$前向 SDE 描述資料怎麼逐漸被破壞成雜訊,在連續時間裡扮演 DDPM 的雜訊時程、或 NCSN 的雜訊等級序列的角色。一旦指定了前向過程,主要的挑戰就是反方向的生成:從簡單的雜訊分佈出發,怎麼還原資料分佈?
關鍵的量是時間相依的 score \(\nabla_{\mathbf x}\log p_t(\mathbf x)\),它描述每個時刻 \(t\) 帶雜訊分佈的局部幾何。一旦知道這個 score,或用神經網路近似它,它就決定了用來生成的反向動態,把雜訊變成資料。這導出兩種互補的描述:隨機的反向 SDE,以及確定性的 probability flow ODE(PF-ODE)。兩者的樣本軌跡不同,卻可以走過同樣的一串邊際分佈。
這個連續時間的觀點把生成變成求解微分方程的問題,開啟了隨機過程、微分方程和數值分析的大量工具。特別是,一旦生成動態寫成 SDE 或 ODE,就能用標準的數值方法模擬,更先進的求解器還能提升取樣的效率和準確度。所以這個觀點不只是 diffusion model 統一的數學描述,也是理解和設計本書後面那些更快取樣方法的實用基礎。
書列出本章的學習目標有六項,這一章分成三頁:
- 理解 DDPM 和 NCSN 的離散雜訊等級怎麼導出一條把資料逐漸變成雜訊的連續時間前向 SDE。(本頁)
- 理解從雜訊回到資料的生成,可以用隨機的反向 SDE 描述,也可以用確定性的 PF-ODE 描述。(本頁)
- 解釋反向 SDE 和 PF-ODE 為什麼個別樣本軌跡不同,卻能走過同樣的一串邊際分佈,並理解 Fokker–Planck 方程怎麼描述機率密度在連續時間中的演化。(B09)
- 理解時間相依的 score 怎麼用 denoising score matching 學,再透過反向 SDE 或 PF-ODE 用來取樣。(B09)
- 理解 PF-ODE 也可以往前跑來做反演(inversion),並透過連續的變數變換公式追蹤機率密度的變化,用來計算概似。(B09)
- 認出 VE 和 VP SDE 是同一個連續時間 diffusion 框架的兩個重要實例,分別連回 NCSN 和 DDPM。(B10)
書的建議:不熟悉隨機微分方程的讀者,可以視需要參考附錄的微分方程章節。第一次讀時,專注在前向 SDE、反向 SDE 和 PF-ODE 各自的角色,以及它們的訓練和取樣程序;高斯的例子和選讀的推導可以等大圖像清楚之後再回來看。
02Score SDE 的原理:時間相依的 score書 §4.1
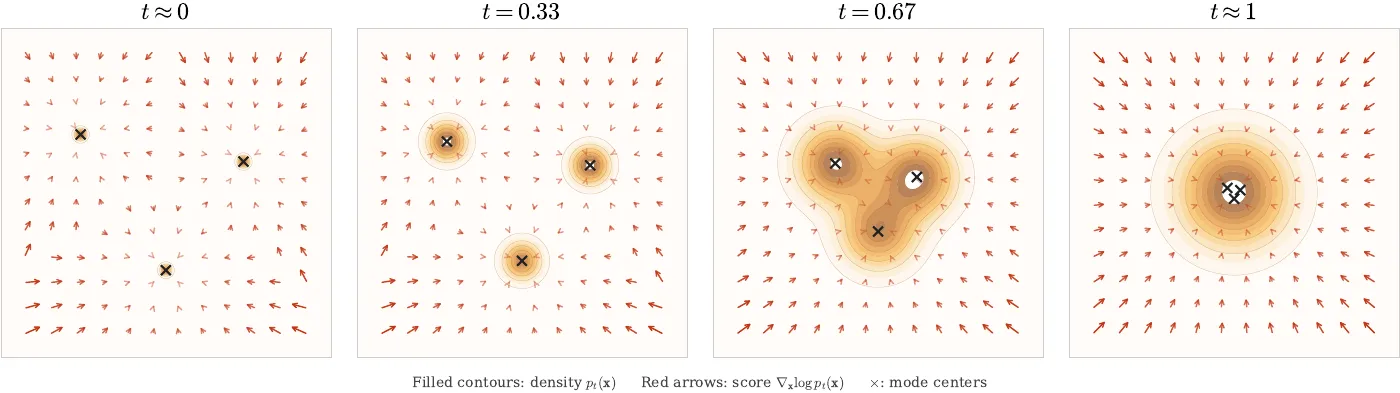
多個雜訊尺度是 NCSN 和 DDPM 成功的關鍵要素。這一節介紹 Score SDE(Song et al. 2020)的基礎,它把這個想法推到極致:考慮連續的雜訊等級。前向與反向 diffusion 的連續時間極限其實 Sohl-Dickstein et al. (2015) 就注意到了,但 Song et al. (2020) 把這個觀點放到核心:把資料的演化寫成隨機(或常)微分方程,雜訊等級隨時間平滑增加。
這個寫法的中心是時間相依的 score function \(\nabla_{\mathbf x}\log p_t(\mathbf x)\):在每個雜訊等級 \(t\),它指向目前帶雜訊分佈 \(p_t\) 下密度較高的區域,而決定怎麼把 diffusion 倒回去的,正是這個量。如上圖所示,隨著噪音增加,擾動後的密度從集中在資料各峰附近的多峰分佈,演變成寬廣、近乎單峰的分佈(先驗);對應地,score 場從「把樣本拉向附近峰的、尖銳的局部向量場」,變成「指向整體質心的、平滑的全域向量場」。這個連續時間的寫法不只統一了先前的離散時間模型,也為生成建模提供了有原則、有彈性的基礎:學會所有雜訊等級上的這一族 score function,生成就化約成求解微分方程。
Demo Ascore 地形隨時間變化轉述者補充
二維資料是三個小團(權重各三分之一,標準差 0.12),前向過程用第 4 節的 VP SDE(\(\beta(t)=0.1+19.9t\),DDPM 的連續版本),這時 \(p_t\) 仍是三個高斯的混合,score 可以精確算出。拖動 \(t\),看密度(填色)和 score(箭頭)怎麼變。
注意兩件事:第一,\(t\) 小時,箭頭只在團的附近有意義,團與團之間的箭頭方向變化很急(B06、B07 說的低密度區);\(t\) 大時,整個平面的箭頭都整齊地指向中心。第二,VP SDE 會把訊號縮小:三個團的中心本身也往原點移動(\(t=1\) 時縮到原本的 0.7%),所以最後的分佈接近 \(\mathcal N(\mathbf 0,\mathbf I)\),和書中最右格「三個叉號擠在中間」一致。
03動機:從離散到連續時間書 §4.1.1
回顧 NCSN 和 DDPM 的前向加雜訊方式。NCSN 用一串遞增的雜訊等級 \(\{\sigma_i\}_{i=1}^L\),每個乾淨樣本 \(\mathbf x_0\sim p_{\text{data}}\) 被擾動成
$$\mathbf x_{\sigma_i}=\mathbf x_0+\sigma_i\boldsymbol\epsilon_i,\qquad\boldsymbol\epsilon_i\sim\mathcal N(\mathbf 0,\mathbf I).$$DDPM 則用變異數時程 \(\{\beta_i\}_{i=1}^L\) 一步步注入雜訊(注意上面的記號提醒):
$$\mathbf x_i=\sqrt{1-\beta_i}\,\mathbf x_{i-1}+\sqrt{\beta_i}\,\boldsymbol\epsilon_i,\qquad\boldsymbol\epsilon_i\sim\mathcal N(\mathbf 0,\mathbf I).$$把兩者放到同一個離散時間格點上看,從 \(\mathbf x_t\) 到 \(\mathbf x_{t+\Delta t}\) 的循序更新是(書的註腳:\(\mathbf x(t)\) 和 \(\mathbf x_t\) 混用,其他隨時間變化的量也一樣):
$$\begin{aligned}\textbf{NCSN:}&\quad\mathbf x_{t+\Delta t}=\mathbf x_t+\sqrt{\sigma_{t+\Delta t}^2-\sigma_t^2}\,\boldsymbol\epsilon_t&&\approx\mathbf x_t+\sqrt{\frac{d\sigma_t^2}{dt}\Delta t}\,\boldsymbol\epsilon_t\\\textbf{DDPM:}&\quad\mathbf x_{t+\Delta t}=\sqrt{1-\beta(t)\Delta t}\,\mathbf x_t+\sqrt{\beta(t)\Delta t}\,\boldsymbol\epsilon_t&&\approx\mathbf x_t-\frac12\beta(t)\mathbf x_t\,\Delta t+\sqrt{\beta(t)\Delta t}\,\boldsymbol\epsilon_t,\end{aligned}$$其中 \(\boldsymbol\epsilon_t\sim\mathcal N(\mathbf 0,\mathbf I)\)。
兩個「≈」
NCSN。\(\sigma^2_{t+\Delta t}-\sigma_t^2=\frac{d\sigma_t^2}{dt}\Delta t+\mathcal O(\Delta t^2)\)(一階 Taylor 展開)。相鄰兩級的雜訊差就是 B07 第 4 節表裡推出來的 \(\sqrt{\sigma_{i+1}^2-\sigma_i^2}\)。
DDPM。把第 \(i\) 步的變異數寫成 \(\beta_i=\beta(t)\Delta t\):步數越多、每步越小,每步注入的變異數和 \(\Delta t\) 成正比。再用 \(\sqrt{1-u}=1-\tfrac12u+\mathcal O(u^2)\),\(u=\beta(t)\Delta t\),得到 \(\sqrt{1-\beta(t)\Delta t}\,\mathbf x_t\approx\mathbf x_t-\tfrac12\beta(t)\mathbf x_t\Delta t\)。
有趣的是,兩種加雜訊過程都遵循同一個結構:
\(\mathbf f:\mathbb R^D\times\mathbb R\to\mathbb R^D\),\(g:\mathbb R\to\mathbb R\),分別是
$$\textbf{NCSN:}\quad\mathbf f(\mathbf x,t)=\mathbf 0,\quad g(t)=\sqrt{\frac{d\sigma^2(t)}{dt}};\qquad\textbf{DDPM:}\quad\mathbf f(\mathbf x,t)=-\frac12\beta(t)\,\mathbf x,\quad g(t)=\sqrt{\beta(t)}.$$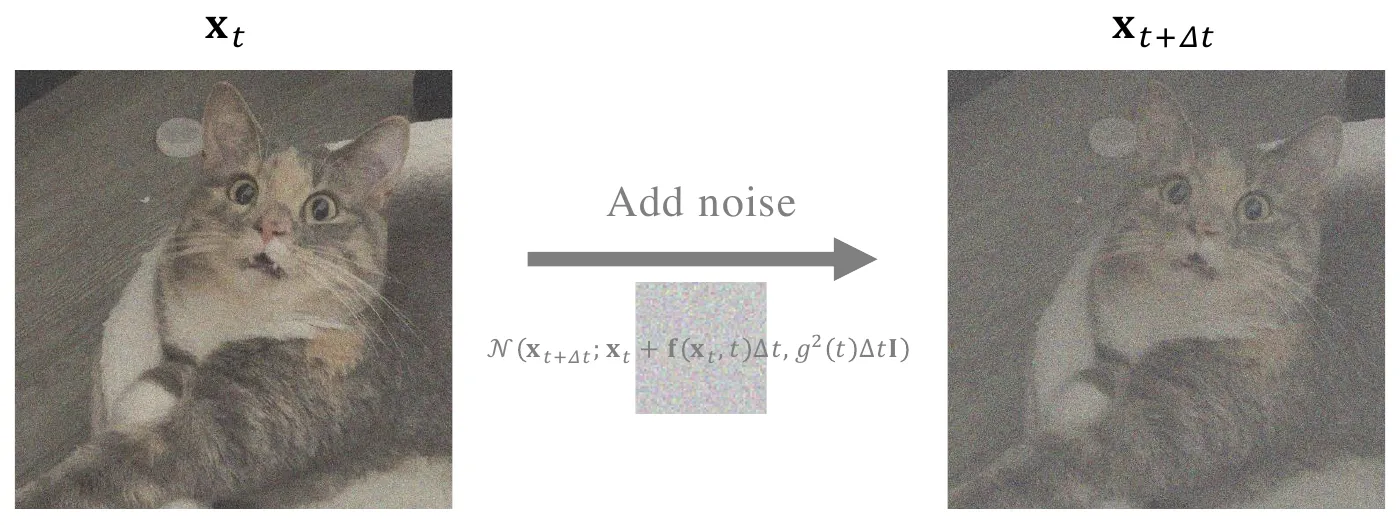
這個寫法對應下面的高斯轉移:
$$p(\mathbf x_{t+\Delta t}\mid\mathbf x_t):=\mathcal N\big(\mathbf x_{t+\Delta t};\,\mathbf x_t+\mathbf f(\mathbf x_t,t)\Delta t,\,g^2(t)\Delta t\,\mathbf I\big),$$這裡稍微濫用記號,把 \(\mathbf x_t\) 當成固定的樣本、\(\mathbf x_{t+\Delta t}\) 當成隨機變數。
當 \(\Delta t\to0\)(概念上可以理解成準備了無限多層雜訊),離散時間的過程收斂到一條隨時間往前演化的連續時間 SDE:
$$d\mathbf x(t)=\mathbf f(\mathbf x(t),t)\,dt+g(t)\,d\mathbf w(t),$$\(\mathbf w(t)\) 是標準的 Wiener process(布朗運動)。
書的註腳:當 \(\Delta t\to0\),上面的前向轉移核收斂到對應的 Itô SDE 的解。完全嚴格的證明需要進階的結果,書把它留給文獻。
書的附錄 A 有 SDE 基礎的簡短介紹,附錄 C 有更進階的討論。不過,離散與連續寫法之間的對應可以這樣理解:
- \(\mathbf x(t+\Delta t)-\mathbf x(t)\approx d\mathbf x(t)\);
- \(\Delta t\approx dt\);
- \(\sqrt{\Delta t}\,\boldsymbol\epsilon_t\sim\mathcal N(\mathbf 0,\Delta t\,\mathbf I)\approx d\mathbf w(t)\)。
為什麼雜訊項是 \(\sqrt{\Delta t}\),不是 \(\Delta t\)
把一段時間 \(t\) 切成 \(n\) 步,每步加獨立的雜訊 \(c\,\boldsymbol\epsilon\),總變異數是 \(nc^2\)。要讓總變異數有限、而且和怎麼切無關(等於 \(t\)),每步的 \(c^2\) 必須是 \(t/n=\Delta t\),也就是 \(c=\sqrt{\Delta t}\)。如果每步是 \(\Delta t\),總變異數 \(n\Delta t^2=t\Delta t\to0\),雜訊在極限下消失;如果更大,總變異數爆掉。這也是 B05 的 Langevin 更新裡有 \(\sqrt{2\eta}\) 的原因。
一旦指定了漂移 \(\mathbf f(\mathbf x,t)\) 和擴散係數 \(g(t)\),前向 SDE 會自動誘導出一條反向 SDE,把終點的雜訊分佈運送回資料分佈。令人意外的是,反向動態裡只有一個未知的項:每個連續時間等級上的 score function。這讓 score matching 成為訓練目標;學會 score 之後,取樣就是用學到的 score 數值積分反向 SDE。書在 §4.3(B09)講實作,這一頁先看前向和反向過程的理論基礎。
04前向 SDE:從資料到雜訊書 §4.1.2
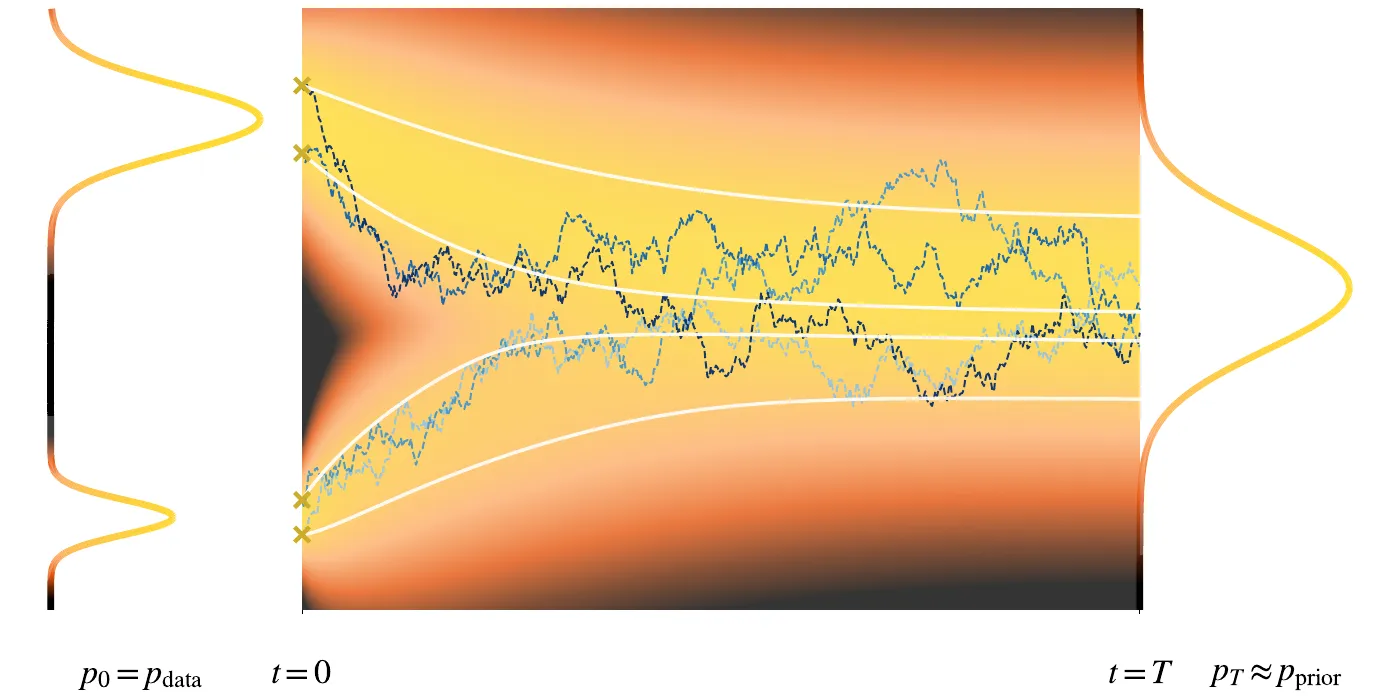
有了這個寫法,先前基於離散時間的方法,例如 NCSN(Song & Ermon 2019)和 DDPM(Sohl-Dickstein et al. 2015;Ho et al. 2020),都能統一到連續時間的框架下:一個由定義在 \([0,T]\) 上的前向 SDE 支配的隨機過程 \(\mathbf x(t)\):
\(\mathbf f(\cdot,t):\mathbb R^D\to\mathbb R^D\) 是漂移(drift),\(g(t)\in\mathbb R\) 是純量的擴散係數,\(\mathbf w(t)\) 是標準的 Wiener process。我們把它叫做前向 SDE,它描述乾淨資料怎麼隨時間逐漸被擾動成雜訊。
一旦指定了漂移 \(\mathbf f\) 和擴散係數 \(g\),前向過程就完全確定了,它描述資料變數怎麼透過注入高斯雜訊而逐步被破壞。具體來說,它誘導出兩族隨時間變化的密度。
擾動核
條件分佈 \(p_t(\mathbf x_t\mid\mathbf x_0)\) 描述一個乾淨資料樣本 \(\mathbf x_0\sim p_{\text{data}}\) 怎麼在時間 \(t\) 演變成它的帶雜訊版本 \(\mathbf x_t\)。一般而言,前向 SDE 的漂移 \(\mathbf f(\mathbf x,t)\) 可以是 \(\mathbf x\) 的任意函數,但常見、而且在解析上方便的選擇是假設它是仿射的:
$$\mathbf f(\mathbf x,t)=f(t)\,\mathbf x,$$\(f(t)\) 是 \(t\) 的純量函數,通常取非正值。在這個結構下,給定 \(\mathbf x_0\) 的條件過程仍是高斯的,擾動核有封閉形式,由對應的平均與變異數的 ODE 解出(Särkkä & Solin 2019;書的 §4.4.3,B10 第 2 節):
$$p_t(\mathbf x_t\mid\mathbf x_0)=\mathcal N\big(\mathbf x_t;\,\mathbf m(t),\,P(t)\mathbf I_D\big),\qquad\mathbf m(t)=\exp\!\Big(\int_0^tf(u)\,du\Big)\mathbf x_0,\qquad P(t)=\int_0^t\exp\!\Big(2\int_s^tf(u)\,du\Big)g^2(s)\,ds,$$初始條件 \(\mathbf m(0)=\mathbf x_0\)、\(P(0)=0\)。
平均與變異數的 ODE(用離散的一步推出來)
用一步的更新 \(\mathbf x_{t+\Delta t}=\mathbf x_t+f(t)\mathbf x_t\Delta t+g(t)\sqrt{\Delta t}\,\boldsymbol\epsilon\),\(\boldsymbol\epsilon\) 和 \(\mathbf x_t\) 獨立。給定 \(\mathbf x_0\),取平均:\(\mathbf m(t+\Delta t)=(1+f\Delta t)\mathbf m(t)\),所以 \(\mathbf m'=f\,\mathbf m\)。取(每個座標的)變異數:\(P(t+\Delta t)=(1+f\Delta t)^2P(t)+g^2\Delta t\),展開後 \(P'=2fP+g^2\)。
解:\(\mathbf m'=f\mathbf m\) 的解是 \(\mathbf m(t)=e^{\int_0^tf}\mathbf x_0\)。\(P'=2fP+g^2\) 用積分因子 \(e^{-2\int_0^tf}\):\(\big(e^{-2\int_0^tf}P\big)'=e^{-2\int_0^tf}g^2\),從 0 積到 \(t\)、用 \(P(0)=0\),再乘回 \(e^{2\int_0^tf}\),得到 \(P(t)=\int_0^te^{2\int_s^tf(u)du}g^2(s)\,ds\)。
每一步都是「高斯的線性函數加獨立高斯」,所以分佈一直是高斯。
代入 NCSN 和 DDPM
NCSN(\(f=0\)、\(g^2=d\sigma^2/dt\)):\(\mathbf m(t)=\mathbf x_0\),\(P(t)=\int_0^t\frac{d\sigma^2}{ds}ds=\sigma^2(t)-\sigma^2(0)\)。若 \(\sigma(0)=0\),就是 \(\mathbf x_t=\mathbf x_0+\sigma(t)\boldsymbol\epsilon\):B07 的擾動核。
DDPM(\(f=-\tfrac12\beta\)、\(g^2=\beta\)):令 \(B(t)=\int_0^t\beta\)。\(\mathbf m(t)=e^{-B(t)/2}\mathbf x_0\),\(P(t)=\int_0^te^{-(B(t)-B(s))}\beta(s)ds=1-e^{-B(t)}\)。所以 \(\mathbf x_t=e^{-B/2}\mathbf x_0+\sqrt{1-e^{-B}}\,\boldsymbol\epsilon\):訊號係數平方加雜訊變異數恆為 1,正是 B04 的 \(\bar\alpha\) 結構,\(\bar\alpha(t)=e^{-B(t)/2}\)。B04 的 demo 用的 \(\bar\alpha(t)^2=e^{-(0.1t+9.95t^2)}\) 就是 \(\beta(t)=0.1+19.9t\) 的情況,這也是 Song et al. (2020) 的預設值。第 4.4 節(B10)會把它們叫做 VE 和 VP SDE。
這個顯式的形式讓我們可以給定 \(\mathbf x_0\) 直接抽 \(\mathbf x_t\),不必數值積分 SDE,所以叫做 simulation-free。NCSN 和 DDPM 都屬於這種仿射漂移的情況。書接下來對任意漂移 \(\mathbf f(\mathbf x,t)\) 發展一般理論,需要封閉形式的分析時再回到仿射漂移。
邊際密度
時間邊際密度 \(p_t(\mathbf x_t)\) 由對擾動核積分得到:
$$p_t(\mathbf x_t):=\int p_t(\mathbf x_t\mid\mathbf x_0)\,p_{\text{data}}(\mathbf x_0)\,d\mathbf x_0,\qquad p_0=p_{\text{data}}.$$適當選擇係數 \(f(t)\) 和 \(g(t)\),前向過程會逐漸加雜訊,直到初始狀態的影響實際上被遺忘。當 \(T\) 很大,條件分佈 \(p_T(\mathbf x_T\mid\mathbf x_0)\) 不再依賴 \(\mathbf x_0\),因為它的平均演化成
$$\mathbf m(T)=\exp\!\Big(\int_0^Tf(u)\,du\Big)\mathbf x_0\longrightarrow\mathbf 0,\qquad T\to\infty,$$前提是 \(f(u)\) 非正,讓指數因子衰減。同時變異數增長並穩定到所選的先驗分佈。因此,邊際
$$p_T(\mathbf x_T)=\int p_T(\mathbf x_T\mid\mathbf x_0)\,p_{\text{data}}(\mathbf x_0)\,d\mathbf x_0$$一開始是對資料樣本的複雜混合,最後收斂到簡單的先驗 \(p_{\text{prior}}\),通常是高斯。在這個極限下
$$p_T(\mathbf x_T)\approx p_{\text{prior}}(\mathbf x_T)\quad\text{而且}\quad p_T(\mathbf x_T\mid\mathbf x_0)\approx p_{\text{prior}}(\mathbf x_T),$$所以前向過程把任何資料分佈都映射到一個好處理的先驗,為反轉和生成提供了方便的起點。
轉述者注:嚴格說,「\(f\) 非正讓平均趨近 0」需要 \(\int_0^Tf\to-\infty\);NCSN 的 \(f=0\) 不滿足,它的平均不衰減,靠的是變異數 \(\sigma^2(T)\) 大到讓資料的位置相對可以忽略(B07 第 4 節的先驗近似)。書在 §4.4(B10)分別處理這兩種情況。
Demo B擾動核的封閉解 vs. 直接模擬 SDE轉述者補充
從一個固定的起點 \(x_0=1.5\) 出發,用 Euler–Maruyama 一步步模擬前向 SDE(4,000 條路徑),把時間 \(t\) 的樣本直方圖和上面的封閉解 \(\mathcal N(m(t),P(t))\) 比較。VP 用 \(\beta(t)=0.1+19.9t\);VE(NCSN 型,\(f=0\))用 \(\sigma(t)=0.01\cdot(50/0.01)^t\),\(g(t)=\sqrt{d\sigma^2/dt}\)。
瀏覽器實測(4,000 條路徑,標準差的抽樣誤差約 1%):
| 情況 | 封閉解(平均、標準差) | 10 步 | 100 步 | 1,000 步 |
|---|---|---|---|---|
| VP,\(t=0.3\) | 0.9443、0.7770 | 0.9679、0.7713 | 0.9552、0.7813 | 0.9442、0.7699 |
| VP,\(t=1\) | 0.0099、1.000 | \(-0.030\)、1.321 | 0.022、1.022 | 0.027、1.009 |
| VE,\(t=0.3\) | 1.500、0.1283 | 1.499、0.1120 | 1.502、0.1270 | 1.501、0.1271 |
| VE,\(t=1\) | 1.500、50.00 | 1.01、30.41 | 2.18、47.73 | 2.39、49.99 |
- 封閉解是對的:步數夠多時,模擬的平均和標準差都落在封閉解的抽樣誤差內(VE 在 \(t=1\) 時平均差 0.9,但標準差是 50,4,000 條路徑的平均本身就有約 ±0.8 的誤差)。所以訓練時可以直接用封閉解抽 \(\mathbf x_t\),完全不必模擬:這就是 simulation-free。
- 步數少時 Euler–Maruyama 有誤差:VP 在 \(t=1\) 只用 10 步時,標準差變成 1.321(應該是 1)。因為 \(\beta\) 在 \(t\) 接近 1 時約 20,\(\beta\Delta t=2\),「一步」已經大到不能用一階近似。VE 只用 10 步則低估了變異數(\(\sigma(t)\) 是指數成長,左端點的 \(g\) 太小)。如果每次訓練都得這樣模擬,既慢又不準。
05反向 SDE:生成書 §4.1.3
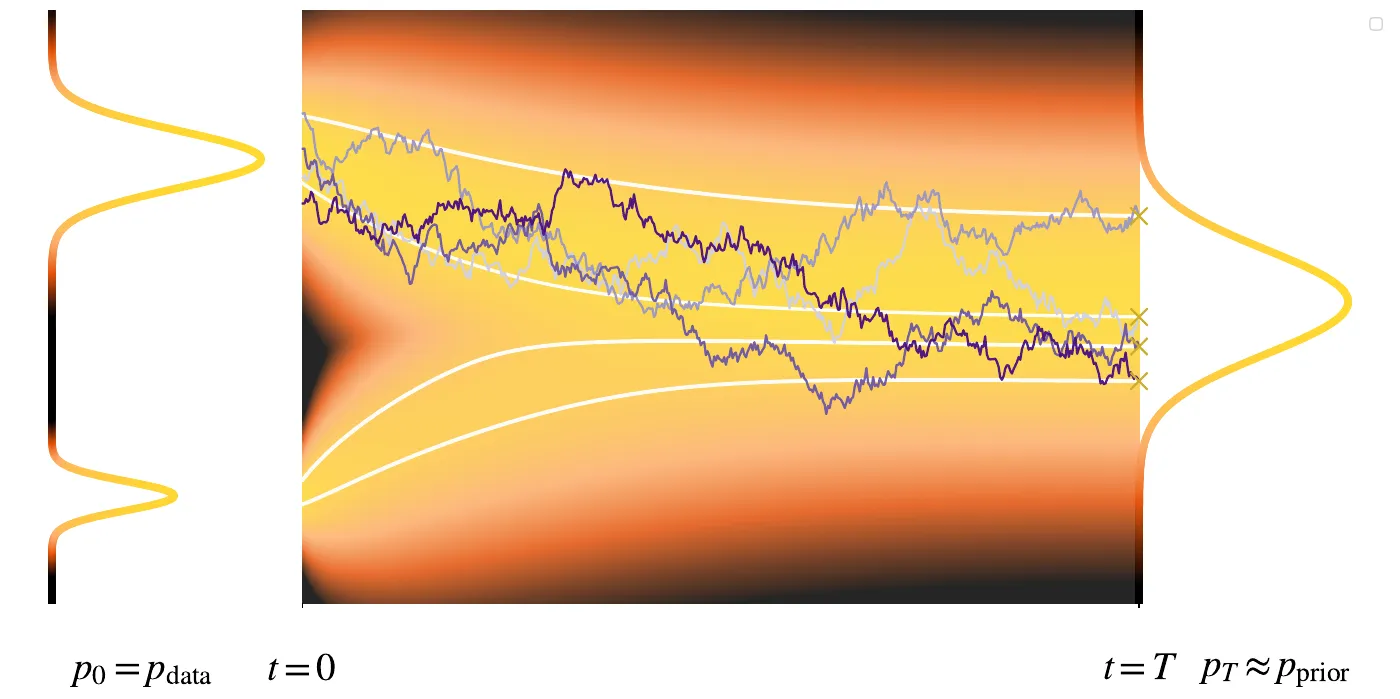
直覺上,從雜訊生成資料可以靠「倒轉」前向過程:從先驗分佈抽一個隨機點,讓它沿時間倒著演化,得到生成的樣本。對確定性的系統(也就是 ODE),這個想法很自然:沒有隨機性,倒轉時間就是沿著同一條路把點的軌跡反方向走回去(書的註腳:技術上這對應用時間翻轉的代換 \(t\leftrightarrow T-t\) 去解 ODE)。相反地,SDE 每個時間步都有隨機性,同一個點可以沿著許多可能的隨機軌跡演化,所以倒轉這種過程比較微妙(書的註腳:天真地翻轉時間,得不到正確的反向過程,Demo C 會看到)。
雖然個別的隨機軌跡無法倒轉,了不起的洞見是:軌跡的分佈可以倒轉。這由 Anderson (1982) 的一個基礎結果正式確立:前向 SDE 的時間反轉過程 \(\{\bar{\mathbf x}(t)\}_{t\in[0,T]}\)(用橫線和前向過程區分)本身也由一條定義良好的 SDE 支配。這個反向過程從 \(T\) 演化到 0,動態是
\(\bar{\mathbf w}(t)\) 是反向時間的標準 Wiener process,定義為 \(\bar{\mathbf w}(t):=\mathbf w(T-t)-\mathbf w(T)\)。
實際上怎麼一步步走:把 \(dt\lt0\) 寫清楚
取步長 \(\Delta t\gt0\),從 \(t\) 走到 \(t-\Delta t\)。上式的 \(dt\) 是 \(-\Delta t\),雜訊項的大小仍是 \(g\sqrt{\Delta t}\)(方向是隨機的,正負號不影響分佈):
$$\bar{\mathbf x}_{t-\Delta t}=\bar{\mathbf x}_t-\big[\mathbf f(\bar{\mathbf x}_t,t)-g^2(t)\nabla\log p_t(\bar{\mathbf x}_t)\big]\Delta t+g(t)\sqrt{\Delta t}\,\mathbf z,\qquad\mathbf z\sim\mathcal N(\mathbf 0,\mathbf I).$$所以每一步是:把前向的漂移倒過來(\(-\mathbf f\Delta t\)),加上一個沿 score 方向的修正(\(+g^2\nabla\log p_t\,\Delta t\)),再加上新的雜訊。Demo C 就是這樣跑的;書在 §4.3(B09)正式寫出這個 Euler–Maruyama 更新。
為了建立對反向 SDE 的直覺,書在 §4.2.2(B09)給了一個具體的例子:高斯資料分佈配上線性高斯的動態。這個設定在解析上好處理:只用基本的微積分和線性代數,就能直接推出時間反轉的公式,不必動用 Anderson 的完整一般理論。
注意,隨機性(\(g\ne0\))帶來了一個額外的修正項 \(-g^2(t)\nabla_{\mathbf x}\log p_t(\bar{\mathbf x}(t))\),它把擴散的效果算進去,確保反向動態正確地重現前向 SDE 所誘導的邊際分佈演化(§4.2,B09)。
概念上,反向過程為什麼行得通?
書在 §4.6.2(B10 第 5 節)把反向 SDE 連回 DDPM 的變分框架,給了一個直覺的推導(選讀但很有啟發)。這裡先給互補的直覺:反向動態怎麼從雜訊還原出有結構的資料。
乍看之下,反向過程裡有布朗雜訊似乎很矛盾:既然前向擴散把資料攤成越來越亂的組態,倒轉這個過程、尤其是一個又透過 \(\bar{\mathbf w}(t)\) 加入更多隨機性的過程,怎麼能產生集中在資料流形附近、乾淨又有結構的樣本?關鍵是:反向 SDE 不是隨便注入隨機性。擴散項 \(g(t)\,d\bar{\mathbf w}(t)\) 一定和 score 驅動的漂移 \(-g^2(t)\nabla_{\mathbf x}\log p_t(\bar{\mathbf x}(t))\) 綁在一起。兩者互相平衡:score 把軌跡導向密度較高的區域,雜訊帶來受控制的隨機性,讓過程能探索,又不會壓倒整個動態。
回到 B05 的 Langevin 直覺就看得更清楚。當 \(f(t)\equiv0\),反向 SDE 是
$$d\bar{\mathbf x}(t)=-g^2(t)\nabla_{\mathbf x}\log p_t(\bar{\mathbf x}(t))\,dt+g(t)\,d\bar{\mathbf w}(t).$$把時間改成往前跑:\(s:=T-t\)(所以 \(dt=-ds\)),並在分佈的意義上重新命名布朗運動,讓 \(d\bar{\mathbf w}(t)=-d\mathbf w_s\)。記 \(\bar{\mathbf x}_s:=\bar{\mathbf x}(T-s)\)、\(\pi_s:=p_{T-s}\),得到
$$d\bar{\mathbf x}_s=g^2(T-s)\,\nabla\log\pi_s(\bar{\mathbf x}_s)\,ds+g(T-s)\,d\mathbf w_s=2\tau(s)\,\nabla\log\pi_s(\bar{\mathbf x}_s)\,ds+\sqrt{2\tau(s)}\,d\mathbf w_s,\qquad\tau(s):=\tfrac12g^2(T-s).$$換時鐘的每一步
漂移項:\(-g^2\nabla\log p_t\,dt=-g^2\nabla\log p_{T-s}\,(-ds)=g^2(T-s)\nabla\log\pi_s\,ds\)。
雜訊項:\(g\,d\bar{\mathbf w}(t)\)。\(\bar{\mathbf w}\) 的增量和 \(-\mathbf w_s\) 的增量有相同的分佈(都是平均 0、變異數 \(|dt|=ds\) 的高斯,而高斯對稱),所以可以寫成 \(-g\,d\mathbf w_s\),再把負號吸收進對稱的雜訊,記成 \(+g\,d\mathbf w_s\)。書寫的「在分佈的意義上重新命名」就是這個意思:只在乎分佈,不在乎個別的路徑。
第二個等號:令 \(2\tau=g^2\),則 \(g=\sqrt{2\tau}\)。
轉述者補充:這個「Langevin 形式」是類比,不是同一條方程。B05 的 Langevin SDE 是 \(d\mathbf x=\nabla\log p\,dt+\sqrt2\,d\mathbf w\):漂移係數和雜訊變異數的比例是 \(1:2\),所以它的穩態是 \(p\)。一般地,\(d\mathbf x=a\nabla\log\pi\,dt+\sqrt{2b}\,d\mathbf w\) 的穩態是正比於 \(\pi^{a/b}\) 的分佈。上式 \(a=2\tau\)、\(b=\tau\),如果 \(\pi_s\) 固定不動,它的穩態會是 \(\pi^2\)(比 \(\pi\) 更集中),不是 \(\pi\)。反向 SDE 之所以每個時刻都恰好是 \(p_t\),靠的是 \(\pi_s\) 本身也在隨時間變窄、而且整條反向過程從 \(p_T\) 出發,這由 Anderson 的定理(以及 B09 的 Fokker–Planck 論證)保證,而不是靠「在每個時刻跑到 Langevin 的平衡」。書用這個形式說明的是方向性的直覺:漂移沿著 score、雜訊強度跟著 \(g\) 退火。
這是溫度隨時間變化(\(\tau(s)\))、目標是不斷演化的密度 \(\pi_s\) 的 Langevin 形式。由 Tweedie 公式(B06),score 的方向 \(\nabla\log\pi_s\) 在每個時間切片都指向條件的乾淨訊號,所以漂移不斷把去雜訊後的結構「拉回來」。
關鍵是:\(g(t)\) 沿著反向軌跡在退火。一開始(\(s\approx0\),也就是 \(t\approx T\)),\(g(T-s)\) 通常比較大,注入的雜訊比較強,過程廣泛地探索。隨著 \(s\) 增加,\(g(T-s)\) 變小,隨機項變弱,score 項主導,把樣本拉進 \(\pi_s\) 的高密度區域;到 \(s=T\)(也就是 \(t=0\)),軌跡集中在資料流形附近。
和 B07 的 annealed Langevin 比一比
B07 的 annealed Langevin 在每個雜訊等級 \(\sigma_\ell\) 固定目標、跑很多步 Langevin,再換下一級:目標是一級一級跳的,而且每級要跑到大致平衡。反向 SDE 則是目標 \(\pi_s\) 連續地變,每個時刻只走一小步,不需要在每個 \(t\) 都達到平衡:Anderson 的定理保證只要從 \(p_T\) 出發,每個時刻的分佈都恰好是 \(p_t\)。這是為什麼反向 SDE(以及 DDPM 的取樣)不必像 NCSN 那樣在每一級跑 \(K\) 步。
反向 SDE 能做什麼:總覽
令人著迷的是,時間相依的 score function
$$\mathbf s(\mathbf x,t):=\nabla_{\mathbf x}\log p_t(\mathbf x)$$就這樣自然地出現在反向 SDE 裡。一旦指定了前向係數 \(f(t)\) 和 \(g(t)\),score 就是反向動態裡唯一剩下的未知量。這突顯了它的核心角色:有了 score,反向過程就確定了,取樣就是用學到的 score 數值積分反向 SDE。
真正的 score 一般沒有封閉形式,所以沿用第 3 章的做法,訓練一個神經網路 \(\mathbf s_{\bm\phi}(\mathbf x,t)\) 用 score matching 近似它(§4.3.1,B09)。把反向 SDE 裡的 \(\mathbf s(\mathbf x,t)\) 換成 \(\mathbf s_{\bm\phi}(\mathbf x,t)\),反向動態就完全確定了。
生成對應於從 \(t=T\)、以 \(\mathbf x_T\sim p_{\text{prior}}\) 出發,倒著解反向 SDE 到 \(t=0\)。重要的是,Anderson (1982) 證明前向和反向過程的邊際密度一致,所以當 \(p_{\text{prior}}\approx p_T\),\(t=0\) 的樣本近似服從 \(p_{\text{data}}\)。書在 §4.3.2(B09)會再深入。
06確定性的過程:probability flow ODE書 §4.1.4
反向 SDE 帶有隨機性,可能增加生成樣本的多樣性。但一個問題出現了:
受 Maoutsa et al. (2020) 啟發,Song et al. (2020) 也引入了一個確定性的過程:一條 ODE,它演化樣本的方式讓邊際分佈和前向 SDE 相同。這個過程 \(\{\tilde{\mathbf x}(t)\}_{t\in[0,T]}\)(用波浪號和前向、反向 SDE 的過程區分;書之後會省略這個區分)叫做 Probability Flow ODE(PF-ODE):
和 SDE 的情況類似,可以把真正的 score 換成學到的近似,從 \(t=T\) 積分到 \(t=0\) 來生成樣本。具體地說,生成的樣本(PF-ODE 在 \(t=0\) 的解)是
$$\tilde{\mathbf x}(T)+\int_T^0\Big[\mathbf f(\tilde{\mathbf x}(\tau),\tau)-\frac12\,g^2(\tau)\,\nabla_{\mathbf x}\log p_\tau(\tilde{\mathbf x}(\tau))\Big]d\tau,$$初始條件 \(\tilde{\mathbf x}(T)\sim p_{\text{prior}}\)。這個積分沒有封閉形式,實務上的生成要靠數值求解器(例如 Euler 法,§4.3.2,B09)。
和反向 SDE 相比,PF-ODE 有兩個關鍵優點:
- 兩個方向都能積分:只要在選定的端點給初始條件,同一條方程式可以從 \(t=0\) 積到 \(t=T\),也可以從 \(t=T\) 積到 \(t=0\)。SDE 一般只能沿時間往前積分,形成對比。
- 可以用大量現成的 ODE 數值求解器,它們都經過充分發展。
書強調:PF-ODE 不是把反向 SDE 的擴散項直接拿掉得來的;它漂移項裡的 \(\tfrac12\) 有原則性的來源。大致上說,PF-ODE 是這樣得到的:選一條 ODE 的漂移,讓它的演化保持和前向 SDE 相同的邊際密度。確保這種邊際對齊的原理(Fokker–Planck 方程;Øksendal 2003)在下一節(B09)詳談。
先偷看:\(\tfrac12\) 從哪裡來(B09 會正式推導)
前向 SDE 的邊際密度 \(p_t\) 滿足 Fokker–Planck 方程(補充課 F):
$$\partial_tp_t=-\nabla\cdot(\mathbf f\,p_t)+\tfrac12g^2\,\Delta p_t.$$把擴散項改寫:\(\Delta p_t=\nabla\cdot\nabla p_t=\nabla\cdot(p_t\nabla\log p_t)\)。代回去:
$$\partial_tp_t=-\nabla\cdot\Big[\big(\mathbf f-\tfrac12g^2\nabla\log p_t\big)\,p_t\Big].$$右邊正是「粒子沿著速度場 \(\mathbf v=\mathbf f-\tfrac12g^2\nabla\log p_t\) 確定性地移動」時,密度滿足的連續方程(補充課 C)。所以沿著這個 \(\mathbf v\) 走的 ODE,和前向 SDE 有完全相同的邊際密度。\(\tfrac12\) 來自 Fokker–Planck 方程裡擴散項的 \(\tfrac12g^2\)。反向 SDE 的 \(g^2\) 則是另一個選擇:漂移多減一份 \(\tfrac12g^2\nabla\log p_t\),同時加回雜訊(它帶來的擴散抵消多減的那一份)。Demo C 把 \(\tfrac12\) 換成 1 又不加雜訊,結果完全錯。
Demo C四種「倒回去」的方法轉述者補充
一維資料是兩個高斯的混合(上:中心 1.2、標準差 0.25、權重 0.6;下:中心 \(-1.0\)、標準差 0.2、權重 0.4),前向過程是 VP SDE(\(\beta(t)=0.1+19.9t\),\(T=1\))。這時每個 \(p_t\) 都是兩個高斯的混合,score 可以精確算出,所以這裡比較的是四種動態本身,不受網路誤差影響。2,000 個粒子從 \(\mathcal N(0,1)\)(\(\approx p_1\))出發,用 \(N\) 步從 \(t=1\) 走到 \(t=0.001\):
- 反向 SDE:漂移 \(\mathbf f-g^2\nabla\log p_t\),加雜訊;
- PF-ODE:漂移 \(\mathbf f-\tfrac12g^2\nabla\log p_t\),不加雜訊;
- 天真地翻轉時間:只把前向 SDE 倒著跑(漂移 \(\mathbf f\)、加雜訊),沒有 score;
- 「把反向 SDE 的雜訊拿掉」:漂移 \(\mathbf f-g^2\nabla\log p_t\),不加雜訊(係數 1 而不是 \(\tfrac12\))。
瀏覽器實測(精確 score,2,000 個粒子;上團比例的真值 60%、標準差 1.102):
| 動態 | 20 步 | 100 步 | 1,000 步 |
|---|---|---|---|
| 反向 SDE | 59.4%,\(W_1\) 0.039 | 59.6%,0.023 | 59.7%,0.014 |
| PF-ODE | 59.8%,0.022 | 60.1%,0.013 | 60.3%,0.013 |
| 天真地翻轉時間 | 約 49–50%,標準差 128–214,\(W_1\) 上百 | ||
| 係數 1、不加雜訊 | 100%,標準差 ≤ 0.002,\(W_1\) 約 0.98 | ||
- 反向 SDE 和 PF-ODE 都取回資料分佈:步數夠多時,兩者和 \(p_{\text{data}}\) 的距離(0.013–0.014)都比「從 \(p_{\text{data}}\) 直接抽 2,000 個樣本」的約 0.02 還小。軌跡圖看得出兩者走法完全不同:SDE 的軌跡抖動、彼此交錯;ODE 的軌跡平滑、互不交叉,正如書中的兩張圖。
- PF-ODE 在步數少時比較準:20 步時 ODE 的距離 0.022,SDE 是 0.039。確定性的 ODE 沒有每步注入新雜訊的離散化誤差,這是第 9 章(B24–B27)用 ODE 求解器加速取樣的起點。
- 天真地翻轉時間會爆掉:VP 前向的漂移 \(-\tfrac12\beta x\) 倒過來變成 \(+\tfrac12\beta x\),訊號被放大 \(e^{\frac12\int_0^1\beta}\approx e^{5}\approx150\) 倍,標準差到了一兩百,兩團的比例也只是一半一半。沒有 score,就沒有任何東西把樣本拉回資料。
- 係數 1、不加雜訊:所有樣本縮成一點:反向 SDE 比 PF-ODE 多減了一份 \(\tfrac12g^2\nabla\log p_t\)(多一份往高密度收縮的力),本來靠新注入的雜訊把它撐開;拿掉雜訊、留下這份收縮,粒子就一路縮在一起,最後全部落在同一點(在權重較大的上團裡)。這就是書說的:\(\tfrac12\) 不是「把雜訊拿掉」得來的。