連續時間 consistency model 與 CTM:讓格點消失,讓跳躍任意
B29 的 consistency model 在一個固定的時間格點上訓練,格點太粗有偏差、太細收斂慢。這一頁先把格點拿掉:讓 \(\Delta s\to0\),離散損失的梯度(除以 \(\Delta s\))收斂到一個連續時間的偽目標,裡面只剩網路沿軌跡的全導數「切向量」。接著看 sCM 怎麼用三角時程、參數化和幾個技巧讓這個切向量不要爆掉。後半講 CTM:它學一般的 flow map \(\bm\Psi_{s\to t}\),用一個 Euler 啟發的參數化同時拿到「長跳」和「瞬時速度」,可以不靠老師、用自己誘導的 ODE 當老師訓練,取樣時還能用 γ 控制要多少隨機性。
讀完這頁你應該能夠
- 從局部一致性 \(\frac{d}{ds}\mathbf f^*(\mathbf x(s),s)=\mathbf 0\) 寫出連續時間的條件,說明它和 PINN 式殘差的關係。
- 推導:離散 CM 損失的梯度除以 \(\Delta s\),在 \(\bm\theta=\bm\theta^-\) 處收斂到連續時間偽目標 \(\mathcal L^\infty_{\text{CM}}\) 的梯度;說明為什麼它只是「偽」目標。
- 寫出連續時間 CD 和 CT 的切向量近似,看出兩者在期望上相同。
- 說明 sCM 的三角時程、參數化,以及切向量正規化、warm-up、時間嵌入、可學的時間權重各自處理什麼問題。
- 寫出 CTM 的參數化 \(\mathbf G_{\bm\theta}=\frac ts\mathbf x_s+\frac{s-t}{s}\mathbf g_{\bm\theta}\),說明 \(\mathbf g\) 的對角線就是 diffusion model;描述 CTM 的一致性損失(蒸餾與從頭訓練)、DM 損失與 GAN 損失。
- 寫出 γ 取樣,說明 γ = 1 和 γ = 0 各對應什麼,以及為什麼 γ = 1 的多步取樣會累積誤差。
前置知識
- B29:flow map、半群性質、consistency function 的三個性質、離散時間 CD/CT、CM 的取樣。這一頁直接接續 B29。
- B16:任何仿射流都能寫成三角路徑 \(\cos(u)\mathbf x_0+\sin(u)\bm\epsilon\)(§6.3.3);B15:訓練目標的四個因素(§6.2.2)與 EDM 參數化(附錄 D.6)。
- B12:conditional flow matching 損失;B25:DDIM 和 Euler 的關係(§9.2.2)。
「書 §」標出原文位置。灰框「轉述者補充」是書裡沒有的內容;藍框「推導」展開書中省略的步驟。
01為什麼要連續時間書 §11.3
現在離開 consistency model 的離散時間設定,改用連續時間的觀點。離散的做法固定一個時間格點,只在那些點上訓練;連續的表述則把 flow map 看成對所有時間都有定義。這個轉變去掉了對任意離散化的依賴,和底層動態的對齊也更有原則。它也幫助減少離散積分自然產生的近似誤差,並確保一致性是在全域強制,而不只在選定的幾個步上。
轉述者註:B29 的 Demo B、C 量到了離散格點的兩個代價:\(N\) 小時理想解有偏差,\(N\) 大時資訊一格一格往上傳、收斂慢。連續時間的版本是讓 \(N\to\infty\) 的極限,但要換一種損失才算得動,下面兩節推出來。
02從局部一致性出發書 §11.3.1
為了引出連續時間的表述,先回到 B29 的局部一致性 (iii),也就是可以對時間求導的那個條件。用連鎖律:
$$\frac{d}{ds}\mathbf f^*(\mathbf x(s),s)=\mathbf 0\quad\Longleftrightarrow\quad\big(\nabla_{\mathbf x}\mathbf f^*\big)(\mathbf x(s),s)\cdot\underbrace{\frac{d}{ds}\mathbf x(s)}_{\text{ODE 速度}}+\Big(\frac{\partial}{\partial s}\mathbf f^*\Big)(\mathbf x(s),s)=\mathbf 0,$$其中軌跡 \(\mathbf x(s)\) 沿 PF-ODE 走:
$$\frac{d}{ds}\mathbf x(s)=\mathbf v^*(\mathbf x(s),s).$$這個關係表示 consistency function \(\mathbf f^*\) 沿任何一條 ODE 解軌跡都保持不變。速度場 \(\mathbf v^*\) 實務上可以從預訓練的 diffusion model 估計(有的話),或用 B29 說過的一點近似 \(\alpha'_s\mathbf x_0+\sigma'_s\bm\epsilon\)。
這提示了沿 PF-ODE 軌跡一致性的自然連續時間刻畫。一種可能的做法是像 physics-informed neural networks(PINN,Raissi et al.;Boffi et al. 2024)那樣,直接最小化這個微分條件的殘差:
$$\min_{\bm\theta}\ \mathbb E_{s,\mathbf x_s\sim p_s}\Big[\big\|\partial_s\mathbf f_{\bm\theta}(\mathbf x_s,s)+\big(\partial_{\mathbf x}\mathbf f_{\bm\theta}(\mathbf x_s,s)\big)\mathbf v^*(\mathbf x_s,s)\big\|_2^2\Big].$$不過實務上,Song et al. (2023) 和 Lu & Song (2024) 用的是有 stop-gradient 目標的一致性目標,而不是直接最佳化這個殘差。這引出一個問題:離散的一致性損失在 \(\Delta s\to0\) 時,有沒有一個有意義的無窮小版本?
PINN 式殘差和 stop-gradient 目標差在哪
PINN 殘差把 \(\mathbf f_{\bm\theta}\) 的兩個導數都放進損失、對它們求梯度,需要對網路的 Jacobian 再微分(二階導數),而且單獨看,常數函數 \(\mathbf f\equiv\mathbf c\) 讓殘差為 0,要靠邊界條件排除(和 B29 第 9 節同一件事)。下一節的連續時間目標則把切向量放在 stop-gradient 的那一側:它只當作一個固定的方向,梯度只透過 \(\mathbf f_{\bm\theta}\) 本身的值傳回去,不需要對導數再求導。
03離散梯度的極限書 §11.3.1、附錄 D.5.3
下面的命題說:在 stop-gradient 目標和線上網路重合的比較點,乘上尺度的離散時間梯度,收斂到一個連續時間目標的梯度。離散的損失是
$$\mathcal L^{\Delta s}_{\text{CM}}(\bm\theta,\bm\theta^-):=\mathbb E\Big[\omega(s)\big\|\mathbf f_{\bm\theta}(\mathbf x_s,s)-\mathbf f_{\bm\theta^-}\big(\bm\Psi_{s\to s-\Delta s}(\mathbf x_s),s-\Delta s\big)\big\|_2^2\Big].$$對 B29 的 \(\mathcal L^N_{\text{CD}}\)、\(\mathcal L^N_{\text{CT}}\) 背後的均勻分割,令 \(\Delta s_N:=\frac{T}{N-1}\)。\(N\to\infty\) 時 \(\Delta s_N\to0\),所以上式的無窮小極限就對應到把這些離散目標不斷加細。
證明概要(書的正文)。把 stop-gradient 目標在 \((\mathbf x_s,s)\) 附近做一階 Taylor 展開,可以看到損失到 \(\mathcal O(\Delta s^2)\) 為止,表現得像學生更新 \(\nabla_{\bm\theta}\mathbf f_{\bm\theta}(\mathbf x_s,s)\) 和切向量變化 \(\frac{d}{ds}\mathbf f_{\bm\theta^-}(\mathbf x_s,s)\) 的內積。在 \(\bm\theta=\bm\theta^-\) 取值會消掉零階的差距項,所以除以 \(\Delta s\) 的梯度滿足上式。
完整證明(書 附錄 D.5.3,逐步展開)
記 \(\tilde{\mathbf x}_{s-\Delta s}:=\bm\Psi_{s\to s-\Delta s}(\mathbf x_s)\),並定義線上網路和目標網路在同一點的差
$$\delta\mathbf f:=\mathbf f_{\bm\theta}(\mathbf x_s,s)-\mathbf f_{\bm\theta^-}(\mathbf x_s,s).$$第 1 步:加一項、減一項。
$$\big\|\mathbf f_{\bm\theta}(\mathbf x_s,s)-\mathbf f_{\bm\theta^-}(\tilde{\mathbf x}_{s-\Delta s},s-\Delta s)\big\|_2^2=\Big\|\delta\mathbf f+\Big(\mathbf f_{\bm\theta^-}(\mathbf x_s,s)-\mathbf f_{\bm\theta^-}(\tilde{\mathbf x}_{s-\Delta s},s-\Delta s)\Big)\Big\|_2^2.$$第 2 步:括號裡的 Taylor 展開。oracle flow map 的一階展開是 \(\mathbf x_s-\bm\Psi_{s\to s-\Delta s}(\mathbf x_s)=\mathbf v^*(\mathbf x_s,s)\Delta s+\mathcal O(|\Delta s|^2)\):往回走 \(\Delta s\),位置少了「速度乘時間」。所以目標網路在兩點的差,正好是它沿軌跡的全導數乘 \(\Delta s\):
$$\mathbf f_{\bm\theta^-}(\mathbf x_s,s)-\mathbf f_{\bm\theta^-}(\tilde{\mathbf x}_{s-\Delta s},s-\Delta s)=\frac{d}{ds}\mathbf f_{\bm\theta^-}(\mathbf x_s,s)\,\Delta s+\mathcal O(|\Delta s|^2).$$第 3 步:展開平方。
$$\big\|\cdots\big\|_2^2=\|\delta\mathbf f\|_2^2+2\,\delta\mathbf f^\top\frac{d}{ds}\mathbf f_{\bm\theta^-}(\mathbf x_s,s)\,\Delta s+\mathcal O(|\Delta s|^2).$$第 4 步:對 \(\bm\theta\) 微分。\(\bm\theta^-\) 在 \(\nabla_{\bm\theta}\) 下是常數(stop-gradient,不對目標求梯度),而 \(\delta\mathbf f\) 對 \(\bm\theta\) 的梯度就是 \(\nabla_{\bm\theta}\mathbf f_{\bm\theta}(\mathbf x_s,s)\):
$$\nabla_{\bm\theta}\mathcal L^{\Delta s}_{\text{CM}}=\nabla_{\bm\theta}\mathbb E\big[\omega(s)\|\delta\mathbf f\|_2^2\big]+2\,\mathbb E\Big[\omega(s)\,\nabla_{\bm\theta}\mathbf f_{\bm\theta}(\mathbf x_s,s)^\top\frac{d}{ds}\mathbf f_{\bm\theta^-}(\mathbf x_s,s)\Big]\Delta s+\mathcal O(|\Delta s|^2).$$第 5 步:在 \(\bm\theta=\bm\theta^-\) 取值。這時 \(\delta\mathbf f=\mathbf 0\),第一項的梯度 \(2\,\mathbb E[\omega\,\nabla_{\bm\theta}\mathbf f_{\bm\theta}^\top\delta\mathbf f]\) 也是 0。只剩第二項:
$$\nabla_{\bm\theta}\mathcal L^{\Delta s}_{\text{CM}}\Big|_{\bm\theta=\bm\theta^-}=2\,\mathbb E\Big[\omega(s)\,\nabla_{\bm\theta}\mathbf f_{\bm\theta}(\mathbf x_s,s)^\top\frac{d}{ds}\mathbf f_{\bm\theta^-}(\mathbf x_s,s)\Big]\Big|_{\bm\theta=\bm\theta^-}\Delta s+\mathcal O(|\Delta s|^2).$$第 6 步:除以 \(\Delta s\)、取極限。右邊正好是 \(\nabla_{\bm\theta}\mathbb E[2\omega(s)\,\mathbf f_{\bm\theta}^\top\frac{d}{ds}\mathbf f_{\bm\theta^-}]\),因為切向量那一側不依賴 \(\bm\theta\)。證畢。
上面的結果寫在梯度運算子 \(\nabla_{\bm\theta}\) 底下,這樣含 \(\bm\theta^-\) 的項會消失,因為 stop-gradient 把 \(\bm\theta^-\) 當常數。注意 \(\frac{d}{ds}\mathbf f_{\bm\theta^-}(\mathbf x_s,s)\) 是沿 oracle 軌跡的全導數,不是單純對時間的偏導數。
總結:連續時間的 consistency model 可以用下面這個偽目標的梯度訓練(忽略因子 2):
為什麼叫「偽」目標,以及梯度下降在做什麼
值本身沒有意義。\(\mathcal L^\infty_{\text{CM}}\) 是 \(\mathbf f\) 和切向量的內積,可以是負的,也沒有「降到 0 就是最佳」這回事;它只是一個梯度剛好正確的函數。CM 論文(Song et al. 2023 附錄)也這樣稱呼它:不能靠監看它的數值判斷訓練進度,但可以對它做梯度下降。
梯度在推什麼。單一個樣本的梯度是 \(\omega\,(\nabla_{\bm\theta}\mathbf f_{\bm\theta})^\top\frac{d\mathbf f_{\bm\theta^-}}{ds}\)。一步梯度下降讓 \(\mathbf f_{\bm\theta}(\mathbf x_s,s)\) 大約往 \(-\eta\,\omega\frac{d\mathbf f}{ds}\) 的方向移動:如果沿軌跡往雜訊方向(\(s\) 變大)\(\mathbf f\) 在變大,就把 \(\mathbf f(\mathbf x_s,s)\) 往下拉,讓它向軌跡上 \(s\) 較小那一側的值看齊。這正是「切向量趨近 0」也就是局部一致性的方向,而邊界 \(\mathbf f(\mathbf x,0)=\mathbf x\) 決定最後對齊到哪個值。
Demo A梯度收斂到連續版本轉述者補充
一維資料(和 B29 相同:權重 0.6 / 0.4、中心 −1.2 / 1.3、標準差 0.25 / 0.35),用第 5 節 sCM 的三角時程 \(x_s=\cos(s)x_0+\sin(s)z\)、\(z\sim\mathcal N(0,\sigma_{\text d}^2)\)、\(\sigma_{\text d}=1.25\),網路是 \(f_{\bm\theta}=\cos(s)x-\sin(s)\sigma_{\text d}F_{\bm\theta}(x/\sigma_{\text d},s)\),\(F\) 是隨機初始化的 2→32→32→1 tanh MLP(命題對任何 \(\bm\theta\) 都成立)。取同一組樣本(\(s\) 均勻落在 0.05 到 1.5),比較:
- CD:離散目標用精確的 \(\bm\Psi_{s\to s-\Delta s}\)(RK4 解 PF-ODE),連續版本的切向量用精確速度 \(\mathbf v^*\)。
- CT:離散目標用一點估計 \(\cos(s-\Delta s)x_0+\sin(s-\Delta s)z\),連續版本的切向量用一點速度 \(-\sin(s)x_0+\cos(s)z\)。
縱軸是 \(\big\|\frac{1}{\Delta s}\nabla\mathcal L^{\Delta s}-\nabla\mathcal L^\infty\big\|/\|\nabla\mathcal L^\infty\|\),對所有約 1,200 個參數一起算。灰色虛線是斜率 1 的參考線。切向量 \(\frac{d}{ds}F\) 用前向模式自動微分(JVP)一次算出。
讀數(瀏覽器實測,和 Node 原型逐位相同):
- 一階收斂。4,000 個樣本時,\(\Delta s\) 從 0.2 每次減半到 0.003:CD 的相對誤差 \(4.3\times10^{-2}\to2.3\to1.2\to0.61\to0.31\to0.15\to0.077\)(\(\times10^{-2}\)),CT 從 \(5.5\times10^{-2}\) 到 \(1.2\times10^{-3}\),每次都減半。這就是證明裡的 \(\mathcal O(\Delta s^2)/\Delta s=\mathcal O(\Delta s)\)。CT 的誤差常數略大一些。
- 連續時間的 CD 和 CT 只差抽樣雜訊。精確速度和一點速度給出的兩個連續梯度,相對差在 1,000、4,000、16,000 個樣本時分別是 \(3.2\times10^{-2}\)、\(6.4\times10^{-3}\)、\(1.0\times10^{-2}\)。這是抽樣雜訊的大小:不隨 \(\Delta s\) 改變,樣本多時大致變小但會跳動,不是一個固定的偏差。第 4 節解釋為什麼兩者在期望上完全相同。
04連續時間的 CD 與 CT書 §11.3.2
和離散時間一樣,要訓練還得處理切向量裡拿不到的 oracle 速度 \(\mathbf v^*\):
$$\frac{d}{ds}\mathbf f_{\bm\theta^-}(\mathbf x_s,s)=\partial_s\mathbf f_{\bm\theta^-}(\mathbf x_s,s)+\big(\partial_{\mathbf x}\mathbf f_{\bm\theta^-}(\mathbf x_s,s)\big)\,\mathbf v^*(\mathbf x_s,s).$$訓練完連續時間的 CM 之後,取樣和離散時間完全一樣(B29 第 13 節)。
連續時間的 consistency distillation
如果有預訓練的 diffusion model,使 \(\mathbf v_{\bm\phi^\times}\approx\mathbf v^*\),切向量就用下面的替代:
得到的目標記成 \(\mathcal L^\infty_{\text{CM}}(\bm\theta,\bm\theta^-;\bm\phi^\times)\)。命題因此可以改寫成
$$\lim_{N\to\infty}\frac{1}{\Delta s_N}\nabla_{\bm\theta}\mathcal L^N_{\text{CD}}(\bm\theta,\bm\theta^-;\bm\phi^\times)=\nabla_{\bm\theta}\mathcal L^\infty_{\text{CD}}(\bm\theta,\bm\theta^-;\bm\phi^\times).$$連續時間的 consistency training(從頭訓練)
如果沒有預訓練的 diffusion model,oracle 速度 \(\mathbf v^*\) 可以用一點條件估計 \(\alpha'_s\mathbf x_0+\sigma'_s\bm\epsilon\) 近似。切向量換成
得到的目標記成 \(\mathcal L^\infty_{\text{CT}}(\bm\theta,\bm\theta^-)\),對應從頭訓練的設定。命題可以改寫成
$$\lim_{N\to\infty}\frac{1}{\Delta s_N}\nabla_{\bm\theta}\mathcal L^N_{\text{CT}}(\bm\theta,\bm\theta^-)=\nabla_{\bm\theta}\mathcal L^\infty_{\text{CT}}(\bm\theta,\bm\theta^-).$$為什麼連續時間的 CD 和 CT 在期望上完全相同,而離散時間只差 O(Δs²)
看 \(\mathcal L^\infty_{\text{CT}}\) 對一個固定 \(\mathbf x_s\) 的條件期望。切向量對速度是線性的,而 \(\mathbf f_{\bm\theta}(\mathbf x_s,s)\)、\(\partial_s\mathbf f_{\bm\theta^-}\)、\(\partial_{\mathbf x}\mathbf f_{\bm\theta^-}\) 都只依賴 \(\mathbf x_s\),所以
$$\mathbb E\Big[\mathbf f_{\bm\theta}^\top\big(\partial_s\mathbf f_{\bm\theta^-}+\partial_{\mathbf x}\mathbf f_{\bm\theta^-}(\alpha'_s\mathbf x_0+\sigma'_s\bm\epsilon)\big)\,\Big|\,\mathbf x_s\Big]=\mathbf f_{\bm\theta}^\top\big(\partial_s\mathbf f_{\bm\theta^-}+\partial_{\mathbf x}\mathbf f_{\bm\theta^-}\,\mathbb E[\alpha'_s\mathbf x_0+\sigma'_s\bm\epsilon\mid\mathbf x_s]\big).$$最後的條件期望正是 \(\mathbf v^*(\mathbf x_s,s)\)(B29 第 2 節)。所以只要 CD 的老師完美(\(\mathbf v_{\bm\phi^\times}=\mathbf v^*\)),\(\mathcal L^\infty_{\text{CT}}\) 和 \(\mathcal L^\infty_{\text{CD}}\) 在期望上相等,梯度也相等,只差抽樣變異數。
離散時間不同:一點估計的狀態要先經過非線性的 \(\mathbf f_{\bm\theta^-}\) 和平方距離,才會有 B29 第 11 節的 Jensen 間隙。連續極限把目標網路線性化了,這個間隙就跟著消失。這和書下面這張圖最底下那條「\(\mathcal L^\infty_{\text{CD}}=\mathcal L^\infty_{\text{CT}}\)」是同一件事。
到這裡,B29 第 8 節表格裡實現 \(\bm\Psi_{s\to0}\) 學習的四種基本做法都介紹完了。書用下面這張圖總結各種損失之間的關係,也標出每個方法是否依賴預訓練的 diffusion model,以及是連續還是離散時間的目標。
- ① → ②:\(\mathcal L_{\text{CD}}=\mathcal L_{\text{CT}}+\mathcal O(\Delta s^2)\)(B29 第 11 節的定理)
- ① → ③:\(\lim_{N\to\infty}\frac{1}{\Delta s_N}\nabla_{\bm\theta}\mathcal L^N_{\text{CD}}=\nabla_{\bm\theta}\mathcal L^\infty_{\text{CD}}\)(定理 5)
- ② → ④:\(\lim_{N\to\infty}\frac{1}{\Delta s_N}\nabla_{\bm\theta}\mathcal L^N_{\text{CT}}=\nabla_{\bm\theta}\mathcal L^\infty_{\text{CT}}\)(定理 6)
- ① → ④:\(\lim_{N\to\infty}\frac{1}{\Delta s_N}\nabla_{\bm\theta}\mathcal L^N_{\text{CD}}(\bm\theta,\bm\theta^-;\bm\phi^\times)=\nabla_{\bm\theta}\mathcal L^\infty_{\text{CT}}(\bm\theta,\bm\theta^-)\)(定理 6)
- ③ = ④:\(\mathcal L^\infty_{\text{CD}}(\bm\theta,\bm\theta^-;\bm\phi^\times)=\mathcal L^\infty_{\text{CT}}(\bm\theta,\bm\theta^-)\)
不過,切向量 \(\frac{d}{ds}\mathbf f_{\bm\theta^-}\) 在訓練時常常造成不穩定。下一節(選讀)介紹 Simplifying, Stabilizing and Scaling Continuous Time Consistency Models(sCM,Lu & Song 2024)緩解這些問題的技巧。
05sCM:讓切向量穩定(選讀)書 §11.3.3
我們關心的是從頭訓練的情境,因為它得到一個不依賴外部預訓練 diffusion model 的獨立生成模型,所以這裡專注在連續時間的情形。
實務上直接用 \(\mathcal L^\infty_{\text{CM}}\) 訓練常常不穩定:\(\frac{d}{ds}\mathbf f_{\bm\theta^-}\) 可能出現很大、甚至無界的時間導數,造成最佳化時梯度爆炸。要克服這點,通常需要合適的參數化和穩定化策略(Geng et al. 2025;Lu & Song 2024)。如 §6.2.2(B15)所總結,影響穩定訓練的主要因素是 diffusion 過程、參數化的選擇、時間權重函數和時間抽樣分佈;在連續時間 CM 裡,這幾項也都要仔細設計、分開考慮。
Diffusion 過程:三角時程
Lu & Song (2024) 不用標準的 \(\mathbf x_s=\alpha_s\mathbf x_0+\sigma_s\bm\epsilon\)(\(\bm\epsilon\sim\mathcal N(\mathbf 0,\mathbf I)\)),而用三角時程。它在數學上和原本的形式等價(B16 §6.3.3),但結構更乾淨、訓練目標裡的各項分得更開,有助於訓練的穩定。書的註腳說:直觀上,三角函數和它們的導數都有界,有助於防止像 \(\frac{d}{ds}\mathbf f_{\bm\theta^-}\) 這種項的尺度爆炸。他們也照 EDM 的設計(附錄 D.6,B15)把資料分佈 \(p_{\text{data}}\) 的標準差 \(\sigma_{\text d}\) 放進來:
這個表述完全一般。對任何 \(\mathbf x_s=\alpha_s\mathbf x_0+\sigma_s\bm\epsilon\) 形式的 diffusion 過程,都可以等價地寫成
$$\mathbf x_s=\alpha_s\mathbf x_0+\frac{\sigma_s}{\sigma_{\text d}}\cdot(\sigma_{\text d}\bm\epsilon),$$也就是定義 \(\mathbf z:=\sigma_{\text d}\bm\epsilon\)、\(\alpha'_s:=\alpha_s\)、\(\sigma'_s:=\sigma_s/\sigma_{\text d}\)(這裡的 ′ 只是新名字,不是導數)。新的一對 \((\alpha'_s,\sigma'_s)\) 再用 B16 的正規化化成三角形式 \((\cos(s),\sin(s))\):令 \(R=\sqrt{\alpha'^2+\sigma'^2}\),取角度 \(\tau\) 使 \(\cos\tau=\alpha'/R\)、\(\sin\tau=\sigma'/R\),就有 \(\mathbf x_s=R\,(\cos\tau\,\mathbf x_0+\sin\tau\,\mathbf z)\)。
三角時程下的 PF-ODE 速度與一點速度(轉述者補充)
一點速度:對 \(s\) 微分 \(\mathbf x_s=\cos(s)\mathbf x_0+\sin(s)\mathbf z\),得到 \(\frac{d\mathbf x_s}{ds}=\cos(s)\mathbf z-\sin(s)\mathbf x_0\),這就是下面演算法裡 CT 那一行。
PF-ODE 速度是它的條件期望。用 \(\mathbf z=(\mathbf x_s-\cos(s)\mathbf x_0)/\sin(s)\):
$$\mathbf v^*(\mathbf x_s,s)=\mathbb E\Big[-\sin(s)\mathbf x_0+\cos(s)\frac{\mathbf x_s-\cos(s)\mathbf x_0}{\sin(s)}\,\Big|\,\mathbf x_s\Big]=\frac{\cos(s)\,\mathbf x_s-\mathbb E[\mathbf x_0\mid\mathbf x_s]}{\sin(s)},$$其中用了 \(\sin^2+\cos^2=1\)。Demo A、B 都用這兩個式子。
參數化
依 EDM 的類似原則,Lu & Song (2024) 提出和 EDM 相似的網路參數化
$$\mathbf f_{\bm\theta}(\mathbf x,s):=c_{\text{skip}}(s)\,\mathbf x+c_{\text{out}}(s)\,\mathbf F_{\bm\theta}\big(c_{\text{in}}(s)\,\mathbf x,\,c_{\text{noise}}(s)\big),$$\(c_{\text{skip}}\)、\(c_{\text{out}}\)、\(c_{\text{in}}\) 可以用附錄 D.6 同樣的準則推出(細節見 sCM 論文附錄 B):
$$c_{\text{skip}}(s)=\cos(s),\qquad c_{\text{out}}(s)=-\sigma_{\text d}\sin(s),\qquad c_{\text{in}}(s)\equiv\frac{1}{\sigma_{\text d}}.$$搭配預設的 \(c_{\text{noise}}(s)=s\),它的導數 \(\partial_s c_{\text{noise}}(s)\) 有界,這對訓練穩定很重要(下面會看到原因)。在三角時程下,參數化變成
這個參數化也保證網路永遠滿足邊界條件 \(\mathbf f_{\bm\theta}(\mathbf x,0)\equiv\mathbf x\)(\(\cos0=1\)、\(\sin0=0\)),這是 consistency function 的基本性質。
穩定切向量訓練的技巧
在三角時程和上面的參數化下,連續時間損失的梯度變成
$$\nabla_{\bm\theta}\mathcal L^\infty_{\text{CT}}(\bm\theta,\bm\theta^-)=\nabla_{\bm\theta}\mathbb E_{s,\mathbf x_0,\bm\epsilon}\Big[-\omega(s)\,\sigma_{\text d}\sin(s)\,\mathbf F_{\bm\theta}^\top\Big(\frac{\mathbf x_s}{\sigma_{\text d}},s\Big)\cdot\frac{d\mathbf f_{\bm\theta^-}}{ds}(\mathbf x_s,s)\Big].$$(把 \(\mathbf f_{\bm\theta}\) 代進偽目標:\(\cos(s)\mathbf x_s\) 那部分和 \(\bm\theta\) 無關,梯度只剩 \(\mathbf F_{\bm\theta}\) 那一項。)理論上用這個梯度更新可能就足以學到 consistency function。但 Lu & Song (2024) 在實驗上觀察到,訓練會因為切向量的行為而不穩定:
$$\underbrace{\frac{d\mathbf f_{\bm\theta^-}(\mathbf x_s,s)}{ds}}_{\textbf{A.}}=-\cos(s)\Big(\sigma_{\text d}\mathbf F_{\bm\theta^-}\Big(\frac{\mathbf x_s}{\sigma_{\text d}},s\Big)-\frac{d\mathbf x_s}{ds}\Big)-\sin(s)\Big(\mathbf x_s+\sigma_{\text d}\frac{d\mathbf F_{\bm\theta^-}}{ds}\Big(\frac{\mathbf x_s}{\sigma_{\text d}},c_{\text{noise}}(s)\Big)\Big).$$切向量公式的推導
對 \(\mathbf f=\cos(s)\mathbf x_s-\sin(s)\sigma_{\text d}\mathbf F\) 沿軌跡全微分,\(\mathbf x_s\) 和 \(\mathbf F\) 都隨 \(s\) 變:
$$\frac{d\mathbf f}{ds}=-\sin(s)\mathbf x_s+\cos(s)\frac{d\mathbf x_s}{ds}-\cos(s)\sigma_{\text d}\mathbf F-\sin(s)\sigma_{\text d}\frac{d\mathbf F}{ds}.$$把含 \(\cos(s)\) 的兩項、含 \(\sin(s)\) 的兩項各自合併,就是上式。
其中特別不穩定的是這一項:
$$\underbrace{\sin(s)\frac{d\mathbf F_{\bm\theta^-}}{ds}\Big(\frac{\mathbf x_s}{\sigma_{\text d}},c_{\text{noise}}(s)\Big)}_{\textbf{B.}}=\sin(s)\,\nabla_{\mathbf x_s}\mathbf F_{\bm\theta^-}\frac{d\mathbf x_s}{ds}+\sin(s)\,\partial_s\mathbf F_{\bm\theta^-}.$$更具體地,不穩定來自下面這個成分:
$$\sin(s)\,\partial_s\mathbf F_{\bm\theta^-}=\sin(s)\underbrace{\frac{\partial c_{\text{noise}}(s)}{\partial s}\cdot\frac{\partial\,\mathrm{emb}(c_{\text{noise}})}{\partial c_{\text{noise}}}}_{\textbf{C.}}\cdot\frac{\partial\mathbf F_{\bm\theta^-}}{\partial\,\mathrm{emb}(c_{\text{noise}})}.$$這裡照 diffusion model 和 CM 文獻的常見做法,對時間變數 \(c_{\text{noise}}(s)\) 套用位置嵌入或 Fourier 嵌入,記成 \(\mathrm{emb}(\cdot)\):
$$s\mapsto c_{\text{noise}}(s)\mapsto\mathrm{emb}\big(c_{\text{noise}}(s)\big)\mapsto\mathbf F_{\bm\theta^-}\Big(\frac{\mathbf x_s}{\sigma_{\text d}},\mathrm{emb}\big(c_{\text{noise}}(s)\big)\Big).$$所以引入幾個額外的經驗技巧來緩解不穩定(字母對應上面的 A、B、C):
- A. 切向量正規化。明確地把 \(\frac{d}{ds}\mathbf f_{\bm\theta^-}\) 換成 \(\frac{d\mathbf f_{\bm\theta^-}/ds}{\|d\mathbf f_{\bm\theta^-}/ds\|_2+c}\),\(c>0\) 是依經驗設的常數。另一個選擇是把切向量截在 \([-1,1]\),也能有效限制它的變異數。
- B. 切向量 warm-up。因為 \(\sin(s)\big(\mathbf x_s+\sigma_{\text d}\frac{d}{ds}\mathbf F_{\bm\theta^-}\big)\) 可能造成不穩定,可以選用一個技巧:把係數 \(\sin(s)\) 換成 \(r\cdot\sin(s)\),\(r\) 在訓練的頭幾次迭代從 0 線性增加到 1。
- C. 時間嵌入。依上面的導數連鎖,Lu & Song (2024) 選用較小幅度的參數來控制 \(\frac{\partial\,\mathrm{emb}(c_{\text{noise}})}{\partial c_{\text{noise}}}\)。同樣的理由,選 \(c_{\text{noise}}(s)=s\),使 \(\partial_s c_{\text{noise}}(s)=1\) 是有界的常數。
除此之外,通常還需要改架構以改善正規化(為了穩定),以及用以 JVP(Jacobian–向量乘積)為基礎的高效方法計算 \(\frac{d}{ds}\mathbf f_{\bm\theta^-}\),但這些超出本書範圍。
sCM 論文裡這三項的具體做法(Lu & Song 2024)
- \(c_{\text{noise}}\) 的選擇。多數既有的 CM 用 EDM 的表述,翻成三角時程後時間轉換變成 \(c_{\text{noise}}(s)\propto\log(\sigma_{\text d}\tan s)\)。論文指出這時 \(\sin(s)\cdot\partial_s c_{\text{noise}}(s)=1/\cos(s)\),在 \(s\to\pi/2\) 時爆掉,所以改用 \(c_{\text{noise}}(s)=s\)。
- 嵌入的頻率。對 \(\mathrm{emb}(c)=\sin(\text{scale}\cdot2\pi\omega c+\phi)\) 這種嵌入,導數是 \(\text{scale}\cdot2\pi\omega\cos(\cdots)\);Fourier scale 越大,導數越大、振盪越劇烈,不穩定越嚴重。他們改用位置嵌入,相當於 Fourier scale 約 0.02(EDM 常用的是 16)。
- 常數。正規化用 \(c=0.1\);warm-up 是前 1 萬次迭代。論文的消融顯示正規化或截斷都帶來明顯改善。
Demo B 把「\(c_{\text{noise}}\)」「Fourier scale」「正規化」三個開關放在一維的例子上。
06sCM 的權重、時間分佈與完整演算法書 §11.3.3
時間權重函數
手動設計時間權重 \(\omega(s)\) 可能得到次佳的表現。為此,Lu & Song (2024) 仿照 EDM-2(Karras et al. 2024)的做法,學一個可調適的權重函數 \(\omega_{\bm\varphi}(s)\),平衡不同時間 \(s\) 的訓練損失變異數。
進一步說,第 5 節的梯度有 \(\mathbb E_{s,\mathbf x_0,\bm\epsilon}[\mathbf F_{\bm\theta}^\top\mathbf y]\) 的形式,其中 \(\mathbf y=-\omega(s)\sigma_{\text d}\sin(s)\frac{d\mathbf f_{\bm\theta^-}}{ds}\)。因為 \(\mathbf y\) 是和 \(\bm\theta\) 無關的向量,它等價於
$$\nabla_{\bm\theta}\mathbb E_{s,\mathbf x_0,\bm\epsilon}\big[\mathbf F_{\bm\theta}^\top\mathbf y\big]=\frac12\nabla_{\bm\theta}\mathbb E_{s,\mathbf x_0,\bm\epsilon}\big\|\mathbf F_{\bm\theta}-\mathbf F_{\bm\theta^-}+\mathbf y\big\|_2^2.$$為什麼兩者等價(在 \(\bm\theta=\bm\theta^-\) 處)
右邊的梯度是 \(\mathbb E\big[(\nabla_{\bm\theta}\mathbf F_{\bm\theta})^\top(\mathbf F_{\bm\theta}-\mathbf F_{\bm\theta^-}+\mathbf y)\big]\)。在 \(\bm\theta=\bm\theta^-\)(數值相同,只是後者不求梯度)時 \(\mathbf F_{\bm\theta}-\mathbf F_{\bm\theta^-}=\mathbf 0\),剩下 \(\mathbb E[(\nabla_{\bm\theta}\mathbf F_{\bm\theta})^\top\mathbf y]\),正是左邊。好處是右邊是一個真正的平方損失,有「大小」可以拿來調權重。
基於這個觀察,Lu & Song (2024) 另外訓練一個可調適的權重網路 \(\omega_{\bm\varphi}(s)\) 去估計損失的大小,寫成下面的最小化問題(\(D\) 是資料維度):
$$\min_{\bm\varphi}\ \mathbb E_{s,\mathbf x_0,\bm\epsilon}\Big[\frac{e^{\omega_{\bm\varphi}(s)}}{D}\big\|\mathbf F_{\bm\theta}-\mathbf F_{\bm\theta^-}+\mathbf y\big\|_2^2-\omega_{\bm\varphi}(s)\Big].$$為了看出調適權重的效果,對 \(\omega_{\bm\varphi}\) 取偏導數,最佳解 \(\omega^*(s)\) 滿足
$$\mathbb E_{\mathbf x_0,\bm\epsilon}\Big[\frac{e^{\omega^*(s)}}{D}\big\|\mathbf F_{\bm\theta}-\mathbf F_{\bm\theta^-}+\mathbf y\big\|_2^2\Big]=1,\qquad\text{對幾乎每個 }s.$$也就是說,對一個不受限制的逐點權重函數,重新縮放後的期望損失在每個時間 \(s\) 被各自正規化成 1。結果,調適權重有效降低了不同時間步之間訓練損失的變異數,訓練更平衡、更穩定。
最佳 \(\omega^*\) 的一行推導
固定 \(s\),記 \(\ell(s):=\mathbb E_{\mathbf x_0,\bm\epsilon}\|\mathbf F_{\bm\theta}-\mathbf F_{\bm\theta^-}+\mathbf y\|_2^2/D\)。目標對 \(\omega\) 是 \(e^{\omega}\ell-\omega\),導數 \(e^{\omega}\ell-1=0\),所以 \(e^{\omega^*}=1/\ell\):權重正好是那個時間損失大小的倒數。(二階導數 \(e^\omega\ell>0\),是最小值。)
時間抽樣分佈
Lu & Song (2024) 從 log-normal 提議分佈(Karras et al. 2022)抽 \(\tan(s)\):
$$\log\big(\sigma_{\text d}\tan(s)\big)\sim\mathcal N\big(\cdot;P_{\text{mean}},P_{\text{std}}^2\big),$$\(P_{\text{mean}}\)、\(P_{\text{std}}\) 是兩個超參數。照 Lu & Song (2024),可以用先驗權重
$$\omega(s)=\frac{1}{\sigma_{\text d}\tan(s)},\qquad\text{於是}\qquad-\omega(s)\,\sigma_{\text d}\sin(s)\frac{d\mathbf f_{\bm\theta^-}}{ds}=-\cos(s)\frac{d\mathbf f_{\bm\theta^-}}{ds}.$$轉述者註:\(\sigma_{\text d}\tan(s)\) 正是 EDM 的雜訊尺度 \(\sigma/\alpha\)(用 B16 的換算)。所以這個抽樣分佈就是 EDM 對 \(\log\sigma\) 的常態分佈,搬到三角時間上。
訓練目標的總結
綜合以上討論,最後的訓練損失是
\(s\) 照上面的分佈抽,\(\mathbf x_s\) 用三角時程算。用這個損失訓練的模型叫 sCM,訓練流程如下。
初始化:\(\bm\theta\leftarrow\bm\theta_{\text{pretrain}}\),Iters \(\leftarrow0\)。
重複直到收斂:
\(\mathbf x_0\sim\mathcal D\)、\(\mathbf z\sim\mathcal N(\mathbf 0,\sigma_{\text d}^2\mathbf I)\)、\(\tau\sim\mathcal N(P_{\text{mean}},P_{\text{std}}^2)\)、\(s\leftarrow\arctan\big(e^\tau/\sigma_{\text d}\big)\);
\(\mathbf x_s\leftarrow\cos(s)\mathbf x_0+\sin(s)\mathbf z\);
若 consistency training:\(\frac{d\mathbf x_s}{ds}\leftarrow\cos(s)\mathbf z-\sin(s)\mathbf x_0\);否則:\(\frac{d\mathbf x_s}{ds}\leftarrow\sigma_{\text d}\mathbf F_{\text{pretrain}}\big(\frac{\mathbf x_s}{\sigma_{\text d}},s\big)\);
\(r\leftarrow\min(1,\text{Iters}/H)\) (切向量 warm-up)
\(\mathbf w\leftarrow-\cos^2(s)\big(\sigma_{\text d}\mathbf F_{\bm\theta^-}-\frac{d\mathbf x_s}{ds}\big)-r\cos(s)\sin(s)\big(\mathbf x_s+\sigma_{\text d}\frac{d\mathbf F_{\bm\theta^-}}{ds}\big)\);
\(\mathbf w\leftarrow\mathbf w/(\|\mathbf w\|+c)\) (切向量正規化)
\(\mathcal L_{\text{sCM}}(\bm\theta,\bm\varphi)\leftarrow\frac{e^{\omega_{\bm\varphi}(s)}}{D}\big\|\mathbf F_{\bm\theta}\big(\frac{\mathbf x_s}{\sigma_{\text d}},s\big)-\mathbf F_{\bm\theta^-}\big(\frac{\mathbf x_s}{\sigma_{\text d}},s\big)-\mathbf w\big\|_2^2-\omega_{\bm\varphi}(s)\) (調適權重)
\((\bm\theta,\bm\varphi)\leftarrow(\bm\theta,\bm\varphi)-\eta\nabla_{\bm\theta,\bm\varphi}\mathcal L_{\text{sCM}}\);Iters \(\leftarrow\) Iters + 1。
\(\mathbf w\) 就是 \(\cos(s)\frac{d\mathbf f_{\bm\theta^-}}{ds}\)(把上一節的切向量公式乘上 \(\cos(s)\),第二項再乘 warm-up 的 \(r\))。
sCM 的結果(Lu & Song 2024)
只用兩步取樣,sCM 在 CIFAR-10 上 FID 2.06、ImageNet 64×64 上 1.48、ImageNet 512×512 上 1.88(模型到 1.5B 參數),和當時最好的 diffusion model 的 FID 差距在 10% 以內。前兩個數字是 sCT(consistency training)的兩步結果;CIFAR-10 的 sCT 一步是 2.85。
Demo B切向量什麼時候會爆轉述者補充
一維、三角時程、\(\sigma_{\text d}=1.25\)。網路是 \(f_{\bm\theta}=\cos(s)x-\sin(s)\sigma_{\text d}F_{\bm\theta}\),\(F\) 的輸入是 \(x/\sigma_{\text d}\) 和 \(c_{\text{noise}}(s)\) 的 8 個 Fourier 特徵 \(\sin(\text{scale}\cdot2\pi\omega_kc+\phi_k)\)(\(\omega_k\sim\mathcal N(0,1)\)、\(\phi_k\) 均勻,固定種子),後面接 32→32→1 的 tanh MLP。用的是連續時間 CT:切向量的速度用一點估計,損失是 \(\|F_{\bm\theta}-F_{\bm\theta^-}-\mathbf w\|^2\),\(\mathbf w=\cos(s)\frac{df^-}{ds}\)(權重 \(\omega=1/(\sigma_{\text d}\tan s)\))。\(\log(\sigma_{\text d}\tan s)\sim\mathcal N(0,1.5^2)\),\(s\) 最大到 \(\arctan(20/\sigma_{\text d})\)(雜訊尺度 20)。6,000 次更新、批次 64、Adam \(10^{-3}\)(最後 30% 乘 0.3),評估用參數的滑動平均(0.995),起點是 \(p_{s_{\max}}\) 的 2,000 個分層分位數。沒有 warm-up,也沒有可學的權重。
瀏覽器實測(固定種子,同一個瀏覽器重跑結果一樣)。除了「scale 16、正規化」這一組,其他都和 Node 原型逐位相同;那一組的訓練本身是混亂的,浮點運算最後一位的差別就會被放大(Node 得到 2.099 / 1.239),結論不變。一步/兩步 \(W_1\)、訓練中 \(|df/ds|\) 的最大值、批次梯度範數超過 20 的次數:
| Fourier scale | c_noise | 正規化 | 一步/兩步 | max |df/ds| | 梯度 > 20 |
|---|---|---|---|---|---|
| 0.02 | s | 不用 | 0.117 / 0.094 | 16.9 | 0 |
| 0.02 | s | 用 | 0.231 / 0.219 | 22.9 | 0 |
| 0.02 | log | 不用 | 0.103 / 0.105 | 19.3 | 0 |
| 0.02 | log | 用 | 0.181 / 0.150 | 32.3 | 0 |
| 16 | s | 不用 | 1.044 / 0.583 | 598.8 | 5,892 |
| 16 | s | 用 | 2.302 / 1.306 | 395.0 | 0 |
| 16 | log | 不用 | 1.738 / 3.600 | 10,874 | 5,984 |
- 決定成敗的是嵌入的頻率。Fourier scale 16 時,\(|df/ds|\) 衝到 600(配上 log 轉換更到 1 萬以上),6,000 次更新裡幾乎每一次的梯度範數都超過 20,模型學不起來(\(W_1\) 1.0 以上)。scale 0.02 時切向量最大不到 35,訓練順利。這正是書的 C 項:\(\partial\,\mathrm{emb}/\partial c\) 跟著 scale 放大。對照:用同樣的 scale 16 嵌入訓練一個普通的 denoiser(不需要切向量),和精確 denoiser 的均方根差是 0.181,scale 0.02 是 0.123,差不多;所以問題出在切向量,不是嵌入本身學不動。
- 正規化壓住了梯度,但救不了壞的嵌入。scale 16 加上正規化,梯度範數最大只有 2,但切向量的方向本身就被高頻雜訊主導,\(W_1\) 反而更差(2.30)。
- 一維時正規化反而有代價。scale 0.02 時,加正規化讓 \(W_1\) 從 0.117 變成 0.231。一維的 \(\mathbf w/(|\mathbf w|+0.1)\) 幾乎就是 \(\mathbf w\) 的正負號,丟掉了大小的資訊;高維時一個向量的方向本身還帶著大量資訊,sCM 論文在影像上看到的是改善。這是玩具例子的限制,不代表正規化沒用。
- 這裡 log 轉換沒有出事,因為 \(s\) 最大只到 \(\arctan(16)\),\(1/\cos s\) 最大約 16。sCM 論文指出的爆炸發生在 \(s\to\pi/2\)。
07CTM 的設定書 §11.4
Consistency Trajectory Model(CTM,Kim et al. 2023)是最早學一般 flow map \(\bm\Psi_{s\to t}\) 的方法之一。
實務上的設定。和 CM 家族一樣,CTM 原本照 EDM 的表述(附錄 D.6),用 \(\mathbf x\) 預測形式的 PF-ODE,時程 \(\alpha_t=1\)、\(\sigma_t=t\)。在這個設定下 PF-ODE 是
$$\frac{d\mathbf x(\tau)}{d\tau}=\frac{\mathbf x(\tau)-\mathbb E[\mathbf x\mid\mathbf x(\tau)]}{\tau}.$$從時間 \(s\) 的 \(\mathbf x_s\) 出發、往回演化到結束時間 \(t\le s\),對應的 flow map(解)可以等價地寫成
$$\mathbf x_s+\int_s^t\frac{\mathbf x_\tau-\mathbb E[\mathbf x\mid\mathbf x_\tau]}{\tau}\,d\tau.$$CTM 採用受 Euler 啟發的參數化:對 PF-ODE 用一步 Euler 解法得到
$$\mathbf x^{\text{Euler}}_{s\to t}=\mathbf x_s-(s-t)\frac{\mathbf x_s-\mathbb E[\mathbf x\mid\mathbf x_s]}{s}=\frac ts\,\mathbf x_s+\Big(1-\frac ts\Big)\mathbb E[\mathbf x\mid\mathbf x_s],$$\(\mathbf x^{\text{Euler}}_{s\to t}\) 近似給定時間 \(s\) 的 \(\mathbf x_s\) 在時間 \(t\) 的解。書的註腳:對時間的仿射時程,例如 \((\alpha_t,\sigma_t)=(1,t)\) 或 \((1-t,t)\),在 diffusion 時間上的普通 Euler 步和確定性 DDIM 更新完全相同;一般的時程下兩者只在一階一致(§9.2.2,B25)。
EDM 的設定提供一個簡單的示範例子,但 CTM 允許由任意線性高斯正向核 \((\alpha_t,\sigma_t)\) 定義的更廣的時程,並用 \(\mathbf v\) 預測形式寫 PF-ODE:
$$\bm\Psi_{s\to t}(\mathbf x_s)=\mathbf x_s+\int_s^t\mathbf v^*(\mathbf x_u,u)\,du.$$下面的討論專注在這個一般的表述。
08CTM 的參數化書 §11.4.1
照上面的一步 Euler,CTM 把 oracle flow map 改寫成輸入 \(\mathbf x_s\) 和一個殘差函數 \(\mathbf g^*\) 的凸組合:
$$\bm\Psi_{s\to t}(\mathbf x_s):=\mathbf x_s+\int_s^t\mathbf v^*(\mathbf x_u,u)\,du=\frac ts\,\mathbf x_s+\frac{s-t}{s}\underbrace{\Big[\mathbf x_s+\frac{s}{s-t}\int_s^t\mathbf v^*(\mathbf x_u,u)\,du\Big]}_{=:\ \mathbf g^*},$$殘差項定義為
$$\mathbf g^*(\mathbf x_s,s,t):=\mathbf x_s+\frac{s}{s-t}\int_s^t\mathbf v^*(\mathbf x_u,u)\,du.$$(\(0\le t\le s\) 時兩個係數 \(\frac ts\)、\(\frac{s-t}{s}\) 都非負、加起來是 1,所以是凸組合。)這引出神經網路的參數化
\(\mathbf g_{\bm\theta}\) 是一個神經網路,目標是 \(\mathbf g_{\bm\theta}\approx\mathbf g^*\),因此 \(\mathbf G_{\bm\theta}(\mathbf x_s,s,t)\) 被訓練去近似 oracle flow map:\(\mathbf G_{\bm\theta}(\mathbf x_s,s,t)\approx\bm\Psi_{s\to t}(\mathbf x_s)\)。所以 CTM 自然地放進 B29 的一般 flow map 框架 \(\mathcal L_{\text{oracle}}\)。此外,這個表述天生滿足初始條件
$$\mathbf G_{\bm\theta}(\mathbf x_s,s,s)=\mathbf x_s,$$訓練時不需要另外強制。
CTM 參數化的優點
當 \(t\) 趨近 \(s\)(結束時間等於開始時間)時,\(\mathbf g^*\) 的一個關鍵特性就顯現出來:
(ii) 積分表示:\(\mathbf g^*(\mathbf x_s,s,t)=\mathbf x_s-s\,\mathbf v^*(\mathbf x_s,s)+\mathcal O(|t-s|)\)。
證明(書的正文,逐步展開)
(i) 由定義,
$$\lim_{t\to s}\mathbf g^*(\mathbf x_s,s,t)=\mathbf x_s-s\lim_{t\to s}\frac{1}{t-s}\int_s^t\mathbf v^*(\mathbf x_\tau,\tau)\,d\tau=\mathbf x_s-s\,\mathbf v^*(\mathbf x_s,s).$$(\(\frac{s}{s-t}=-\frac{s}{t-s}\);而 \(\frac{1}{t-s}\int_s^t\) 是區間上的平均,\(t\to s\) 時趨近端點值。)
(ii) 把積分方向翻過來再做 Taylor 展開:
$$\mathbf g^*(\mathbf x_s,s,t)=\mathbf x_s-\frac{s}{s-t}\int_t^s\mathbf v^*(\mathbf x_\tau,\tau)\,d\tau=\mathbf x_s-\frac{s}{s-t}\Big[(s-t)\,\mathbf v^*(\mathbf x_s,s)+\mathcal O\big((t-s)^2\big)\Big]=\mathbf x_s-s\,\mathbf v^*(\mathbf x_s,s)+\mathcal O(|t-s|).$$由這個命題可以得到:
- 估計 \(\mathbf g^*\) 不只能近似有限的 \(s\) 到 \(t\) 轉移(\(s\ge t\)),也能近似由瞬時速度 \(\mathbf v^*\) 刻畫的無窮小 \(s\) 到 \(s\) 轉移。
- \(\mathbf g^*(\mathbf x_s,s,t)\) 可以解讀成一個像 denoiser 的量,加上 Taylor 展開的殘差項。
所以,用 CTM 的參數化,對 \(t\lt s\) 學 \(\mathbf G_{\bm\theta}\approx\bm\Psi_{s\to t}\),扣掉非零因子 \((s-t)/s\) 後,就是學 \(\mathbf g_{\bm\theta}\approx\mathbf g^*\),透過 \(\mathbf G_{\bm\theta}\) 得到長跳的能力。而且 \(\mathbf g^*\) 的對角線值透過
$$\mathbf v^*(\mathbf x_s,s)=\frac{\mathbf x_s-\mathbf g^*(\mathbf x_s,s,s)}{s}$$編碼了 diffusion model 的瞬時速度,可以直接用下面介紹的 diffusion model 損失監督。因此,CTM 的參數化在單一框架裡同時學有限時間的轉移和局部的 diffusion 動態,結合了 flow map 模型的長跳能力和 diffusion model 對瞬時動態的存取。
在 EDM 設定下,對角線就是 denoiser(轉述者補充)
\(\alpha=1,\sigma=t\) 時 \(\mathbf v^*(\mathbf x_s,s)=(\mathbf x_s-\mathbb E[\mathbf x_0\mid\mathbf x_s])/s\),代進 (i):\(\mathbf g^*(\mathbf x_s,s,s)=\mathbf x_s-(\mathbf x_s-\mathbb E[\mathbf x_0\mid\mathbf x_s])=\mathbb E[\mathbf x_0\mid\mathbf x_s]\)。所以「像 denoiser 的量」在這個設定下就是 denoiser 本身,而 \(\mathbf G\) 在 \(t\) 很接近 \(s\) 時就是上一節的一步 Euler。Demo C 的網路就照這個設定:\(\mathbf g_{\bm\theta}\) 用 EDM 的 \(c_{\text{skip}}\)、\(c_{\text{out}}\) 包起來,對角線用 \(\mathbf x\) 預測的損失監督。
接下來兩節先介紹 CTM 的一致性損失(第 9 節),它同時支援蒸餾和從頭訓練,並強制半群性質以達成 \(\mathbf G_{\bm\theta}(\cdot,s,t)\approx\bm\Psi_{s\to t}(\cdot)\)。然後介紹由參數化自然產生的輔助損失(第 10 節),包括 diffusion model 損失和 GAN 損失,它們能大幅改善 CTM 的表現。
09CTM 的一致性損失書 §11.4.2
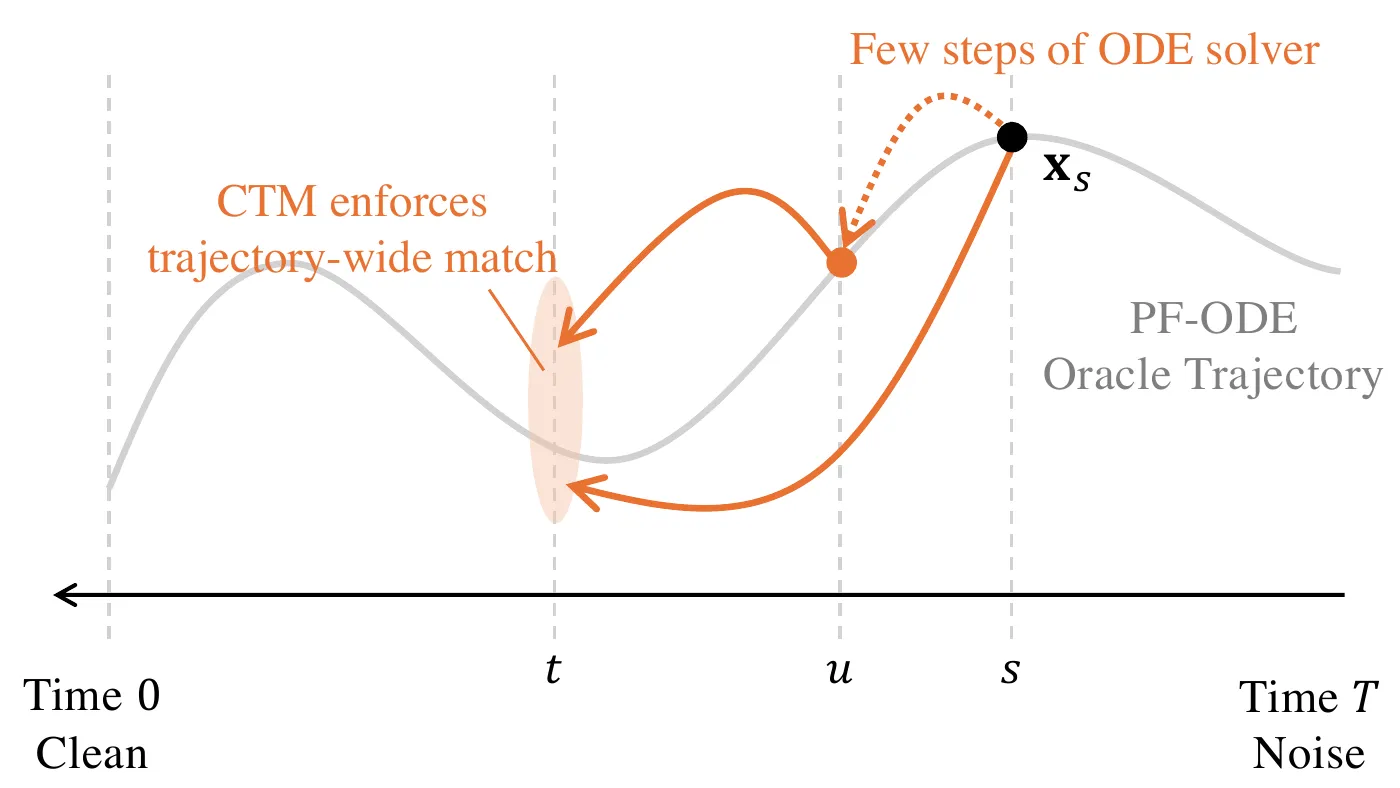
CTM 要對任何 \(s\ge t\) 近似 oracle 解映射 \(\mathbf G_{\bm\theta}(\cdot,s,t)\approx\bm\Psi_{s\to t}(\cdot)\)。因為 oracle 的 \(\bm\Psi_{s\to t}\) 通常沒有閉式,CTM 強制半群性質來建立可行的回歸目標:對任何 \(s\ge u\ge t\),
$$\bm\Psi_{u\to t}\circ\bm\Psi_{s\to u}=\bm\Psi_{s\to t}.$$依是否有預訓練的 diffusion model,\(\bm\Psi_{s\to t}\) 可以用不同方式近似。以下都假設 \(s\ge u\ge t\in[0,T]\)。
透過蒸餾訓練
假設有預訓練的 diffusion model 給出 \(\mathbf v_{\bm\phi^\times}(\mathbf x_s,s)\approx\mathbf v^*(\mathbf x_s,s)\),PF-ODE 就近似成經驗動態
$$\frac{d\mathbf x(\tau)}{d\tau}=\mathbf v_{\bm\phi^\times}(\mathbf x_\tau,\tau).$$CTM 訓練 \(\mathbf G_{\bm\theta}\) 去匹配套在這個經驗 ODE 上的數值解法 \(\mathtt{Solver}_{s\to t}(\mathbf x_s;\bm\phi^\times)\),它是 oracle 的一個可計算替身:
$$\mathbf G_{\bm\theta}(\mathbf x_s,s,t)\approx\mathtt{Solver}_{s\to t}(\mathbf x_s;\bm\phi^\times)\approx\bm\Psi_{s\to t}(\mathbf x_s).$$老師夠強時,解法可以把 \(\bm\Psi_{s\to t}\) 還原到只剩離散化誤差,所以最佳的學生會很接近真值(Kim et al. 2023 的 Proposition 3、4)。
不過,當 \(s\) 和 \(t\) 相距很遠,在訓練迴圈裡解完整個 \([t,s]\) 區間會很貴。為了提高效率、提供更平滑的訊號,CTM 引入 soft consistency matching,把半群性質落實成損失。如上圖,CTM 在時間 \(t\) 比較兩個預測:直接的學生輸出 \(\mathbf G_{\bm\theta}(\mathbf x_s,s,t)\),以及一條老師與學生混合的路徑:先讓老師從 \(s\) 走到隨機的 \(u\sim\mathcal U[t,s)\),再讓學生從 \(u\) 跳到 \(t\):
$$\mathbf G_{\bm\theta^-}\big(\mathtt{Solver}_{s\to u}(\mathbf x_s;\bm\phi^\times),u,t\big).$$學生被訓練去匹配這個合成的預測:
\(\bm\theta^-\) 是 \(\mathbf G_{\bm\theta}\) 的 stop-gradient 副本。改變 \(u\),CTM 就在全域和局部的監督之間內插:
- 全域一致性(\(u=t\)):老師解完整個 \(s\to t\) 區間,目標就是老師在時間 \(t\) 的完整轉移。
- 局部一致性(\(u=s-\Delta s\)):學生從 \(s\) 附近的一小步老師學;\(t=0\) 時就化成 consistency distillation。
為了在對齊軌跡的同時加強樣本品質,兩個預測都用 stop-gradient 的學生送到時間 0,再用一個特徵空間的度量 \(d\) 比較:
$$\begin{aligned}\mathbf x_{\text{est}}(\mathbf x_s,s,t)&:=\mathbf G_{\bm\theta^-}\big(\mathbf G_{\bm\theta}(\mathbf x_s,s,t),\,t,\,0\big),\\\mathbf x_{\text{target}}(\mathbf x_s,s,u,t)&:=\mathbf G_{\bm\theta^-}\big(\mathbf G_{\bm\theta^-}(\mathtt{Solver}_{s\to u}(\mathbf x_s;\bm\phi^\times),u,t),\,t,\,0\big).\end{aligned}$$CTM 的一致性損失是
它鼓勵學生匹配經驗 PF-ODE 的解,同時保持生成品質。
送到時間 0 再比較:梯度怎麼走(轉述者補充)
\(\mathbf x_{\text{est}}\) 外層的 \(\mathbf G_{\bm\theta^-}(\cdot,t,0)\) 用的是 stop-gradient 參數,但它的輸入 \(\mathbf G_{\bm\theta}(\mathbf x_s,s,t)\) 依賴 \(\bm\theta\)。所以梯度會穿過這一層(乘上它對輸入的 Jacobian)回到學生,只是不更新這一層本身的參數。這樣比較的是「兩條路最後會生成哪一張圖」,所以 \(d\) 可以用 LPIPS 這類感知距離。Demo C 在一維用平方距離,並照這個方式穿過一層 stop-gradient 網路回傳梯度。
從頭訓練
利用 CTM 的特殊參數化(Proposition (i)),
$$\mathbf g^*(\mathbf x_\tau,\tau,\tau)=\mathbf x_\tau-\tau\,\mathbf v^*(\mathbf x_\tau,\tau)\quad\Longrightarrow\quad\mathbf v^*(\mathbf x_\tau,\tau)=\frac{\mathbf x_\tau-\mathbf g^*(\mathbf x_\tau,\tau,\tau)}{\tau}.$$因此可以把 oracle 的殘差函數 \(\mathbf g^*(\cdot,\tau,\tau)\) 換成 CTM 自己的估計 \(\mathbf g_{\bm\theta^-}(\cdot,\tau,\tau)\)(\(\tau\in(0,T]\)),得到一個自己誘導的經驗 PF-ODE:
然後解這個自我誘導的 ODE 來構造可計算的轉移目標:\(\mathbf G_{\bm\theta}(\mathbf x_s,s,t)\approx\mathtt{Solver}_{s\to t}(\mathbf x_s;\bm\theta^-)\)。這個目標只有在對角線估計 \(\mathbf g_{\bm\theta^-}(\cdot,\tau,\tau)\) 正確還原目標的局部動態時,才會接近 oracle flow map;下面的 diffusion model 損失直接監督這個局部的量。
和蒸餾的情形一樣,\(s\) 和 \(t\) 相距很遠時,對整個 \([t,s]\) 積分很貴,所以 CTM 強制半群性質,得到較短的監督路徑:
$$\underbrace{\mathbf G_{\bm\theta}(\mathbf x_s,s,t)}_{\approx\ \bm\Psi_{s\to t}(\mathbf x_s)}\approx\underbrace{\mathbf G_{\bm\theta^-}\big(\mathtt{Solver}_{s\to u}(\mathbf x_s;\bm\theta^-),u,t\big)}_{\approx\ \bm\Psi_{u\to t}(\bm\Psi_{s\to u}(\mathbf x_s))},$$\(u\sim\mathcal U[t,s)\),\(\bm\theta^-\) 是學生的 stop-gradient 副本。和蒸餾唯一的差別是外部的老師 \(\mathbf v_{\bm\phi^\times}\) 換成自己誘導的老師 \(\mathbf g_{\bm\theta^-}\)。
為了把軌跡匹配和樣本品質綁在一起,兩個預測一樣用 stop-gradient 的學生送到時間 0,在特徵空間比較。不需要任何預訓練模型的目標是
$$\hat{\mathbf x}_{\text{target}}:=\mathbf G_{\bm\theta^-}\big(\mathbf G_{\bm\theta^-}(\mathtt{Solver}_{s\to u}(\mathbf x_s;\bm\theta^-),u,t),\,t,\,0\big),$$它取代上面損失裡的 \(\mathbf x_{\text{target}}\),得到
概念上這是 CTM 內部的自我蒸餾:模型自己提供短距離的老師訊號,學生學完整的轉移。
10輔助損失:DM 與 GAN書 §11.4.3
(自我)蒸餾可能表現不如老師,因為它只最佳化老師產生的目標,缺少來自真實資料的直接監督。相比之下,CTM 可以自然地加入以資料驅動的正則項,例如在目標裡加上 denoising score matching 和對抗式(GAN)項(Goodfellow et al. 2014),更好地學 flow map。
自然整合 diffusion 損失
diffusion model 損失(更精確地說是 conditional flow matching 損失,§5.2,B12)自然地整合進 CTM,並提供一個固定的回歸目標,幫助學 flow map 模型。要看出這點,注意
$$\mathbf v^*(\mathbf x_s,s)=\frac{\mathbf x_s-\mathbf g^*(\mathbf x_s,s,s)}{s},\qquad\mathbf g^*(\mathbf x_s,s,s)\approx\mathbf g_{\bm\theta}(\mathbf x_s,s,s).$$這自然地透過 \(\mathbf g_{\bm\theta}\) 誘導出一個速度的參數化:
$$\mathbf v_{\bm\theta}(\mathbf x_s,s):=\frac1s\big(\mathbf x_s-\mathbf g_{\bm\theta}(\mathbf x_s,s,s)\big).$$用線性高斯路徑 \(\mathbf x_s=\alpha_s\mathbf x_0+\sigma_s\bm\epsilon\)(\(\mathbf x_0\sim p_{\text{data}}\)、\(\bm\epsilon\sim\mathcal N(\mathbf 0,\mathbf I)\)),diffusion model 損失可以寫成
\(t\) 接近 \(s\) 時,\(\mathcal L_{\text{DM}}\) 明確監督沿軌跡的小跳,改善準確度。在這個區域,參數化裡的因子 \(1-\frac ts\) 趨近 0,可能讓梯度變弱、學得慢;\(\mathcal L_{\text{DM}}\) 提供更強的局部訊號,穩定訓練。
概念上,一致性損失強制軌跡匹配(零階),\(\mathcal L_{\text{DM}}\) 強制斜率匹配(一階)。
EDM 設定下,\(\mathcal L_{\text{DM}}\) 就是 \(\mathbf x\) 預測的去噪損失
\(\alpha=1,\sigma_s=s\) 時一點速度是 \(\alpha'_s\mathbf x_0+\sigma'_s\bm\epsilon=\bm\epsilon\),而 \(\mathbf x_s-s\bm\epsilon=\mathbf x_0\)。所以
$$\mathbf v_{\bm\theta}-\bm\epsilon=\frac{\mathbf x_s-\mathbf g_{\bm\theta}(\mathbf x_s,s,s)}{s}-\bm\epsilon=\frac{\mathbf x_0-\mathbf g_{\bm\theta}(\mathbf x_s,s,s)}{s}.$$取 \(w(s)=s^2\),\(\mathcal L_{\text{DM}}=\mathbb E\|\mathbf g_{\bm\theta}(\mathbf x_s,s,s)-\mathbf x_0\|^2\),正是 \(\mathbf x\) 預測的 DSM;最小解是 \(\mathbb E[\mathbf x_0\mid\mathbf x_s]\),和第 8 節的補充一致。Demo C 用的就是這個形式。
GAN 損失(選讀)
一致性損失和 diffusion model 損失提供強的回歸訊號,但可能產生過度平滑的輸出。所以 CTM 可以選擇加一個對抗項,讓生成器的分佈對齊資料分佈,得到更銳利、更真實的樣本。用一個判別器 \(D_{\bm\zeta}\) 分辨真的 \(\mathbf x_0\sim p_{\text{data}}\) 和生成的 \(\mathbf x_{\text{est}}(\mathbf x_s,s,t)\),目標是
$$\mathcal L_{\text{GAN}}(\bm\theta,\bm\zeta):=\mathbb E_{\mathbf x_0}\big[\log D_{\bm\zeta}(\mathbf x_0)\big]+\mathbb E_{s\in[0,T]}\,\mathbb E_{t\in[0,s]}\,\mathbb E_{\mathbf x_0}\,\mathbb E_{\mathbf x_s\mid\mathbf x_0}\Big[\log\big(1-D_{\bm\zeta}(\mathbf x_{\text{est}}(\mathbf x_s,s,t))\big)\Big],$$\(D_{\bm\zeta}\) 要最大化它,\(\mathbf G_{\bm\theta}\) 要最小化它。直觀上,判別器像一個會調適的感知距離,鼓勵真實的細節。理論上,GAN 項推動 \(p_{\text{data}}\) 和 \(\mathbf G_{\bm\theta}\) 誘導的模型分佈之間的分佈匹配(Jensen–Shannon divergence,CS236 第 9 講),可以把品質推到超過老師。
CTM 的整體目標
總結,CTM 把(自我)蒸餾、diffusion 和 GAN 損失統一進一個訓練框架:
老師可以是外部的預訓練模型 \(\bm\phi^\times\),也可以是自己誘導的老師 \(\bm\theta^-\)。回歸式的 \(\mathcal L_{\text{consist}}\) 和 \(\mathcal L_{\text{DM}}\) 是強的正則項,選用的 GAN 項則在不犧牲穩定性的前提下改善細部(Kim et al. 2024)。
CTM 論文的結果(Kim et al. 2023)
CIFAR-10 一步生成:以預訓練 diffusion model 為老師時 FID 1.98(無條件)、1.73(有條件);兩步 1.87、1.63。不用預訓練模型直接訓練時,一步 FID 2.39,對照同一張表裡 CT 的 8.70。ImageNet 64×64 一步 1.92。論文的訓練包含 DSM 和 GAN 項(GAN 在 CIFAR-10 上從第 5 萬次迭代才打開,不用預訓練模型時從第 20 萬次)。
11γ 取樣書 §11.4.4
CTM 學的是任何 \(s\gt t\) 的一般 flow map \(\bm\Psi_{s\to t}\),所以支援任意時間到任意時間的轉移,讓取樣策略很有彈性。例如 CTM 提出 γ 取樣,用超參數 \(\gamma\) 控制生成時的隨機性。此外,CTM 可以沿用為 diffusion model 發展的標準推論技巧,例如以 ODE 為基礎的解法和精確的 likelihood 計算。下面固定一組取樣的時間格點 \(T=\tau_0\gt\tau_1\gt\tau_2\gt\cdots\gt\tau_M=0\)。
從 \(\mathbf x_{\tau_0}\sim p_{\text{prior}}=\mathcal N(\mathbf 0,T^2\mathbf I)\) 開始。對 \(n=0,\dots,M-1\):
\(\tilde\tau_{n+1}\leftarrow\sqrt{1-\gamma^2}\,\tau_{n+1}\);
去噪:\(\mathbf x_{\tilde\tau_{n+1}}\leftarrow\mathbf G_{\bm\theta^\times}(\mathbf x_{\tau_n},\tau_n,\tilde\tau_{n+1})\);
擴散:\(\mathbf x_{\tau_{n+1}}\leftarrow\mathbf x_{\tilde\tau_{n+1}}+\gamma\,\tau_{n+1}\bm\epsilon\),\(\bm\epsilon\sim\mathcal N(\mathbf 0,\mathbf I)\)。
輸出 \(\mathbf x_{\tau_M}\)。
為什麼加 \(\gamma\tau_{n+1}\) 的雜訊剛好回到 \(\tau_{n+1}\)
EDM 設定下,時間 \(\tau\) 的邊際是資料加上標準差 \(\tau\) 的高斯。去噪後在時間 \(\tilde\tau_{n+1}=\sqrt{1-\gamma^2}\tau_{n+1}\),雜訊標準差是 \(\sqrt{1-\gamma^2}\tau_{n+1}\);再加獨立的 \(\gamma\tau_{n+1}\bm\epsilon\),變異數相加:\((1-\gamma^2)\tau_{n+1}^2+\gamma^2\tau_{n+1}^2=\tau_{n+1}^2\)。所以如果 \(\mathbf G\) 精確,每一步結束時的分佈正好是 \(p_{\tau_{n+1}}\)。
γ 取樣的方法論。γ 取樣引入一整族取樣器,自然地來自學一般 flow map 模型。它涵蓋先前的做法,例如 CM 的多步取樣(B29 第 13 節),以及概念上類似 ODE 解法的逐步推進式取樣。參數 \(\gamma\) 直接控制生成過程中語意變化的程度,讓 γ 取樣成為一個有彈性、能配合任務的策略。
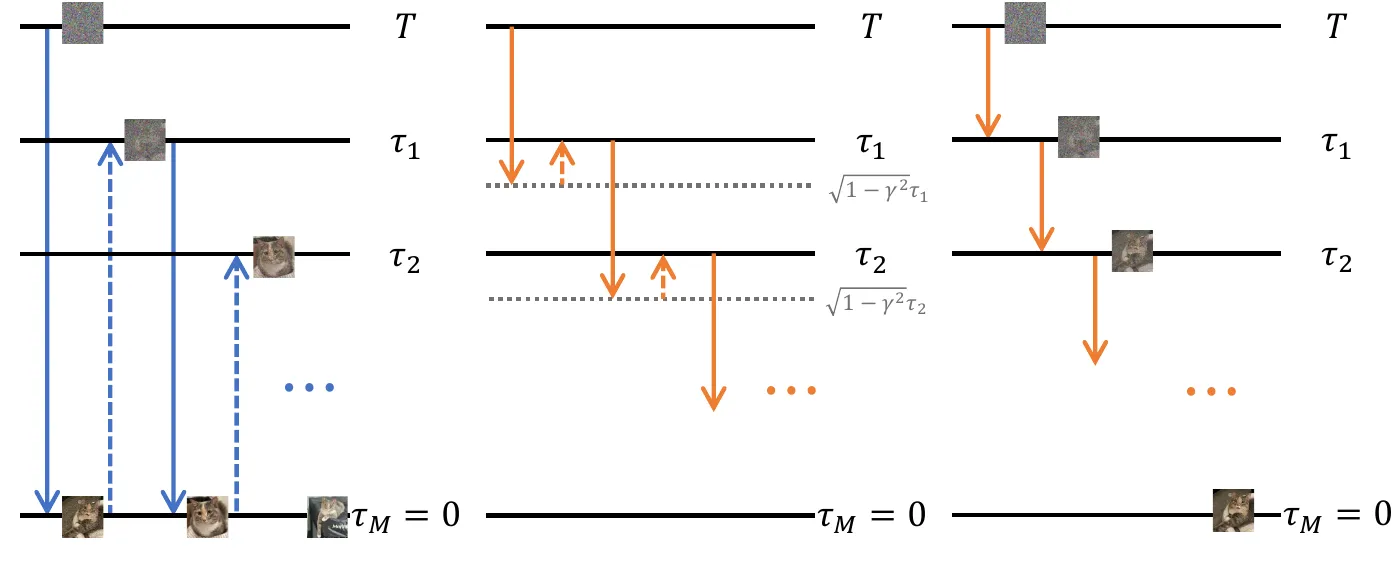
- 左(\(\gamma=1\)):和 CM 的多步取樣相同(只需要特殊的 flow map \(\bm\Psi_{s\to0}\)),完全隨機;步數改變時,生成的語意也會改變。
- 右(\(\gamma=0\)):化成完全確定的逐步推進,估計 PF-ODE 的解軌跡。它和傳統以 ODE 為基礎的逐步取樣有一個關鍵差別:CTM 避開了數值解法的離散化誤差。
- 中(\(0\lt\gamma\lt1\)):在兩個極端之間內插,取樣時注入受控的隨機性。
書特別強調:\(\gamma\in[0,1)\) 需要一般的 flow map \(\bm\Psi_{s\to t}\),只有 \(\gamma=1\) 的特例化成 CM 式的多步取樣,只需要 \(\bm\Psi_{s\to0}\)。
γ 取樣的分析
CTM 在實驗上觀察到,CM 的多步取樣在步數 \(M\ge4\) 以後品質會變差。CTM 分析了原因:當 \(\gamma\ne0\),每一次神經網路的「跳」都會引入一點不匹配,而模型反覆把狀態往時間 0 送時,這些不匹配會累積。這種誤差累積解釋了為什麼長的多步取樣可能表現很差。下面的命題把這個想法形式化。
這個定理的啟示可以總結成:
- \(\gamma=1\)(CM 的多步取樣):每一步 \(n\) 都從 \(\tau_n\) 做長距離轉移到 0,誤差累積的量級是 \(\mathcal O\big(\sqrt{T+\tau_1+\cdots+\tau_M}\big)\)。
- \(\gamma=0\)(CTM 的確定性多步取樣):轉移之間的時間重疊消失了。這避開誤差累積,得到更緊的界 \(\mathcal O(\sqrt T)\)。實驗上,\(\gamma=0\) 的 CTM 在取樣速度和品質之間取得好的平衡:增加取樣步數會改善生成品質,不會帶來不穩定。
把兩步的界代回兩個極端(轉述者補充)
\(\gamma=0\):\(\sqrt{1-0}\,\tau=\tau\),根號裡是 \(T-\tau+\tau=T\),得到 \(\mathcal O(\sqrt T)\):第一步從 \(T\) 跳到 \(\tau\),第二步從 \(\tau\) 跳到 0,兩段時間 \([\tau,T]\) 和 \([0,\tau]\) 剛好拼成 \([0,T]\),沒有重疊。
\(\gamma=1\):\(\sqrt{1-1}\,\tau=0\),根號裡是 \(T+\tau\):第一步從 \(T\) 一路跳到 0,加噪回 \(\tau\) 後,第二步又把 \([0,\tau]\) 這一段走一次。被走過的總時間長度 \(T+\tau\) 比 \(T\) 多出重疊的那一段。根號裡的量可以讀成「網路總共跨過多長的時間」。
CTM 支援 diffusion 的推論。因為 CTM 靠參數化直接透過 \(\mathbf g_{\bm\theta}\) 學到 score(或 denoiser),它和原本為 diffusion model 發展的推論技巧相容。例如可以用 \(\mathbf g_{\bm\theta}(\cdot,s,s)\) 計算精確的 likelihood(§4.3),或用 DDIM、DPM 這類進階解法(第 9 章)生成。
Demo C從頭訓練 CTM 與 γ 取樣轉述者補充
一維、EDM 設定 \(x_s=x_0+s\epsilon\)、\(s\in[0.002,10]\)、Karras 格點 \(N=18\)(\(\rho=7\))。網路 \(g_{\bm\theta}(x,s,t)=c_{\text{skip}}(s)x+c_{\text{out}}(s)F_{\bm\theta}(c_{\text{in}}(s)x,\tfrac14\ln s,\tfrac14\ln t)\)(B29 Demo C 的係數,\(\sigma_{\text d}=1.25\)),\(F\) 是 3→32→32→1 的 tanh MLP,\(G=\frac ts x+(1-\frac ts)g\)。每個訓練樣本:在格點上抽 \(s\gt t\)、\(u\in[t,s)\);老師從 \(s\) 用 Euler(就是 DDIM)沿格點走到 \(u\),再用 stop-gradient 的 \(G\) 跳到 \(t\)、再跳到 0;學生 \(G_{\bm\theta}(x_s,s,t)\) 也經 stop-gradient 的 \(G(\cdot,t,0)\) 送到 0,用平方距離比較。另外每個樣本加一項對角線的 \(\mathbf x\) 預測損失(\(\lambda_{\text{DM}}=1\)),沒有 GAN。5,000 次更新、批次 32、Adam \(2\times10^{-3}\)(最後 30% 乘 0.3),評估用參數的滑動平均。「從頭訓練」時老師的速度是 \((x-g_{\bm\theta^-}(x,s,s))/s\);「精確老師」時用精確的 \((x-\mathbb E[x_0\mid x_s])/s\)。訓練完以 \(M\) 步的 Karras 格點做 γ 取樣,起點是 \(p_T\) 的 2,000 個分層分位數。
瀏覽器實測(和 Node 原型逐位相同;固定種子)。表中是 \(W_1\),\(M=1/2/4/8\):
| 老師 | γ = 0 | γ = 0.5 | γ = 1 | 對角線 DDIM 17 步 |
|---|---|---|---|---|
| 自己誘導 | 0.256 / 0.323 / 0.229 / 0.249 | 0.256 / 0.323 / 0.267 / 0.282 | 0.256 / 0.320 / 0.388 / 0.468 | 0.246 |
| 精確 PF-ODE | 0.152 / 0.175 / 0.137 / 0.158 | 0.152 / 0.176 / 0.166 / 0.187 | 0.152 / 0.156 / 0.186 / 0.248 | 0.183 |
- 不靠任何老師也學得起來。從頭訓練的 CTM 一步 \(W_1=0.256\),和 B29 Demo C 裡 CT(\(N=18\))的 0.240 相當;有精確老師時是 0.152。
- γ = 1 的誤差隨步數累積。從頭訓練時 \(M=1\to8\):0.256 → 0.320 → 0.388 → 0.468;精確老師時 0.152 → 0.248。這正是書說的「CM 式多步取樣,步數多了反而變差」。
- γ = 0 不累積。\(M=8\) 時 0.249(從頭)、0.158(精確老師),和一步差不多;\(M=4\) 時兩者都比一步好(0.229、0.137)。γ = 0.5 介於中間。
- 沒有單調變好。兩種老師在 \(M=2\) 時都比一步差(約 0.32、0.18):兩步的格點是 \(10\to0.48\to0\),學到的 \(G(\cdot,10,0.48)\) 這一跳不夠準。書說的「步數增加會改善品質」是影像上的經驗;這個小網路只做到「不累積誤差」,沒有做到每多一步都更好。
- 對角線就是 diffusion model。只用 \(g_{\bm\theta}(\cdot,s,s)\) 當 denoiser 跑 17 步 DDIM,\(W_1\) 是 0.246(從頭)、0.183(精確老師)。同一個網路既能一步跳,也能當普通的 diffusion model 用。