Fokker–Planck:為什麼反向 SDE 和 PF-ODE 走過同一串分佈;以及怎麼訓練、取樣、算概似
B08 給了三條方程:前向 SDE、反向 SDE、PF-ODE,並說它們在每個時刻有相同的分佈。這一頁說明為什麼:機率密度怎麼隨時間演化,由 Fokker–Planck 方程決定,只要兩個過程讓密度滿足同一條方程、從同一個分佈出發,它們的邊際就相同。接著用高斯資料只靠微積分親手推出反向 SDE 和 PF-ODE,再進入實作:用 denoising score matching 訓練時間相依的 score,用 Euler–Maruyama 或 Euler 法取樣,以及 PF-ODE 的另外兩個用途:把資料反推成雜訊(反演),和精確計算概似。
讀完這頁你應該能夠
- 寫出前向 SDE 的 Fokker–Planck 方程,並把它改寫成速度場 \(\mathbf v=\mathbf f-\tfrac12g^2\nabla\log p_t\) 的連續方程;用它證明 PF-ODE 和反向 SDE 都重現前向的邊際。
- 說明「同一個邊際,可以對應無限多種條件分佈」,以及 flow map、pushforward 的意思。
- 在一維高斯的情況下,只用貝氏定理和 Taylor 展開推出反向 SDE 與 PF-ODE。
- 寫出連續時間的 DSM 損失與它的最佳解;寫出反向 SDE 的 Euler–Maruyama 更新和 PF-ODE 的 Euler 更新。
- 說明 PF-ODE 怎麼用來反演(資料 → 雜訊),以及怎麼透過散度的積分精確計算 \(\log p\)。
前置知識
- B08:前向 SDE、擾動核、反向 SDE、PF-ODE、本章 \(\beta\) 是變異數的記號。
- B06:DSM、最小化解是條件 score 的後驗平均;B04:兩個高斯相乘。
- 散度、Laplacian、連續方程、Fokker–Planck:CS236 補充課 C、補充課 F;書的附錄 B(B34)。
「書 §」標出原文位置。灰框「轉述者補充」是書裡沒有的內容;藍框「推導」展開書中省略的步驟或附錄 D 的證明。符號:\(\Delta_{\mathbf x}\) 是 Laplacian(二階偏導數的和),\(\nabla_{\mathbf x}\cdot\) 是散度。
01不同的過程,相同的邊際書 §4.2
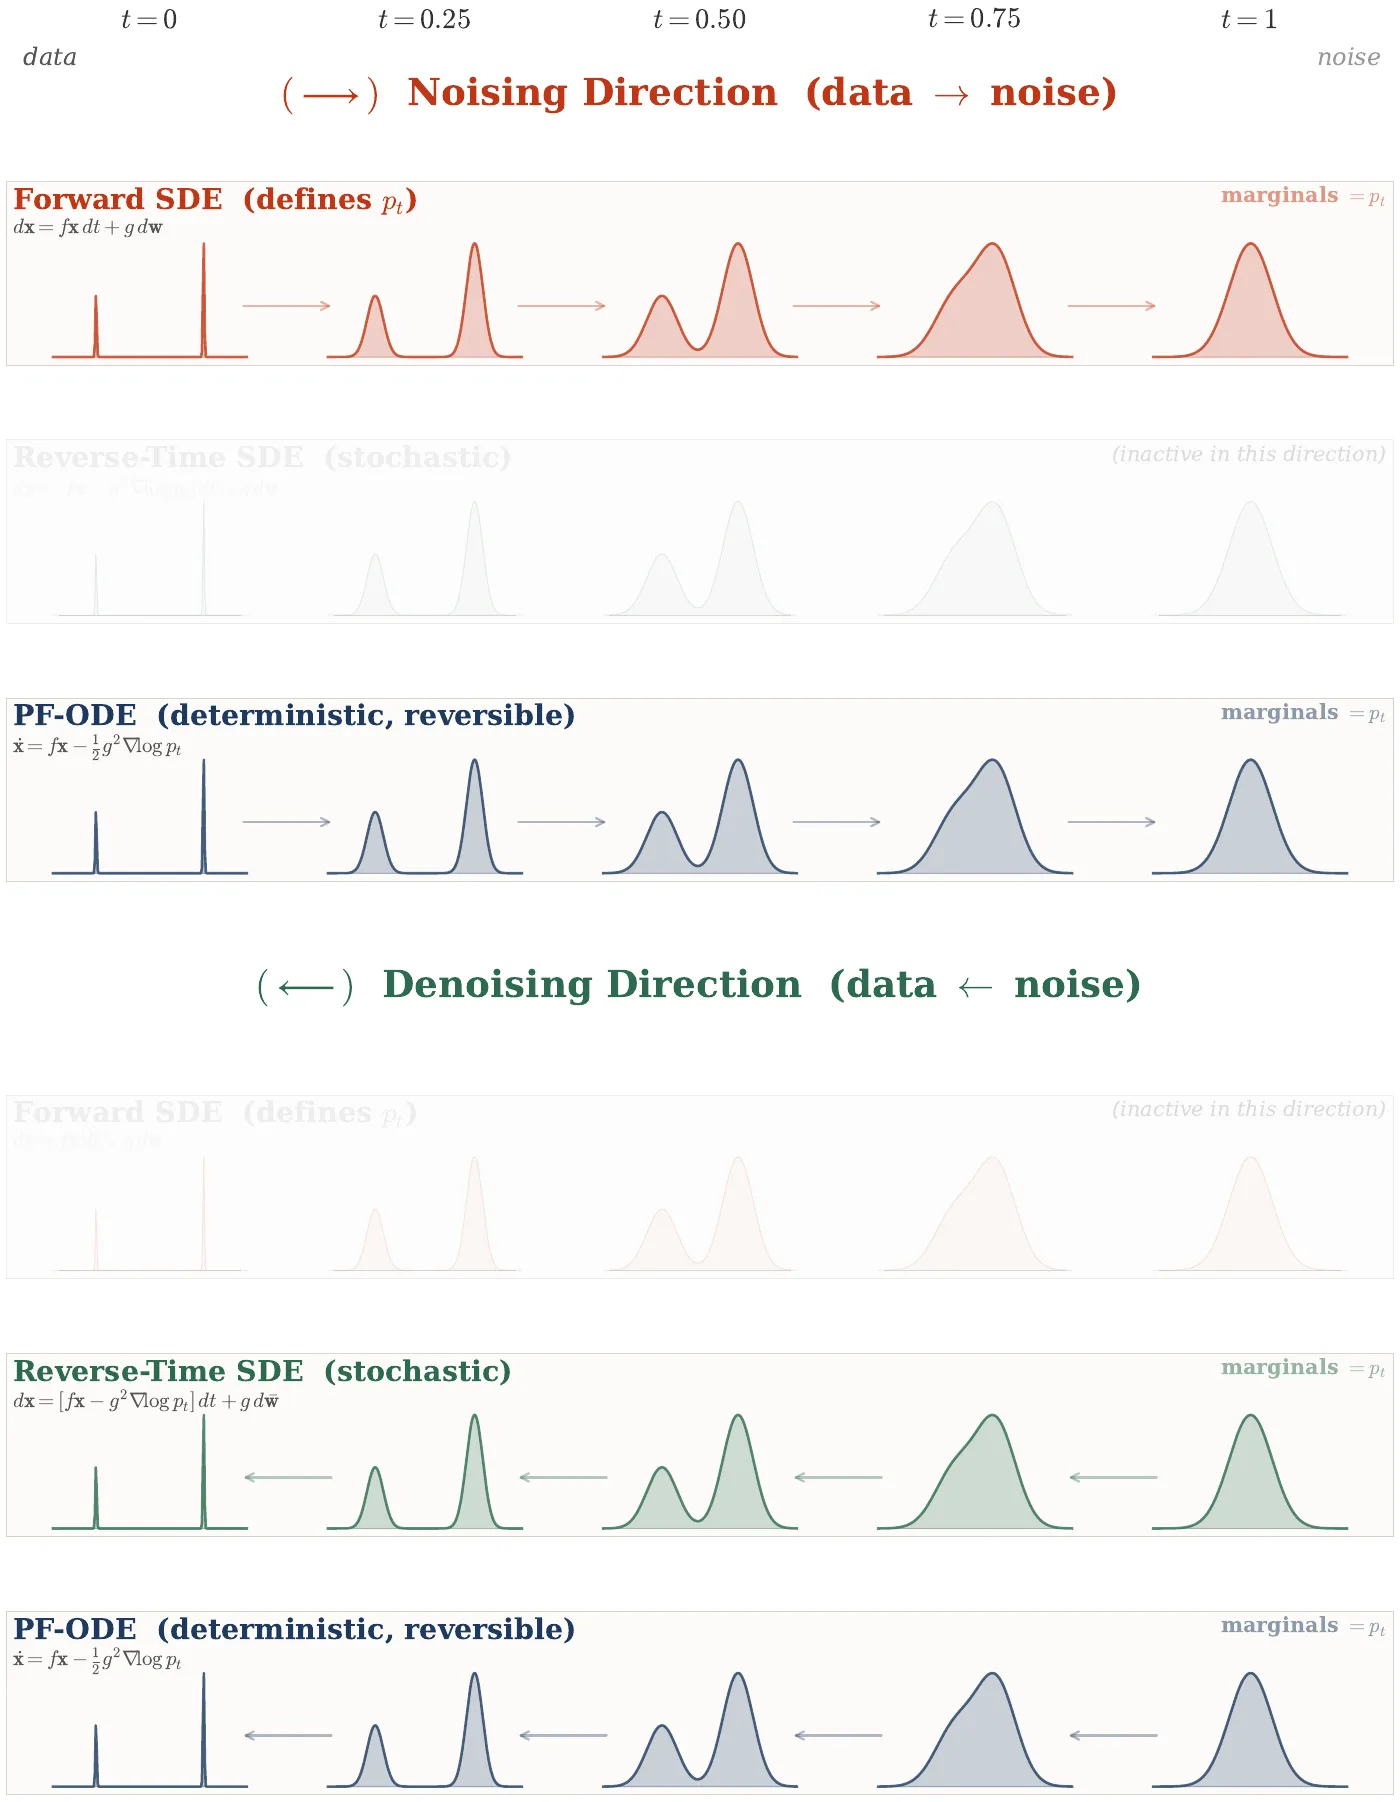
這一節把 Fokker–Planck 方程當成支配 diffusion model 的核心原理。它描述機率密度在帶雜訊的動態下怎麼演化,是「有隨機性時」變數變換公式的自然類比(書的附錄 B)。從定義了邊際 \(p_t\) 的前向擴散過程出發,書說明反向 SDE 和 PF-ODE 怎麼被設計成重現同一族邊際,再用一個高斯的例子把這個原理具體化:在那個例子裡,反向 SDE 和 PF-ODE 都能直接、顯式地算出來。
02Fokker–Planck 方程確保邊際對齊書 §4.2.1
diffusion model 的一個核心概念是:不同的過程可以導出同一串邊際分佈。目標是建構一個把 \(p_{\text{prior}}\) 變成 \(p_{\text{data}}\) 的過程,讓各時刻的邊際對齊,特別是 \(t=0\) 時。過程的確切形式是次要的,只要好處理、能有效率地取樣就好。這自然引出一個根本的問題:
回到我們的設定:一旦指定了前向 SDE,它就定義了邊際密度從 \(p_{\text{data}}\) 到 \(p_{\text{prior}}\) 的演化。反向 SDE 和 PF-ODE 則被建構成讓它們的軌跡產生和前向過程完全相同的邊際分佈。這個對應的關鍵就是 Fokker–Planck 方程,它支配擴散過程下邊際密度怎麼演化。下面的定理(Anderson 1982;Song et al. 2020)建立了這個連結的基礎:
- PF-ODE \(\frac{d\tilde{\mathbf x}(t)}{dt}=\mathbf v(\tilde{\mathbf x}(t),t)\)。從 \(\tilde{\mathbf x}(0)\sim p_0\) 出發、從 0 往前解到 \(T\),得到 \(\tilde{\mathbf x}(t)\sim p_t\)。等價地,從 \(\tilde{\mathbf x}(T)\sim p_T\) 出發、把同一條 ODE 從 \(T\) 倒著解到 0,也倒著走過同樣的邊際。
- 反向 SDE \(d\bar{\mathbf x}(t)=\big[\mathbf f(\bar{\mathbf x}(t),t)-g^2(t)\nabla_{\mathbf x}\log p_t(\bar{\mathbf x}(t))\big]dt+g(t)\,d\bar{\mathbf w}(t)\)。從 \(\bar{\mathbf x}(T)\sim p_T\) 出發、從 \(t=T\) 倒著解到 \(t=0\),沿途在時間 \(t\) 的邊際分佈是 \(\bar{\mathbf x}(t)\sim p_t\)。
證明(書的附錄 D.2,分三部分)
第 1 部分:前向 SDE 的 Fokker–Planck 方程。擴散矩陣是 \(\sigma(t)=g(t)\mathbf I_D\),\(\sigma\sigma^\top=g^2\mathbf I_D\)。一般的 Fokker–Planck 方程是
$$\partial_tp_t=-\nabla\cdot(\mathbf fp_t)+\tfrac12\sum_{i,j}\frac{\partial^2}{\partial x_i\partial x_j}\big[(g^2\delta_{ij})p_t\big].$$只有 \(i=j\) 的項留下,二階項是 \(\sum_i\partial_{x_i}^2(g^2p_t)=g^2\Delta p_t\)。再用 \(\nabla\log p_t=\nabla p_t/p_t\):
$$\nabla\cdot(\mathbf vp_t)=\nabla\cdot(\mathbf fp_t)-\tfrac12g^2\nabla\cdot\nabla p_t=\nabla\cdot(\mathbf fp_t)-\tfrac12g^2\Delta p_t,$$所以 \(\partial_tp_t=-\nabla\cdot(\mathbf vp_t)\),兩種寫法相等。
第 2 部分:PF-ODE 的邊際。往前:令 \(\tilde{\mathbf x}(t)\) 沿 PF-ODE 走、\(\tilde{\mathbf x}(0)\sim p_0\)。粒子沿著速度場 \(\mathbf v\) 確定性地移動,它的密度 \(\tilde p_t\) 滿足連續方程 \(\partial_t\tilde p_t=-\nabla\cdot(\mathbf v\tilde p_t)\)(補充課 C)。第 1 部分說 \(p_t\) 也滿足同一條方程(注意 \(\mathbf v\) 是用 \(p_t\) 定義、事先固定的,所以這是 \(\tilde p_t\) 的線性方程),而且初始值相同 \(\tilde p_0=p_0\)。在足夠的平滑性下(例如 \(\mathbf v\in C^1\)),解是唯一的,所以 \(\tilde p_t=p_t\)。
倒著:令 \(s=T-t\),倒著跑的 ODE 是 \(\frac{d}{ds}\tilde{\mathbf x}(T-s)=-\mathbf v(\tilde{\mathbf x}(T-s),T-s)\),密度滿足 \(\partial_s\tilde p_{T-s}=\nabla\cdot(\mathbf v\tilde p_{T-s})\)。而 \(p_{T-s}\) 由 \(\partial_s=-\partial_t\) 也滿足 \(\partial_sp_{T-s}=\nabla\cdot(\mathbf vp_{T-s})\),初始值 \(\tilde p_T=p_T\) 相同,唯一性給出 \(\tilde p_t=p_t\)。
第 3 部分:反向 SDE 的邊際。用往前跑的時鐘 \(s=T-t\),令 \(\mathbf y(s):=\bar{\mathbf x}(T-s)\),\(\mathbf y(0)\sim p_T\)。反向 SDE 變成
$$d\mathbf y(s)=\big[-\mathbf f(\mathbf y,T-s)+g^2(T-s)\nabla\log p_{T-s}(\mathbf y)\big]ds+g(T-s)\,d\mathbf w^{\text{rev}}(s).$$令 \(q_s\) 是 \(\mathbf y(s)\) 的密度,它的 Fokker–Planck 方程是
$$\partial_sq_s=-\nabla\cdot\Big(\big[-\mathbf f+g^2\nabla\log p_{T-s}\big]q_s\Big)+\tfrac12g^2\Delta q_s.$$檢查 \(q_s=p_{T-s}\) 是不是解:右邊代入後,用 \(p\nabla\log p=\nabla p\),得到 \(\nabla\cdot(\mathbf fp_{T-s})-g^2\Delta p_{T-s}+\tfrac12g^2\Delta p_{T-s}=\nabla\cdot(\mathbf fp_{T-s})-\tfrac12g^2\Delta p_{T-s}\)。左邊由前向的 Fokker–Planck 方程與 \(\partial_s=-\partial_t\):\(\partial_sp_{T-s}=\nabla\cdot(\mathbf fp_{T-s})-\tfrac12g^2\Delta p_{T-s}\)。兩邊相等。又 \(q_0=p_T\),唯一性給出 \(q_s=p_{T-s}\),也就是 \(\bar{\mathbf x}(t)\sim p_t\)。∎
證明的核心一句話,以及「一整族」反向 SDE
證明的核心是同一個代數:\(\tfrac12g^2\Delta p=\nabla\cdot\big(\tfrac12g^2p\nabla\log p\big)\)。擴散項可以「偽裝」成一個沿 score 方向的漂移。PF-ODE 把整份擴散都換成漂移;反向 SDE 則多換了一份(\(g^2\) 而不是 \(\tfrac12g^2\)),再加回同樣強度的雜訊抵消它。
照這個想法,對任何 \(\lambda\ge0\),下面這條 SDE 從 \(T\) 倒著跑,邊際也是 \(p_t\):
$$d\mathbf x=\Big[\mathbf f-\tfrac{1+\lambda^2}{2}g^2\nabla\log p_t\Big]dt+\lambda g\,d\bar{\mathbf w}.$$\(\lambda=0\) 是 PF-ODE,\(\lambda=1\) 是反向 SDE。這就是書在後面說的「有一整族和同一個 \(p_t\) 一致的反向 SDE」的一個具體形式(驗證方法和第 3 部分相同:多減的 \(\tfrac{\lambda^2}2g^2\Delta p\) 剛好被雜訊帶來的 \(\tfrac{\lambda^2}2g^2\Delta p\) 抵消)。
書說 §4.6.1(B10 第 5 節)會用機率的邊際化技巧,給 Fokker–Planck 方程更多直覺。
同一個邊際,多種條件分佈
為了理解 PF-ODE 怎麼把 \(p_{\text{data}}\) 往前運送(或等價地,把 \(p_{\text{prior}}\) 倒著運送),考慮 flow map(流映射)\(\bm\Psi_{s\to t}:\mathbb R^D\to\mathbb R^D\):\(\bm\Psi_{s\to t}(\mathbf x_s)\) 表示從時間 \(s\) 的 \(\mathbf x_s\) 出發、PF-ODE 在時間 \(t\) 的解,\(s,t\in[0,T]\)。換句話說,這個映射接收初始狀態 \(\mathbf x_s\),直接跳到它在 \(t\) 的狀態:
$$\bm\Psi_{s\to t}(\mathbf x_s):=\mathbf x_s+\int_s^t\mathbf v(\mathbf x_\tau,\tau)\,d\tau,\qquad\mathbf v(\mathbf x,\tau):=\mathbf f(\mathbf x,\tau)-\tfrac12g^2(\tau)\nabla_{\mathbf x}\log p_\tau(\mathbf x).$$積分記錄了沿 PF-ODE 軌跡累積的淨位移。「flow map」這個詞在微分方程、動力系統和連續介質力學裡是古典的:它是在給定動態下,把一個狀態從時間 \(s\) 的位置帶到時間 \(t\) 的位置的映射。速度場 \(\mathbf v(\mathbf x,t)\) 描述瞬間的運動,flow map \(\bm\Psi_{s\to t}\) 記錄有限時間區間內累積的運動(Arnold 1988;Chorin & Marsden 1993)。書的註腳說,背後的物理想法更古老:18 世紀的流體力學已經透過速度場、追蹤物質粒子的演化來研究運動,特別是 Euler 和 Lagrange 的奠基工作。書在全書都用這個標準的數學與物理意義,特別是第 10、11 章討論快速的 diffusion 生成器時。在 \(\mathbf v\) 有溫和平滑性的假設下,flow map \(\bm\Psi_{s\to t}\) 是平滑的雙射。
書的註腳(劇透):PF-ODE 的 flow map \(\bm\Psi_{s\to t}\) 正是把 \(p_s\) 帶到 \(p_t\) 的 normalizing flow 雙射(第 5 章,B11)。差別在於:一旦固定了前向 SDE 和它的邊際,PF-ODE 公式就唯一決定了速度場 \(\mathbf v=\mathbf f-\tfrac12g^2\nabla\log p_t\);normalizing flow(或連續時間的 normalizing flow)則是直接參數化並學習一個速度場。兩者都依賴同一個連續變數變換原理。
對任何 \(t\in[0,T]\),定義 pushforward 密度
$$p_t^{\text{fwd}}(\mathbf x_t):=\int\delta\big(\mathbf x_t-\bm\Psi_{0\to t}(\mathbf x_0)\big)\,p_{\text{data}}(\mathbf x_0)\,d\mathbf x_0,$$記作 \(\bm\Psi_{0\to t}\sharp p_{\text{data}}\),代表在 \(\bm\Psi_{0\to t}\) 之下時間 \(t\) 的分佈。上面的定理保證 \(p_t^{\text{fwd}}=p_t\)(前向 SDE 的邊際),也就是把確定性的 PF-ODE 和隨機的核畫上等號:
$$p_t(\mathbf x_t)=\int p_t(\mathbf x_t\mid\mathbf x_0)\,p_{\text{data}}(\mathbf x_0)\,d\mathbf x_0=\int\delta\big(\mathbf x_t-\bm\Psi_{0\to t}(\mathbf x_0)\big)\,p_{\text{data}}(\mathbf x_0)\,d\mathbf x_0.$$這表示有無限多種條件分佈 \(Q_t(\mathbf x_t\mid\mathbf x_0)\) 都產生同一個 \(p_t(\mathbf x_t)\),例如:
- 隨機的(simulation-free):\(Q_t(\mathbf x_t\mid\mathbf x_0)=p_t(\mathbf x_t\mid\mathbf x_0)\);
- 確定性的(需要解 ODE):\(Q_t(\mathbf x_t\mid\mathbf x_0)=\delta\big(\mathbf x_t-\bm\Psi_{0\to t}(\mathbf x_0)\big)\);
- 混合:\(Q_t(\mathbf x_t\mid\mathbf x_0)=\lambda\,p_t(\mathbf x_t\mid\mathbf x_0)+(1-\lambda)\,\delta\big(\mathbf x_t-\bm\Psi_{0\to t}(\mathbf x_0)\big)\),\(\lambda\in[0,1]\)。
\(Q_t(\mathbf x_t\mid\mathbf x_0)\) 不唯一,是因為邊際的限制並不唯一決定條件分佈。這個概念會在 §5.2(flow matching,B12)和 §9.2(DDIM,B25)再出現。特別是,存在一整族和同一個邊際 \(p_t\) 一致的反向 SDE。
一個最簡單的例子:同一個邊際,兩種條件分佈
令 \(x_0\sim\mathcal N(0,1)\),要讓 \(x_t\) 的邊際是 \(\mathcal N(0,2)\)。做法一(隨機):\(x_t=x_0+\epsilon\),\(\epsilon\sim\mathcal N(0,1)\),條件分佈是 \(\mathcal N(x_0,1)\)。做法二(確定):\(x_t=\sqrt2\,x_0\),條件分佈是一個點 \(\delta(x_t-\sqrt2x_0)\)。兩者的 \(x_t\) 都是 \(\mathcal N(0,2)\),但給定 \(x_0\) 時一個是一團、一個是一點;同一個 \(x_0\) 在做法一可能落在任何地方,在做法二永遠落在 \(\sqrt2x_0\)。前向 SDE 和 PF-ODE 的關係就是這樣。
Fokker–Planck 方程位於 diffusion model 的核心,它植根於機率密度的基本變數變換公式(附錄 B 有系統的處理)。這個原理遠不是無關緊要的技術細節,它在整本書反覆出現,最顯著的是第 5.2 節(B12)。
03一個可以算的例子:高斯動態的演化書 §4.2.2
當 \(p_{\text{data}}\) 是常態分佈(或高斯混合)時,score function 有封閉形式。這讓它成為建立 diffusion 過程直覺的理想場景:只用基本的微積分就能顯式推出反向 SDE 和 PF-ODE,不必動用進階的數學工具。
用高斯精確算出反向 SDE
\(p_{\text{data}}\) 是高斯時,可以不靠 Anderson 的一般理論和證明,直接推出反向 SDE 的公式。為了說明核心想法,考慮一維;高維完全一樣。
從前向 SDE \(dx(t)=f(t)x(t)\,dt+g(t)\,dw_t\) 出發,走一小步 Euler,步長 \(\Delta t>0\):
$$x_{t+\Delta t}=a\,x_t+r\,\epsilon,\qquad a:=1+f(t)\Delta t,\quad r:=g(t)\sqrt{\Delta t},\quad\epsilon\sim\mathcal N(0,1),$$也就是前向一步的轉移核是高斯:\(x_{t+\Delta t}\mid x_t\sim\mathcal N(\cdot;a\,x_t,r^2)\)。因為假設 \(p_{\text{data}}\) 是高斯,時間 \(t\) 的邊際也是高斯:\(x_t\sim\mathcal N(\cdot;m_t,s_t^2)\),\(m_t\)、\(s_t\) 是某些純量。所以條件化就是兩個高斯相乘再重新正規化,代數都很初等。
由貝氏定理,條件密度(差一個常數)是先驗乘上轉移核:
$$p(x_t\mid x_{t+\Delta t})\propto p(x_{t+\Delta t}\mid x_t)\,p_t(x_t)\propto\exp\!\Big(-\frac{(x_t-m_t)^2}{2s_t^2}\Big)\exp\!\Big(-\frac{(x_{t+\Delta t}-a\,x_t)^2}{2r^2}\Big).$$指數是 \(x_t\) 的二次式。展開兩個平方、整理之後,看得出哪些係數重要:
$$-2\log p(x_t\mid x_{t+\Delta t})=A\,x_t^2-2B\,x_t+\text{常數},\qquad A:=\frac1{s_t^2}+\frac{a^2}{r^2},\quad B:=\frac{m_t}{s_t^2}+\frac{a\,x_{t+\Delta t}}{r^2}.$$\(A\) 是精確度的和(先驗的精確度加上經 \(a\) 運送過的轉移核精確度),\(B\) 是對應的「精確度加權的目標和」。有了它們,配方一行就得到後驗:\(Ax_t^2-2Bx_t=A\big(x_t-\frac BA\big)^2-\frac{B^2}A\),所以條件分佈是變異數 \(1/A\)、平均 \(B/A\) 的高斯:
$$\operatorname{Var}(x_t\mid x_{t+\Delta t})=\frac1{\frac1{s_t^2}+\frac{a^2}{r^2}},\qquad\mathbb E[x_t\mid x_{t+\Delta t}]=\frac{\frac{m_t}{s_t^2}+\frac{a\,x_{t+\Delta t}}{r^2}}{\frac1{s_t^2}+\frac{a^2}{r^2}}.$$這些封閉形式已經描述了任何小 \(\Delta t\) 的反向轉移。為了讀出反向 SDE,接著對小 \(\Delta t\) 展開。用 \(a=1+f(t)\Delta t\)、\(r^2=g^2(t)\Delta t\)。當 \(\Delta t\to0\),\(\frac{a^2}{r^2}\sim\frac1{g^2(t)\Delta t}\) 主導精確度,所以變異數變成
$$\operatorname{Var}(x_t\mid x_{t+\Delta t})=\Big(\frac1{s_t^2}+\frac{a^2}{r^2}\Big)^{-1}=g^2(t)\,\Delta t+\mathcal O(\Delta t^2),$$也就是反向一步的擴散尺度和前向一步相同,都是 \(g(t)\)。平均則把比值 \(B/A\) 展開到一階:
$$\mathbb E[x_t\mid x_{t+\Delta t}]=x_{t+\Delta t}+\Delta t\Big[-\Big(f(t)+\frac{g^2(t)}{s_t^2}\Big)x_{t+\Delta t}+\frac{g^2(t)}{s_t^2}m_t\Big]+\mathcal O(\Delta t^2).$$平均與變異數的展開
分子分母同乘 \(r^2=g^2\Delta t\):
$$\frac BA=\frac{x_{t+\Delta t}(1+f\Delta t)+\frac{g^2\Delta t}{s_t^2}m_t}{1+2f\Delta t+\frac{g^2\Delta t}{s_t^2}+\mathcal O(\Delta t^2)}.$$(分母用 \(a^2=1+2f\Delta t+\mathcal O(\Delta t^2)\)。)再用 \(\frac1{1+u}=1-u+\mathcal O(u^2)\):
$$\frac BA=\Big[x_{t+\Delta t}+\Delta t\Big(fx_{t+\Delta t}+\frac{g^2}{s_t^2}m_t\Big)\Big]\Big[1-\Delta t\Big(2f+\frac{g^2}{s_t^2}\Big)\Big]+\mathcal O(\Delta t^2)=x_{t+\Delta t}+\Delta t\Big[-\Big(f+\frac{g^2}{s_t^2}\Big)x_{t+\Delta t}+\frac{g^2}{s_t^2}m_t\Big]+\mathcal O(\Delta t^2).$$變異數:\(\frac1A=\frac{g^2\Delta t}{a^2+g^2\Delta t/s_t^2}=g^2\Delta t\,(1+\mathcal O(\Delta t))\)。
把平均和變異數合起來,就是反向一步的轉移核:
$$x_t\mid x_{t+\Delta t}\sim\mathcal N\!\Big(x_{t+\Delta t}+\Delta t\Big[-\Big(f+\frac{g^2}{s_t^2}\Big)x_{t+\Delta t}+\frac{g^2}{s_t^2}m_t\Big],\ g^2\Delta t\Big)+\mathcal O(\Delta t^2).$$它正是從 \(t+\Delta t\) 倒著跑到 \(t\) 的 Euler–Maruyama 更新:
$$x_t-x_{t+\Delta t}=\Delta t\Big[-\Big(f+\frac{g^2}{s_t^2}\Big)x_{t+\Delta t}+\frac{g^2}{s_t^2}m_t\Big]+g\sqrt{\Delta t}\,\epsilon.$$這個倒著的漂移可以用 score 寫出來,因為對高斯邊際 \(p_t=\mathcal N(m_t,s_t^2)\),
$$\partial_x\log p_t(x)=-\frac{x-m_t}{s_t^2}\ \Longrightarrow\ -\Big(f+\frac{g^2}{s_t^2}\Big)x+\frac{g^2}{s_t^2}m_t=-\big[fx-g^2\partial_x\log p_t(x)\big].$$因此令 \(\Delta t\to0\),就在原本的 diffusion 時鐘上得到反向 SDE
$$d\bar x(t)=\big[f(t)\bar x(t)-g^2(t)\,\partial_x\log p_t(\bar x(t))\big]dt+g(t)\,d\bar w(t),\qquad t:T\to0,$$和 B08 的一般反向 SDE 完全一致。向量形式時,把純量導數 \(\partial_x\log p_t\) 換成 \(\nabla_{\mathbf x}\log p_t\)。
轉述者注:這和 B04 推 DDPM 反向核用的是同一招(兩個高斯相乘),差別只在 B04 以 \(\mathbf x_0\) 為條件,這裡以邊際 \(p_t\) 為先驗、不需要 \(\mathbf x_0\):資料是高斯時,邊際本身就是高斯,所以真正的反向核可以直接算。
用高斯精確算出 PF-ODE
資料分佈假設為高斯時,也可以直接推出 PF-ODE 的公式,避開 Fokker–Planck 方程之類的重型工具。最後會看到 PF-ODE 的邊際密度和前向 SDE、反向 SDE 都一致,為第 2 節的 Fokker–Planck 理論提供一個建構式的驗證。
假設時間 \(t\) 時 \(x_t\sim\mathcal N(\cdot;m_t,s_t^2)\)。大小 \(\Delta t\) 的一小步確定性移動可以寫成一個平滑映射(只是 \(\Delta t\) 的一階 Taylor 展開):
$$x_{t+\Delta t}=\Phi_{t,\Delta t}(x_t)=x_t+\Delta t\,v_t(x_t)+\mathcal O(\Delta t^2).$$目標是建構一個速度場,讓它的確定性流重現同樣的高斯邊際演化。一個特別簡單的選擇是仿射速度場 \(v_t(x)=a_tx+b_t\)。仿射動態保持高斯性,所以可以靠匹配前向 SDE 的平均與變異數演化來決定 \(a_t\)、\(b_t\)。代回這一步:
$$x_{t+\Delta t}=(1+\alpha_t\Delta t)\,x_t+\beta_t\Delta t+\mathcal O(\Delta t^2),\qquad\alpha_t:=a_t,\ \beta_t:=b_t.$$轉述者注:這裡的 \(\alpha_t\)、\(\beta_t\) 只是速度場的兩個係數,和 DDPM 的 \(\alpha\)、\(\beta\) 無關,書在這個小推導裡借用了同樣的字母。
把 \(x_t\sim\mathcal N(\cdot;m_t,s_t^2)\) 推過這個映射,追蹤一階的平均和變異數:
$$\mathbb E[x_{t+\Delta t}]=m_t+\Delta t(\alpha_tm_t+\beta_t)+\mathcal O(\Delta t^2),\qquad\operatorname{Var}(x_{t+\Delta t})=s_t^2+\Delta t\,(2\alpha_ts_t^2)+\mathcal O(\Delta t^2).$$另一方面,前向 SDE \(dx=f(t)x\,dt+g(t)\,dw_t\) 有初等的動差公式(B08 第 4 節的推導框):
$$m_t'=f(t)\,m_t,\qquad(s_t^2)'=2f(t)\,s_t^2+g^2(t).$$比對 \(\Delta t\) 的係數得到
$$\alpha_t=f(t)+\frac{g^2(t)}{2s_t^2},\qquad\beta_t=-\frac{g^2(t)}{2s_t^2}\,m_t.$$代回去,這一步變成
$$x_{t+\Delta t}=x_t+\Delta t\Big[\Big(f(t)+\frac{g^2(t)}{2s_t^2}\Big)x_t-\frac{g^2(t)}{2s_t^2}m_t\Big]+\mathcal O(\Delta t^2).$$對高斯 \(p_t=\mathcal N(m_t,s_t^2)\),\(\partial_x\log p_t(x)=-(x-m_t)/s_t^2\),所以中括號可以寫成 \(f(t)x_t-\tfrac12g^2(t)\partial_x\log p_t(x_t)\)。除以 \(\Delta t\)、令 \(\Delta t\to0\),得到 PF-ODE
$$x'(t)=f(t)\,x(t)-\tfrac12g^2(t)\,\partial_x\log p_t\big(x(t)\big).$$為什麼這條 ODE 和前向 SDE(以及反向 SDE)有相同的邊際?上面的漂移是線性加上平移,所以 \(x(t)\) 是 \(x(0)\) 的仿射函數,而仿射映射把高斯送到高斯。而且沿著這條 ODE,平均 \(m_t\) 和變異數 \(s_t^2\) 滿足和前向 SDE 完全相同的兩條純量 ODE(這是我們匹配出來的),初始值也相同。所以兩種演化在每個時刻 \(t\) 的 \(p_t=\mathcal N(m_t,s_t^2)\) 都相同。
同一個推導看 \(\tfrac12\) 從哪裡來
確定性的一步只會把變異數乘上 \((1+\alpha\Delta t)^2\),變化率是 \(2\alpha s^2\);前向 SDE 的變異數變化率是 \(2fs^2+g^2\),其中 \(g^2\) 來自注入的雜訊。要讓 ODE 不加雜訊也跟上,就要把那份 \(g^2\) 平均分到「\(2\alpha s^2\)」的兩倍裡:\(2\alpha s^2=2fs^2+g^2\Rightarrow\alpha=f+\frac{g^2}{2s^2}\)。分母的 2 就是 \(\tfrac12\) 的來源。反向 SDE 則是另一個方向:倒著走時要把變異數減小 \(g^2\Delta t\),同時又加了 \(g^2\Delta t\) 的新雜訊,所以漂移要收縮兩倍的量,係數是 \(g^2\)。
Demo A一步反向:精確的貝氏後驗 vs. 反向 SDE 的一步轉述者補充
資料是一維高斯 \(\mathcal N(1,0.3^2)\),前向是 VP SDE(\(\beta(t)=0.1+19.9t\),所以 \(f=-\tfrac12\beta\)、\(g^2=\beta\))。在 \(t\) 時刻、觀測到 \(x_{t+\Delta t}\) 之後,比較兩件事:上面用配方算出的精確後驗 \(\mathcal N(B/A,1/A)\),以及一階展開得到的反向 SDE 一步。
瀏覽器實測(\(t=0.3\)、\(x_{t+\Delta t}=0.4\)):
| \(\Delta t\) | 平均:精確 / 一階 | 平均的誤差 | 變異數:精確 / \(g^2\Delta t\) |
|---|---|---|---|
| 0.1 | 0.61087 / 0.73934 | \(1.3\times10^{-1}\) | 0.4231 / 0.6070 |
| 0.01 | 0.43243 / 0.43393 | \(1.5\times10^{-3}\) | 0.05864 / 0.06070 |
| 0.001 | 0.40338 / 0.40339 | \(1.5\times10^{-5}\) | 0.006049 / 0.006070 |
\(\Delta t\) 每縮小 10 倍,平均和變異數的誤差都縮小 100 倍(在 \(\Delta t\le10^{-2}\) 的範圍,log-log 斜率實測都是 2.00),正好是推導裡的 \(\mathcal O(\Delta t^2)\)。所以「反向一步 = Euler–Maruyama 倒著走一步」只在步子小時成立:\(\Delta t=0.1\) 時一階平均差了 0.13。\(t\) 越大,\(\beta(t)\) 越大(\(t=0.8\) 時約 16),同樣的 \(\Delta t\) 就越早離開這個漸近區,曲線的右端會彎掉。這也預告了第 9 章(B24–B27)的取樣器問題:步子大時,一階近似不夠。
04訓練書 §4.3.1
沿用第 3 章的想法,用一個以時間為條件的神經網路 \(\mathbf s_{\bm\phi}=\mathbf s_{\bm\phi}(\mathbf x,t)\) 在所有 \(t\in[0,T]\) 上近似真正的 score \(\nabla_{\mathbf x}\log p_t(\mathbf x)\),方法是最小化一個 score matching 目標(B05 的 SM):
$$\mathcal L_{\text{SM}}(\bm\phi;\omega(\cdot)):=\frac12\,\mathbb E_{t\sim p_{\text{time}}}\mathbb E_{\mathbf x_t\sim p_t}\Big[\omega(t)\big\Vert\mathbf s_{\bm\phi}(\mathbf x_t,t)-\nabla_{\mathbf x}\log p_t(\mathbf x_t)\big\Vert_2^2\Big],$$\(p_{\text{time}}\) 是某個時間分佈(例如 \([0,T]\) 上的均勻分佈),\(\omega(\cdot)\) 是時間權重函數。
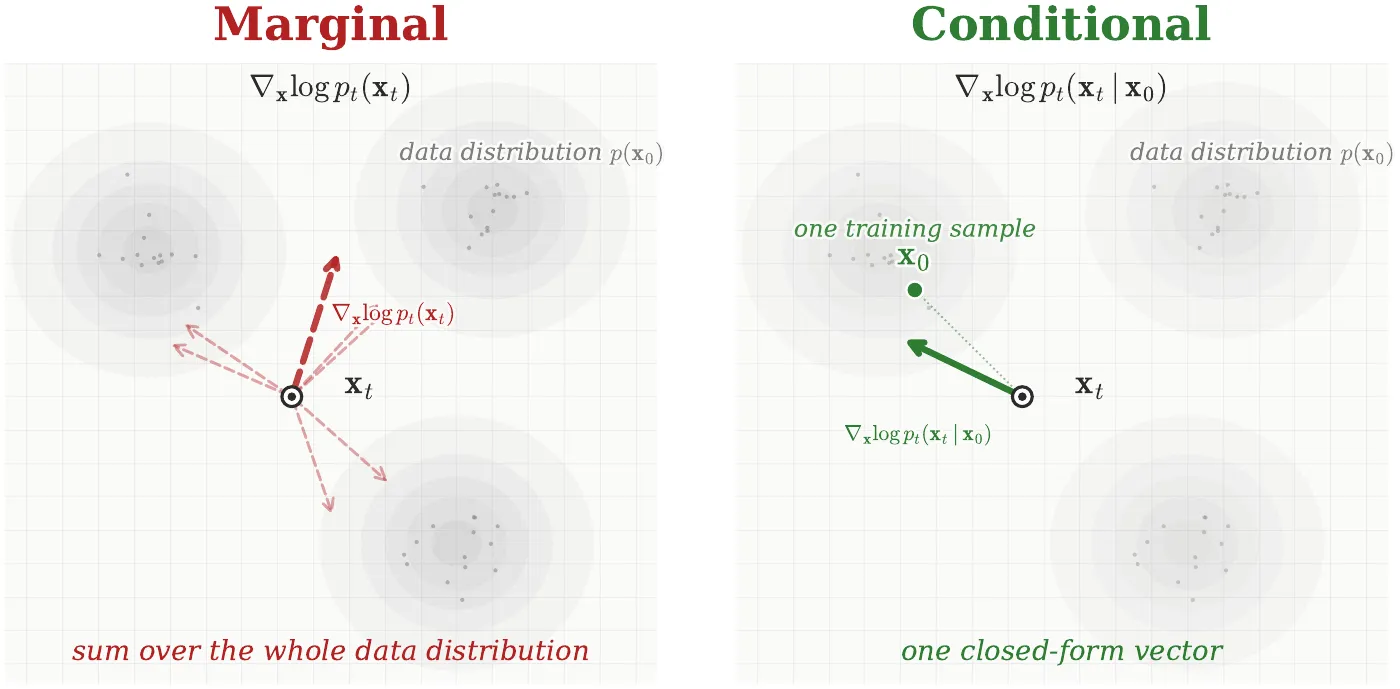
為了不依賴算不出來的真正 score,改用 DSM 損失(B06)。以資料點 \(\mathbf x_0\) 為條件,就能用解析上好處理的 \(\nabla_{\mathbf x_t}\log p_t(\mathbf x_t\mid\mathbf x_0)\)(具體例子在 §4.4,B10)。具體地,使用下面的損失:
\(\mathbf x_0\sim p_{\text{data}}\)。它可以理解成 NCSN 損失(B07)的連續時間版本:離散情況的加總換成了積分。
仿射漂移時的條件 score 長什麼樣
由 B08,\(p_t(\mathbf x_t\mid\mathbf x_0)=\mathcal N(\mathbf x_t;a(t)\mathbf x_0,P(t)\mathbf I)\),\(a(t)=e^{\int_0^tf}\)。所以
$$\nabla_{\mathbf x_t}\log p_t(\mathbf x_t\mid\mathbf x_0)=-\frac{\mathbf x_t-a(t)\mathbf x_0}{P(t)}=-\frac{\boldsymbol\epsilon}{\sqrt{P(t)}},\qquad\text{若 }\mathbf x_t=a(t)\mathbf x_0+\sqrt{P(t)}\,\boldsymbol\epsilon.$$和 B07 一樣,若把網路寫成 \(\mathbf s_{\bm\phi}=-\boldsymbol\epsilon_{\bm\phi}/\sqrt{P(t)}\) 並取 \(\omega(t)=P(t)\),損失就是 \(\tfrac12\mathbb E\Vert\boldsymbol\epsilon_{\bm\phi}-\boldsymbol\epsilon\Vert^2\):DDPM 的 \(\mathcal L_{\text{simple}}\),只是 \(t\) 變成連續的。Demo C 就是這樣訓練的。
和 B06 的定理類似,這個損失的最小化解是唯一決定的:
證明的想法(書):DSM 是最小平方問題。在每個時間 \(t\),最佳的 score 是條件 log 密度梯度的條件期望,由貝氏定理它等於邊際 log 密度的梯度。完整的推導和 B06 第 2 節證明框最後一段相同(附錄 D.2);只要 \(\omega(t)>0\),每個 \(t\) 可以各自最小化。
05取樣與推論書 §4.3.2
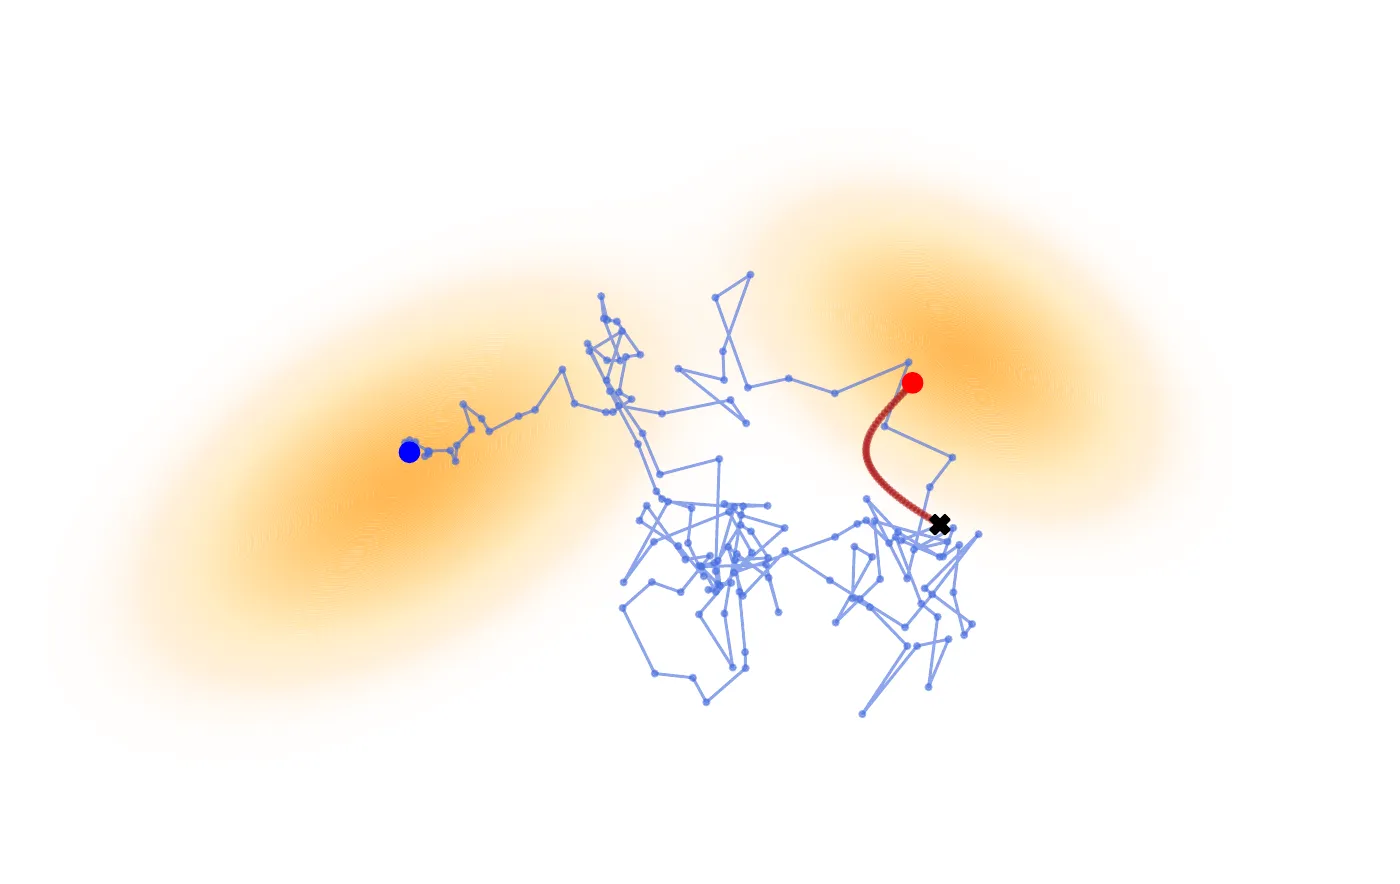
轉述者注:這張圖的 \(g(t)=\sqrt{2t}\) 給出 \(P(t)=\int_0^t2s\,ds=t^2\),所以 \(\mathbf x_t=\mathbf x_0+t\,\boldsymbol\epsilon\):雜訊標準差恰好等於時間。這是 EDM(Karras et al. 2022)採用的設定,書在附錄 D.6(選讀)介紹 EDM。
學到
$$\mathbf s_{\bm\phi^\times}:=\mathbf s_{\bm\phi^\times}(\mathbf x,t)\approx\nabla_{\mathbf x}\log p_t(\mathbf x)$$之後,把反向 SDE 和 PF-ODE 裡算不出來的真正 score 換成學到的替代品 \(\mathbf s_{\bm\phi^\times}(\mathbf x,t)\)。這個代換讓推論可以用 SDE 或 ODE 進行。為了清楚,書把得到的兩個過程分別記作 \(\mathbf x^{\text{SDE}}_{\bm\phi^\times}(t)\) 和 \(\mathbf x^{\text{ODE}}_{\bm\phi^\times}(t)\),之後的章節會省略這個區分。
經驗的反向 SDE
把訓練好的 score 模型代入反向 SDE,得到用來生成的參數化反向 SDE:
$$d\mathbf x^{\text{SDE}}_{\bm\phi^\times}(t)=\Big[\mathbf f\big(\mathbf x^{\text{SDE}}_{\bm\phi^\times}(t),t\big)-g^2(t)\,\mathbf s_{\bm\phi^\times}\big(\mathbf x^{\text{SDE}}_{\bm\phi^\times}(t),t\big)\Big]dt+g(t)\,d\bar{\mathbf w}(t).$$生成一個樣本:先從先驗 \(p_{\text{prior}}\) 抽初始值 \(\mathbf x_T\),再把上式從 \(t=T\) 倒著數值解到 \(t=0\)。標準的數值解法是 Euler–Maruyama,更新規則是
\(\boldsymbol\epsilon\sim\mathcal N(\mathbf 0,\mathbf I)\),\(\Delta t>0\) 是步長。反覆套用得到最後的樣本 \(\mathbf x^{\text{SDE}}_{\bm\phi^\times}(0)\)。如果 score 模型夠準,這些生成樣本的分佈 \(p^{\text{SDE}}_{\bm\phi^\times}(\cdot;0)\) 就很接近真正的資料分佈:\(p^{\text{SDE}}_{\bm\phi^\times}(\cdot;0)\approx p_{\text{data}}(\cdot)\)。
書的註腳:理論上,估計的準確度取決於 \(p_T\) 和 \(p_{\text{prior}}\) 的差距(通常可以忽略)、模型的訓練誤差,以及數值離散化誤差(De Bortoli 2022;Wang et al. 2024)。書不在這裡推正式的界。
事實上,對 VP 的建構,B04 的 DDPM 取樣式和上面的 Euler–Maruyama 離散化有相同的連續時間反向 SDE 極限(§4.4,B10)。
經驗的 PF-ODE
PF-ODE 定義了連接 \(p_{\text{prior}}\) 和 \(p_{\text{data}}\) 的連續流,可以用來取樣、編碼,以及精確計算概似。
I. 用 PF-ODE 取樣。把 PF-ODE 裡的真正 score 換成 \(\mathbf s_{\bm\phi^\times}\),得到經驗的 PF-ODE:
$$\frac{d}{dt}\mathbf x^{\text{ODE}}_{\bm\phi^\times}(t)=\mathbf f\big(\mathbf x^{\text{ODE}}_{\bm\phi^\times}(t),t\big)-\frac12g^2(t)\,\mathbf s_{\bm\phi^\times}\big(\mathbf x^{\text{ODE}}_{\bm\phi^\times}(t),t\big).$$生成樣本:先從先驗抽初始樣本 \(\mathbf x_T\),再把上式從 \(t=T\) 倒著數值解到 \(t=0\),這等價於近似積分
$$\mathbf x^{\text{ODE}}_{\bm\phi^\times}(0)=\mathbf x_T+\int_T^0\Big[\mathbf f\big(\mathbf x^{\text{ODE}}_{\bm\phi^\times}(\tau),\tau\big)-\frac12g^2(\tau)\,\mathbf s_{\bm\phi^\times}\big(\mathbf x^{\text{ODE}}_{\bm\phi^\times}(\tau),\tau\big)\Big]d\tau.$$這個確定性過程生成的樣本分佈記作 \(p^{\text{ODE}}_{\bm\phi^\times}(\cdot;0)\),它近似資料分佈:\(p^{\text{ODE}}_{\bm\phi^\times}(\cdot;0)\approx p_{\text{data}}\)。令 \(\Delta t>0\) 是離散化的步長,標準的數值積分是 Euler 法:在 \(\tau\in[t-\Delta t,t]\) 上,用右端點的值近似被積函數,\(\mathbf f(\mathbf x_\tau,\tau)-\tfrac12g^2(\tau)\mathbf s_{\bm\phi^\times}(\mathbf x_\tau,\tau)\approx\mathbf f(\mathbf x_t,t)-\tfrac12g^2(t)\mathbf s_{\bm\phi^\times}(\mathbf x_t,t)\),得到更新規則
這個連結讓我們用下面的核心洞見重新看待生成:
這個等價清楚解釋了 diffusion model 取樣為什麼慢(B07 的問題):微分方程的數值解法本質上是迭代的,常常需要很多步才能準確近似一條解軌跡(書的註腳:例如 DDPM 和 Score SDE 通常用 1,000 次函數計算來生成)。但 PF-ODE 的寫法也有好處:它讓我們能利用大量加速數值求解器的文獻。探索這些加速 diffusion 取樣的技術是第 9 章(B24–B27)的主題。
II. 用 PF-ODE 反演。如前所述,和 SDE 不同,同一條 PF-ODE 可以往前(從 0 到 \(T\))也可以倒著(從 \(T\) 到 0)解。往前解時,ODE 流把資料映射到所有 \(t\in[0,T]\) 上的(帶雜訊的)潛在表示,扮演 encoder 的角色。這個概念讓可控生成有強大的應用,例如影像轉換、編輯等等(Mokady et al. 2023;Su et al. 2022)。
III. 用 PF-ODE 計算 log 概似。PF-ODE 也讓我們能計算資料樣本的概似。回想(§5.1,B11):對 ODE,log 密度沿軌跡的變化由速度場的散度決定。對學到的 PF-ODE,定義
$$\mathbf v_{\bm\phi^\times}(\mathbf x,t):=\mathbf f(\mathbf x,t)-\frac12g^2(t)\,\mathbf s_{\bm\phi^\times}(\mathbf x,t).$$若 \(\mathbf x(t)\) 依 \(\frac{d}{dt}\mathbf x(t)=\mathbf v_{\bm\phi^\times}(\mathbf x(t),t)\) 演化,它的 log 密度滿足
$$\frac{d}{dt}\log p^{\text{ODE}}_{\bm\phi^\times}(\mathbf x(t);t)=-\nabla_{\mathbf x}\cdot\mathbf v_{\bm\phi^\times}(\mathbf x(t),t).$$為什麼是負的散度(轉述者補充,正式推導在 B11)
密度沿 ODE 滿足連續方程 \(\partial_tp=-\nabla\cdot(\mathbf vp)=-p\,\nabla\cdot\mathbf v-\mathbf v\cdot\nabla p\)。沿著一條軌跡 \(\mathbf x(t)\) 對 \(p(\mathbf x(t),t)\) 求全導數(連鎖律):
$$\frac{d}{dt}p(\mathbf x(t),t)=\partial_tp+\nabla p\cdot\frac{d\mathbf x}{dt}=\partial_tp+\nabla p\cdot\mathbf v=-p\,\nabla\cdot\mathbf v.$$除以 \(p\) 就是 \(\frac{d}{dt}\log p=-\nabla\cdot\mathbf v\)。直覺:速度場往外散開的地方(散度為正),一小團粒子的體積變大,密度就下降。
要計算一個觀測樣本 \(\mathbf x_0\) 的概似,就把 PF-ODE 從 \(t=0\) 往前跑到 \(t=T\),把 \(\mathbf x_0\) 映射到一個終點,那裡的模型密度是好處理的先驗。同時追蹤 log 密度的變化,定義
$$\delta(t):=\log p^{\text{ODE}}_{\bm\phi^\times}(\mathbf x(t);t)-\log p^{\text{ODE}}_{\bm\phi^\times}(\mathbf x_0;0).$$於是 \(\delta(0)=0\),狀態和 log 密度的變化可以一起計算:
$$\frac{d}{dt}\begin{bmatrix}\mathbf x(t)\\\delta(t)\end{bmatrix}=\begin{bmatrix}\mathbf v_{\bm\phi^\times}(\mathbf x(t),t)\\-\nabla_{\mathbf x}\cdot\mathbf v_{\bm\phi^\times}(\mathbf x(t),t)\end{bmatrix},\qquad\begin{bmatrix}\mathbf x(0)\\\delta(0)\end{bmatrix}=\begin{bmatrix}\mathbf x_0\\0\end{bmatrix}.$$積分到 \(t=T\) 之後,終點的密度是 \(p_{\text{prior}}(\mathbf x(T))\),因此
$$\log p^{\text{ODE}}_{\bm\phi^\times}(\mathbf x_0;0)=\log p_{\text{prior}}(\mathbf x(T))-\delta(T)=\log p_{\text{prior}}(\mathbf x(T))+\int_0^T\nabla_{\mathbf x}\cdot\mathbf v_{\bm\phi^\times}(\mathbf x(t),t)\,dt.$$所以同一條用來生成和反演的 PF-ODE,也提供了計算概似的連續變數變換公式。
高維時散度怎麼算
Demo BPF-ODE 的反演與概似(精確 score)轉述者補充
資料和 B08 的 Demo C 相同:\(0.6\,\mathcal N(1.2,0.25^2)+0.4\,\mathcal N(-1,0.2^2)\),VP SDE,\(t\) 從 0.001 到 1。這裡用精確的 score,所以看到的是 PF-ODE 本身和 Euler 離散化的行為。選一個資料點 \(x_0\):往前跑 PF-ODE 得到 \(x_T\)(編碼),同時積分散度得到 \(\log p\);再從 \(x_T\) 倒著跑回來(解碼),看能不能還原 \(x_0\)。
瀏覽器實測(精確 score):
| \(x_0\) | 真正的 \(\log p\) | \(N=20\) | \(N=100\) | \(N=1000\) | \(N=1000\) 的反演誤差 |
|---|---|---|---|---|---|
| \(-1.0\) | \(-0.227\) | \(-0.229\) | \(-0.217\) | \(-0.224\) | 0.000 |
| \(-0.6\) | \(-2.221\) | \(-1.487\) | \(-2.063\) | \(-2.205\) | 0.000 |
| 0.0 | \(-11.269\) | \(-7.936\) | \(-11.322\) | \(-11.278\) | 0.312 |
| 0.8 | \(-1.322\) | \(-0.889\) | \(-1.228\) | \(-1.312\) | 0.000 |
| 1.2 | \(-0.044\) | \(-0.041\) | \(-0.039\) | \(-0.045\) | 0.001 |
| 1.6 | \(-1.323\) | \(-1.171\) | \(-1.294\) | \(-1.323\) | 0.001 |
- 概似的公式是對的:\(N=1000\) 時,PF-ODE 算出的 \(\log p\) 和真值相差都在 0.02 以內,連密度只有 \(e^{-11}\) 的 \(x_0=0\) 也是(\(-11.278\) 對 \(-11.269\))。步數少時誤差主要來自 Euler 法:\(N=20\) 在峰的邊緣差到 0.4–0.7。
- 反演大多時候是對的:從 \(x_0\) 編碼、再解碼回來,\(N=1000\) 時誤差在 0.001 以下。軌跡圖的灰線可以看到 PF-ODE 的流:每條線都平滑,而且互不交叉,所以一維時 \(x_0\) 的順序在 \(x_T\) 被保留下來(\(x_0=-1,-0.6,0,0.8\) 對應 \(x_T=-0.84,-0.28,-0.25,-0.17\))。
- 但分水嶺上會出事:\(x_0=0\) 在兩團之間,編碼到 \(x_T=-0.25\),和 \(x_0=-0.6\) 的 \(x_T=-0.28\) 只差 0.03:整段低密度區被壓成很窄的一條。倒著走時,這一點點寬度要被重新拉開,Euler 的誤差也被放大,所以 \(N=1000\) 還差 0.31(\(N=20\) 差 0.54)。連續的 flow map 是雙射,數值上的反演卻在低密度區最不穩定。
Demo C訓練一個 score SDE,再用它取樣、算概似轉述者補充
同樣的資料和 VP SDE。網路照第 4 節的補充寫成 \(s_{\bm\phi}(x,t)=-\epsilon_{\bm\phi}(x,t)/\sqrt{P(t)}\),用連續時間的 \(\mathcal L_{\text{simple}}\)(\(t\) 從 \([0.001,1]\) 均勻抽)訓練:兩層、每層 48 個神經元的 MLP,輸入 \(x\)、\(t\) 的幾個特徵和 \(x\) 的 Fourier 特徵,3,000 步、batch 128。訓練完用 500 步的 Euler–Maruyama(反向 SDE)和 500 步的 Euler(PF-ODE)各取 2,000 個樣本,再用 PF-ODE 算 200 個資料點的平均 log 概似,和真正的 \(\log p_{\text{data}}\) 比較。
瀏覽器實測(固定種子,全部約 6 秒):
- 取樣:上團的比例,反向 SDE 62.0%、PF-ODE 60.5%(真值 60%)。直方圖裡兩種方法都抓到兩團,位置和寬度都接近 \(p_{\text{data}}\)。
- score:拖動 \(t\) 看學到的 score。\(t\) 小時(例如 0.05),真正的 score 在兩團之間有一段很陡的上升,學到的曲線比較平緩;\(t\) 大時兩者幾乎重合。
- 概似:200 個資料點的平均 \(\log p\),學到的模型是 \(-0.765\),真值 \(-0.605\);用精確 score 走同樣的 200 步 PF-ODE 是 \(-0.589\)(差 0.016,是 Euler 的誤差)。所以學到的模型比真正的分佈差了約 0.16 nats,這個差距是 \(\mathrm{KL}(p_{\text{data}}\Vert p_{\text{model}})\) 的蒙地卡羅估計(200 個點,有抽樣誤差)。逐點看,\(x_0=0\) 時模型給 \(-5.84\)、真值 \(-11.27\):模型在兩團之間放了太多密度,又是低密度區學不準。