DPM-Solver++ 與 ParaDiGMS:換成乾淨資料預測,以及把取樣攤到平行硬體上
guidance 強度一大,模型輸出和它的導數都被放大,高階的雜訊預測解法很容易不穩定。DPM-Solver++ 保留 log-SNR 時鐘,但改用乾淨資料預測寫 PF-ODE 的精確解,再給出兩個二階版本:單步的 2S 在這一步內多算一次模型,多步的 2M 重用前兩步的預測(每步只要一次新計算),而 2M 在去掉一個係數簡化之前,恰好就是把 DEIS 的一次外插用在資料預測和 \(\lambda\) 上。最後的選讀一節換一個方向:ParaDiGMS 不改變數值格式,而是把「一步接一步」的計算改成對整條軌跡做 Picard 不動點迭代,用更多的平行計算換更少的循序回合。這一頁也收尾第 9 章。
讀完這頁你應該能夠
- 說明 DPM-Solver++ 要解決的兩個強 guidance 問題,並推出資料預測形式的精確解。
- 寫出 DPM-Solver++(2S) 和 (2M) 的更新,說明二階資訊各從哪裡來,以及 2M 的係數簡化為什麼不影響二階。
- 說明 2M 在什麼意義下是 AB-DEIS-1 在資料預測與 log-SNR 下的對應。
- 把 PF-ODE 的解寫成不動點,說明 ParaDiGMS 的離散 Picard 更新與滑動視窗,以及它和循序解法的關係。
前置知識
- B26:log-SNR \(\lambda=\log(\alpha/\sigma)\)、雜訊預測的指數加權精確解、\(\varphi_m\) 函數、DPM-Solver-2、DEIS 的 Lagrange 外插。這一頁是它的對偶版本。
- B25:DDIM 的資料預測形式 \(\frac{\sigma_t}{\sigma_s}\mathbf x_s+\alpha_s(\frac{\alpha_t}{\alpha_s}-\frac{\sigma_t}{\sigma_s})\hat{\mathbf x}_0\)。
- B21:classifier-free guidance 與大 \(\omega\) 的副作用;B24 第 2 節的補充框有 Picard 迭代的一句話介紹。
「書 §」標出原文位置。灰框「轉述者補充」是書裡沒有的內容;藍框「推導」展開書中省略的步驟。
01為什麼需要 DPM-Solver++書 §9.5.1
DPM-Solver++(Lu et al. 2022)是為了改善強 guidance 下的高階取樣而發展的。在這個情況下有兩個實際的困難:
- 大的 guidance 尺度會放大模型輸出和它的導數,讓高階解法的收斂區域變窄,需要更小的數值步。
- 被引導的預測可能把最終的解推到訓練資料所代表的範圍之外,造成第 8 章(B21)討論的訓練–測試不一致。
DPM-Solver++ 用兩個互補的方式處理:它用資料預測改寫 diffusion ODE,這樣可以套用 dynamic thresholding 之類資料空間的修正;它也發展一個多步的版本,重用前幾步的模型計算,在固定的 NFE 預算下得到更小的有效步長。書先推出資料預測的表述,再介紹它的單步和多步二階解法。
dynamic thresholding 是什麼(轉述者補充)
影像的像素值在訓練資料裡落在固定範圍(例如 \([-1,1]\))。強 guidance 下預測的 \(\hat{\mathbf x}_0\) 可能大幅超出這個範圍,畫面就過飽和。Dynamic thresholding(Saharia et al. 2022,Imagen)在每一步取 \(\hat{\mathbf x}_0\) 絕對值的某個分位數 \(s\),裁剪到 \([-s,s]\) 再除以 \(s\),把值拉回範圍內。這只有在解法直接處理 \(\hat{\mathbf x}_0\) 時才自然,所以資料預測形式方便套用它。書在 Remark 裡提醒:thresholding 是對模型輸出的額外修改,要和數值階數的分析分開看;Demo A 沒有用它。
02資料預測形式的精確解書 §9.5.2
DPM-Solver++ 保留 DPM-Solver 的 log-SNR 座標 \(\lambda\),但用資料預測而不是雜訊預測表示 empirical PF-ODE。由 B16 的換算 \(\bm\epsilon_{\bm\phi^\times}(\mathbf x_t,t)=\frac{\mathbf x_t-\alpha_t\mathbf x_{\bm\phi^\times}(\mathbf x_t,t)}{\sigma_t}\),代入 B26 雜訊預測的精確解,得到等價的資料預測形式:
其中依 B26 的記號,\(\lambda\) 參數化的資料預測場定義為 \(\hat{\mathbf x}_{\bm\phi^\times}(\mathbf x,\lambda):=\mathbf x_{\bm\phi^\times}(\mathbf x,t_\lambda(\lambda))\),所以沿 empirical PF-ODE 軌跡 \(\hat{\mathbf x}_{\bm\phi^\times}(\hat{\mathbf x}_\lambda,\lambda)=\mathbf x_{\bm\phi^\times}(\mathbf x_{t_\lambda(\lambda)},t_\lambda(\lambda))\)。
從 \(\lambda\) 時間的 ODE 推出來
B26 的 \(\lambda\) 時間 PF-ODE 是 \(\frac{d\hat{\mathbf x}}{d\lambda}=\frac{d\log\alpha_\lambda}{d\lambda}\hat{\mathbf x}-\sigma_\lambda\hat{\bm\epsilon}\)。代入 \(\hat{\bm\epsilon}=(\hat{\mathbf x}-\alpha_\lambda\hat{\mathbf x}_{\bm\phi^\times})/\sigma_\lambda\):
$$\frac{d\hat{\mathbf x}}{d\lambda}=\Big(\frac{d\log\alpha_\lambda}{d\lambda}-1\Big)\hat{\mathbf x}+\alpha_\lambda\hat{\mathbf x}_{\bm\phi^\times}=\frac{d\log\sigma_\lambda}{d\lambda}\hat{\mathbf x}+\alpha_\lambda\hat{\mathbf x}_{\bm\phi^\times},$$因為 \(\lambda=\log\alpha-\log\sigma\),所以 \(\frac{d\log\sigma}{d\lambda}=\frac{d\log\alpha}{d\lambda}-1\)。線性部分的積分因子是 \(\sigma_t/\sigma_s\),變數常數變易給出 \(\frac{\sigma_t}{\sigma_s}\mathbf x_s+\int_{\lambda_s}^{\lambda_t}\frac{\sigma_t}{\sigma_\lambda}\alpha_\lambda\hat{\mathbf x}_{\bm\phi^\times}d\lambda\),再用 \(\alpha_\lambda/\sigma_\lambda=e^\lambda\)。和 B26 的雜訊形式比較:權重從 \(e^{-\lambda}\) 變成 \(e^{\lambda}\),前面的係數從 \(\alpha\) 變成 \(\sigma\),兩者完全對偶。
所以結構和 DPM-Solver 完全對偶:已知的、依賴時程的演化解析處理,剩下積分裡唯一依賴模型的量現在是資料預測。DPM-Solver++ 對這個精確形式給出兩個二階的實現:
- 單步解法 DPM-Solver++(2S):在這一步內的一個中間階段多做一次模型計算,類似 DPM-Solver-2 的分段建構。
- 多步解法 DPM-Solver++(2M):重用前兩個已完成步驟的資料預測。暖啟動之後,每步只需要一次新的模型計算。
03單步:DPM-Solver++(2S)書 §9.5.3
依照 B26 的 DPM-Solver 建構,DPM-Solver++ 用 log-SNR 時間的局部 Taylor 展開,近似沿 empirical 軌跡的資料預測。對 \(k\ge0\),記它沿 empirical PF-ODE 軌跡的第 \(k\) 階全導數為 \(\hat{\mathbf x}^{(k)}_{\bm\phi^\times}(\hat{\mathbf x}_\lambda,\lambda):=\frac{d^k}{d\lambda^k}\hat{\mathbf x}_{\bm\phi^\times}(\hat{\mathbf x}_\lambda,\lambda)\)。對從 \(t_{i-1}\) 到 \(t_i\) 的一步,在 \(\lambda_{t_{i-1}}\) 附近 Taylor 展開,代入精確解得到
\(\varphi_m\) 是 B26 定義的函數。這裡用了 \(\int_{\lambda_{t_{i-1}}}^{\lambda_{t_i}}e^\lambda\frac{(\lambda-\lambda_{t_{i-1}})^k}{k!}d\lambda=e^{\lambda_{t_i}}h_i^{k+1}\varphi_{k+1}(-h_i)\),以及 \(\sigma_{t_i}e^{\lambda_{t_i}}=\alpha_{t_i}\)。
那個積分恆等式
令 \(h=\lambda_{t_i}-\lambda_{t_{i-1}}\)、\(u=\lambda-\lambda_{t_{i-1}}\),再令 \(w=h-u\):
$$\int_{\lambda_{t_{i-1}}}^{\lambda_{t_i}}e^\lambda\frac{(\lambda-\lambda_{t_{i-1}})^k}{k!}d\lambda=e^{\lambda_{t_i}}\int_0^he^{-w}\frac{(h-w)^k}{k!}dw.$$右邊的積分正是 \(f(w)=e^{-w}\) 在 0 附近 Taylor 展開到 \(k\) 次的積分形式餘項:\(e^{-h}=\sum_{j=0}^k\frac{(-h)^j}{j!}+\int_0^hf^{(k+1)}(w)\frac{(h-w)^k}{k!}dw\),而 \(f^{(k+1)}=(-1)^{k+1}e^{-w}\)。所以
$$\int_0^he^{-w}\frac{(h-w)^k}{k!}dw=(-1)^{k+1}\Big(e^{-h}-\sum_{j=0}^k\frac{(-h)^j}{j!}\Big)=h^{k+1}\varphi_{k+1}(-h),$$最後一步是 B26 的 \(\varphi_{k+1}\) 定義代入 \(-h\)。檢查 \(k=0\):兩邊都是 \(1-e^{-h}\),乘上 \(\sigma_{t_i}e^{\lambda_{t_i}}=\alpha_{t_i}\) 就是下面 \(n=1\) 的係數。
\(n=1\):丟掉 \(\mathcal O(h_i^2)\) 的餘項得到
$$\tilde{\mathbf x}_{t_i}=\frac{\sigma_{t_i}}{\sigma_{t_{i-1}}}\tilde{\mathbf x}_{t_{i-1}}+\alpha_{t_i}\big(1-e^{-h_i}\big)\mathbf D_{i-1},\qquad\mathbf D_{i-1}:=\mathbf x_{\bm\phi^\times}(\tilde{\mathbf x}_{t_{i-1}},t_{i-1}),$$恰好是資料預測形式的確定性 DDIM 更新。(檢查:\(\alpha_t(1-e^{-h})=\alpha_t-\alpha_t\frac{\sigma_t\alpha_s}{\alpha_t\sigma_s}=\alpha_s(\frac{\alpha_t}{\alpha_s}-\frac{\sigma_t}{\sigma_s})\),就是 B25 的係數。)
\(n=2\):第一階全導數用一個額外的步內階段近似。中點選擇下定義 \(s_i^{\text{mid}}:=t_\lambda(\lambda_{t_{i-1}}+\frac{h_i}{2})\)。一階的 DPM-Solver++ 步預測中點狀態
$$\mathbf u_i=\frac{\sigma_{s_i^{\text{mid}}}}{\sigma_{t_{i-1}}}\tilde{\mathbf x}_{t_{i-1}}+\alpha_{s_i^{\text{mid}}}\big(1-e^{-h_i/2}\big)\mathbf D_{i-1},$$在那裡計算 \(\mathbf D_i^{\text{mid}}:=\mathbf x_{\bm\phi^\times}(\mathbf u_i,s_i^{\text{mid}})\)。中點的 DPM-Solver++(2S) 更新就有特別簡單的形式
$$\tilde{\mathbf x}_{t_i}=\frac{\sigma_{t_i}}{\sigma_{t_{i-1}}}\tilde{\mathbf x}_{t_{i-1}}+\alpha_{t_i}\big(1-e^{-h_i}\big)\mathbf D_i^{\text{mid}}.$$和中點 DPM-Solver-2 一樣,這個簡化的兩階段更新和直接的二階 Taylor/有限差分建構只差 \(\mathcal O(h_i^3)\),所以保有二階精度(推導和 B26 的推導框相同,只是 \(\varphi\) 的引數換號)。這就是單步的 DPM-Solver++:\(n=1\) 時恰好化成資料預測形式的確定性 DDIM;\(n=2\) 時,用一次額外的步內模型計算近似第一階全 \(\lambda\)-導數,得到 DPM-Solver++(2S),它是 DPM-Solver-2 的資料預測對應版本。
- \(\tilde{\mathbf x}_{t_0}\gets\mathbf x_T\);\(\lambda_{t_i}\gets\log(\alpha_{t_i}/\sigma_{t_i})\),\(i=0,\dots,M\);\(\mathbf D_0\gets\mathbf x_{\bm\phi^\times}(\tilde{\mathbf x}_{t_0},t_0)\)(存下開頭的預測)
- 對 \(i=1,\dots,M\):
- \(h_i\gets\lambda_{t_i}-\lambda_{t_{i-1}}\);\(s_i^{\text{mid}}\gets t_\lambda\big(\frac{\lambda_{t_{i-1}}+\lambda_{t_i}}2\big)\)
- \(\mathbf u_i\gets\frac{\sigma_{s_i^{\text{mid}}}}{\sigma_{t_{i-1}}}\tilde{\mathbf x}_{t_{i-1}}+\alpha_{s_i^{\text{mid}}}(1-e^{-h_i/2})\mathbf D_{i-1}\)(預測中點)
- \(\mathbf D_i^{\text{mid}}\gets\mathbf x_{\bm\phi^\times}(\mathbf u_i,s_i^{\text{mid}})\)(在中點計算)
- \(\tilde{\mathbf x}_{t_i}\gets\frac{\sigma_{t_i}}{\sigma_{t_{i-1}}}\tilde{\mathbf x}_{t_{i-1}}+\alpha_{t_i}(1-e^{-h_i})\mathbf D_i^{\text{mid}}\)
- 若 \(i\lt M\):\(\mathbf D_i\gets\mathbf x_{\bm\phi^\times}(\tilde{\mathbf x}_{t_i},t_i)\)(存給下一步)
- 回傳 \(\tilde{\mathbf x}_{t_M}\)
04多步:DPM-Solver++(2M)書 §9.5.4
DPM-Solver++(2S) 透過這一步內額外的模型計算取得二階資訊。DPM-Solver++(2M) 走另一條路:重用前幾個已完成步驟的模型預測,估計同樣的局部變化。初始化之後,每步只需要一次新的模型計算,所以同樣的 NFE 預算下可以走更多、因此更小的數值步。書說這在強 guidance 下特別有用,因為大步會降低數值穩定性。(Demo A 在一個一維例子裡檢查了這一點,結果不完全一樣,見那裡的說明。)
想法很簡單:二階展開需要目前的資料預測和它的第一階全 \(\lambda\)-導數。單步方法用一個新的步內階段估這個導數,多步方法改用模型預測最近的歷史來估。
第一步沒有歷史,所以用一階的資料預測更新初始化:\(\tilde{\mathbf x}_{t_1}=\frac{\sigma_{t_1}}{\sigma_{t_0}}\tilde{\mathbf x}_{t_0}+\alpha_{t_1}(1-e^{-h_1})\mathbf D_0\),\(\mathbf D_0:=\mathbf x_{\bm\phi^\times}(\tilde{\mathbf x}_{t_0},t_0)\),恰好是資料預測形式的確定性 DDIM。
有了兩個已完成步的預測之後(\(i\ge2\)),記 \(\mathbf D_{i-1}\)、\(\mathbf D_{i-2}\)。保留二階展開的前兩項:
$$\widetilde{\bm\Psi}_{t_{i-1}\to t_i}(\tilde{\mathbf x}_{t_{i-1}})=\frac{\sigma_{t_i}}{\sigma_{t_{i-1}}}\tilde{\mathbf x}_{t_{i-1}}+\alpha_{t_i}\big(1-e^{-h_i}\big)\mathbf D_{i-1}+\alpha_{t_i}\big(h_i-1+e^{-h_i}\big)\hat{\mathbf x}^{(1)}_{\bm\phi^\times}\big(\hat{\mathbf x}_{\lambda_{t_{i-1}}},\lambda_{t_{i-1}}\big)+\mathcal O(h_i^3).$$所以二階更新唯一還需要的量,是資料預測的第一階全 \(\lambda\)-導數。DPM-Solver++(2M) 不在新的中間階段計算模型,而是用前一個已完成步估它:
$$\hat{\mathbf x}^{(1)}_{\bm\phi^\times}\big(\hat{\mathbf x}_{\lambda_{t_{i-1}}},\lambda_{t_{i-1}}\big)\approx\frac{\mathbf D_{i-1}-\mathbf D_{i-2}}{h_{i-1}}.$$在標準平滑假設下,這個後向差分的誤差是 \(\mathcal O(h_{i-1})\)。代入二階展開、把兩個預測項合在一起:
相鄰步長的比值有界時,這個加權的多步更新有單步誤差 \(\mathcal O(h_i^3)\)。
實用的 DPM-Solver++(2M) 更新
上式已經是合法的二階多步建構。DPM-Solver++(2M) 用一個稍微簡單、保持同樣階數的係數。因為 \(\beta(h)=\frac h2+\frac{h^2}{12}+\mathcal O(h^3)\),定義步長比 \(r_i:=h_i/h_{i-1}\),把 \(\mathbf D_i^{\text{poly}}\) 換成
$$\mathbf D_i^{\text{sim}}:=\mathbf D_{i-1}+\frac{r_i}{2}\big(\mathbf D_{i-1}-\mathbf D_{i-2}\big)=\Big(1+\frac{r_i}2\Big)\mathbf D_{i-1}-\frac{r_i}2\mathbf D_{i-2}.$$\(\beta(h)\) 的展開
\(e^{-h}=1-h+\frac{h^2}2-\frac{h^3}6+\frac{h^4}{24}-\cdots\)。分子 \(h-1+e^{-h}=\frac{h^2}2-\frac{h^3}6+\frac{h^4}{24}-\cdots\),分母 \(1-e^{-h}=h-\frac{h^2}2+\frac{h^3}6-\cdots\)。相除:\(\frac h2\cdot\frac{1-\frac h3+\frac{h^2}{12}}{1-\frac h2+\frac{h^2}6}=\frac h2\big(1+\frac h6+\mathcal O(h^2)\big)=\frac h2+\frac{h^2}{12}+\mathcal O(h^3)\)。
解讀很直接:最近的兩個模型預測告訴我們資料預測正往哪個方向變,\(\mathbf D_i^{\text{sim}}\) 把這個趨勢外插到目前這一步。在同樣的平滑與步長比有界的假設下,\(\mathbf D_i^{\text{poly}}-\mathbf D_i^{\text{sim}}=\mathcal O(h_i^2)\);而 \(\alpha_{t_i}(1-e^{-h_i})=\mathcal O(h_i)\),所以這個簡化只讓狀態更新改變 \(\mathcal O(h_i^3)\)。因此它保有二階精度,給出實用的 DPM-Solver++(2M) 更新:
算出 \(\tilde{\mathbf x}_{t_i}\) 之後,在新狀態計算一次模型 \(\mathbf D_i=\mathbf x_{\bm\phi^\times}(\tilde{\mathbf x}_{t_i},t_i)\),存給下一步。所以暖啟動之後,每一步 DPM-Solver++(2M) 只需要一次新的模型計算。Demo B 量出 \(\mathbf D^{\text{poly}}-\mathbf D^{\text{sim}}\) 和兩個更新的差,在 \(h\) 減半時分別縮小 4 倍和 8 倍。
2S 和 2M 的關鍵差別在二階資訊從哪裡來:2S 從這一步內的額外階段取得,2M 回收前幾個已完成步驟的模型計算。
- \(\tilde{\mathbf x}_{t_0}\gets\mathbf x_T\);計算所有 \(\lambda_{t_i}\);\(\mathbf D_0\gets\mathbf x_{\bm\phi^\times}(\tilde{\mathbf x}_{t_0},t_0)\)
- 情形 I:暖啟動(\(i=1\))。\(h_1\gets\lambda_{t_1}-\lambda_{t_0}\);\(\tilde{\mathbf x}_{t_1}\gets\frac{\sigma_{t_1}}{\sigma_{t_0}}\tilde{\mathbf x}_{t_0}+\alpha_{t_1}(1-e^{-h_1})\mathbf D_0\)(資料預測的 DDIM);若 \(M>1\):\(\mathbf D_1\gets\mathbf x_{\bm\phi^\times}(\tilde{\mathbf x}_{t_1},t_1)\)
- 情形 II:兩步的多步更新(\(i\ge2\))。對 \(i=2,\dots,M\):
- \(h_i\gets\lambda_{t_i}-\lambda_{t_{i-1}}\);\(r_i\gets h_i/h_{i-1}\)(步長比)
- \(\mathbf D_i^{\text{sim}}\gets(1+\frac12r_i)\mathbf D_{i-1}-\frac12r_i\mathbf D_{i-2}\)
- \(\tilde{\mathbf x}_{t_i}\gets\frac{\sigma_{t_i}}{\sigma_{t_{i-1}}}\tilde{\mathbf x}_{t_{i-1}}+\alpha_{t_i}(1-e^{-h_i})\mathbf D_i^{\text{sim}}\)
- 若 \(i\lt M\):\(\mathbf D_i\gets\mathbf x_{\bm\phi^\times}(\tilde{\mathbf x}_{t_i},t_i)\)(一次新的模型呼叫,存給下一步)
- 回傳 \(\tilde{\mathbf x}_{t_M}\)
052M 和 DEIS 的關係;本節小結書 §9.5.5–9.5.6
DPM-Solver++(2M) 和 DEIS 用同一個基本的多步想法:重用前幾個已完成步驟的模型預測,近似神經預測在下一個區間怎麼變,同時讓已知的 diffusion 權重保持解析。差別在套用這個想法的表示:DEIS 較早提出,用的是原本 diffusion 時間的雜訊預測;DPM-Solver++(2M) 用的是 log-SNR 時間的資料預測。
要直接看到這個連結,可以把 DEIS 的多項式外插原則套在 DPM-Solver++ 背後的資料預測精確積分上。已知的權重 \(e^\lambda\) 已經解析處理,所以這一步唯一要近似的是 \(\lambda\mapsto\hat{\mathbf x}_{\bm\phi^\times}(\hat{\mathbf x}_\lambda,\lambda)\)。用最近存下的兩個預測 \(\mathbf D_{i-2}\)、\(\mathbf D_{i-1}\),最簡單的非常數近似是通過這兩個錨點的唯一仿射多項式。寫成 Lagrange 形式,以及在最近的錨點附近寫成後向 Newton 形式:
$$P_1(\lambda)=\frac{\lambda-\lambda_{t_{i-2}}}{h_{i-1}}\mathbf D_{i-1}-\frac{\lambda-\lambda_{t_{i-1}}}{h_{i-1}}\mathbf D_{i-2}=\mathbf D_{i-1}+\frac{\lambda-\lambda_{t_{i-1}}}{h_{i-1}}\big(\mathbf D_{i-1}-\mathbf D_{i-2}\big).$$這兩個式子是同一條仿射多項式的兩種表示,所以 Lagrange 插值和後向差分在這裡不是不同的數值近似,只是同一個兩錨點外插的兩種寫法。把它代入 DPM-Solver++ 的積分:\(\tilde{\mathbf x}^{\text{poly}}_{t_i}=\frac{\sigma_{t_i}}{\sigma_{t_{i-1}}}\tilde{\mathbf x}_{t_{i-1}}+\sigma_{t_i}\int_{\lambda_{t_{i-1}}}^{\lambda_{t_i}}e^\lambda P_1(\lambda)\,d\lambda\)。因為權重 \(e^\lambda\) 已知,需要的兩個動差可以精確算出:
$$\sigma_{t_i}\int_{\lambda_{t_{i-1}}}^{\lambda_{t_i}}e^\lambda d\lambda=\alpha_{t_i}\big(1-e^{-h_i}\big),\qquad\sigma_{t_i}\int_{\lambda_{t_{i-1}}}^{\lambda_{t_i}}e^\lambda\big(\lambda-\lambda_{t_{i-1}}\big)d\lambda=\alpha_{t_i}\big(h_i-1+e^{-h_i}\big).$$兩個動差
第一個:\(\sigma_t(e^{\lambda_t}-e^{\lambda_s})=\sigma_te^{\lambda_t}(1-e^{-h})=\alpha_t(1-e^{-h})\)。第二個:\(\int_0^hue^{\lambda_s+u}du=e^{\lambda_s}\big[(h-1)e^h+1\big]=e^{\lambda_t}\big(h-1+e^{-h}\big)\),乘上 \(\sigma_t\) 得 \(\alpha_t(h-1+e^{-h})\)。
代入這些係數,得到 \(\frac{\sigma_{t_i}}{\sigma_{t_{i-1}}}\tilde{\mathbf x}_{t_{i-1}}+\alpha_{t_i}(1-e^{-h_i})\mathbf D_{i-1}+\alpha_{t_i}(h_i-1+e^{-h_i})\frac{\mathbf D_{i-1}-\mathbf D_{i-2}}{h_{i-1}}\),也就是上一節的 \(\tilde{\mathbf x}^{\text{poly}}_{t_i}\)。
這顯示了和 DEIS 的精確連結:在實用的係數簡化之前,DPM-Solver++ 的二階多步更新,恰好就是把一次的 DEIS 外插原則套在資料預測/log-SNR 積分上得到的。在這個意義上,它是 AB-DEIS-1 在資料預測/log-SNR 下的對應。實用的 DPM-Solver++(2M) 再用首項展開 \(\beta(h_i)=\frac{h_i}2+\mathcal O(h_i^2)\) 簡化係數:\(\frac{\beta(h_i)}{h_{i-1}}=\frac{h_i}{2h_{i-1}}+\mathcal O\big(\frac{h_i^2}{h_{i-1}}\big)\)。因為 \(\mathbf D_{i-1}-\mathbf D_{i-2}=\mathcal O(h_{i-1})\),有效預測改變 \(\mathcal O\big(\frac{h_i^2}{h_{i-1}}\big)\mathcal O(h_{i-1})=\mathcal O(h_i^2)\);狀態更新裡乘上有效預測的係數是 \(\alpha_{t_i}(1-e^{-h_i})=\mathcal O(h_i)\),所以狀態更新只改變 \(\mathcal O(h_i^3)\)。因此 DPM-Solver++(2M) 和一次的加權多項式更新一般是不同的有限步公式,但在二階以內一致。
這也說明了為什麼和 DEIS 的連結只屬於 2M:2M 從過去已完成步驟的預測外插得到額外的二階資訊,2S 則從這一步內新的中間階段取得。
本節小結(書 §9.5.6)
雖然主要討論集中在 DPM-Solver 和 DPM-Solver++,把它們放到更廣的脈絡裡也有用。DPM-Solver 在雜訊預測的表述下推導,DPM-Solver++ 改用資料預測重新表述解法,在強 CFG 下可能表現得更好。DPM-Solver-v3(Zheng et al. 2023)把這個想法推得更遠:它引入更一般的模型表示,用事先算好的模型統計量選係數,以減少局部離散化誤差;在這個意義上,它把表示本身變成解法設計的一部分。
另一個相關方向是 predictor–corrector 框架。在 Score SDE 框架(B08–B10)裡,predictor 用反向時間動態的一個數值步推進樣本,corrector(通常是同一雜訊等級的 Langevin 型更新)再用 score 精煉樣本(B07)。這個「先預測、再修正」的模式也有古典的數值對應:例如 Heun 法先用 Euler 預測終點,再用平均斜率改進數值更新。UniPC(Zhao et al. 2023)之類的方法專為 diffusion 取樣發展 predictor–corrector 的建構。書不深入這些延伸,但它們說明了這一章更廣的主題:有效的 diffusion 解法結合古典數值想法和 diffusion PF-ODE 特有的結構。
Demo A強 guidance 下的高階解法轉述者補充
一維、兩類資料(\(c=0\):\(\mathcal N(-1,0.6^2)\);\(c=1\):\(\mathcal N(1,0.6^2)\),和 B21 相同),DDPM 式 VP 時程,用精確的條件與無條件 score 組成 CFG 場 \(\bm\epsilon_\omega=\bm\epsilon_\varnothing+\omega(\bm\epsilon_{c=1}-\bm\epsilon_\varnothing)\),資料預測由它精確換算(沒有 thresholding)。所有方法解的是同一條 guided PF-ODE;參考答案是 \(\lambda\) 時間的 RK4 4,000 步。200 個起點,\(\lambda\) 均勻格點,從 \(T=1\) 走到 0.002。方法:DDIM、DPM-Solver-2(雜訊預測,每步 2 NFE)、DPM-Solver++(2S)(每步 2 NFE)、DPM-Solver++(2M),以及兩個對照:未簡化係數的 2M(\(\mathbf D^{\text{poly}}\)),和轉述者自己加的「雜訊預測版 2M」(同樣的 \(\frac32,-\frac12\) 外插,但套在 \(\bm\epsilon\) 上)。
瀏覽器實測(和 Node 原型一致;每個 \(\omega\) 約 1–2 秒)。和參考解的平均誤差:
| 方法 | \(\omega=1\):6 / 10 / 20 NFE | \(\omega=4\) | \(\omega=8\) |
|---|---|---|---|
| DDIM | 0.15 / 0.093 / 0.049 | 0.22 / 0.15 / 0.070 | 0.30 / 0.22 / 0.091 |
| DPM-Solver-2 | 0.32 / 0.11 / 0.028 | 6.4 / 1.8 / 0.17 | 16 / 4.5 / 0.40 |
| DPM-Solver++(2S) | 0.13 / 0.063 / 0.020 | 0.17 / 0.088 / 0.014 | 0.40 / 0.24 / 0.048 |
| DPM-Solver++(2M) | 0.0048 / 0.014 / 0.0055 | 0.73 / 0.27 / 0.056 | 1.6 / 0.59 / 0.11 |
| 2M、\(\mathbf D^{\text{poly}}\) | 0.045 / 0.037 / 0.011 | 1.1 / 0.35 / 0.066 | 1.5 / 0.74 / 0.13 |
| 雜訊預測版 2M(對照) | 0.053 / 0.021 / 0.0057 | 0.33 / 0.097 / 0.025 | 0.71 / 0.21 / 0.052 |
(1) 書的主要論點成立。雜訊預測的 DPM-Solver-2 在強 guidance 下不穩:\(\omega=8\)、6 NFE 時誤差 16,比 DDIM 大 50 倍以上;同樣是單步二階、同樣 NFE 的 DPM-Solver++(2S) 只有 0.40,到 20 NFE 是 0.048,每個設定都比 DPM-Solver-2 好得多。換成資料預測,就把高階解法拉回穩定的範圍。(2) 沒有 guidance 時(\(\omega=1\)),2M 最好:6 NFE 的誤差 0.0048,是 DDIM 的 1/30。這個數字比 10 NFE 的 0.014 還小,誤差沒有隨 NFE 單調下降,所以有一部分是碰巧;20 NFE 時它(0.0055)只略勝雜訊預測版(0.0057)。多步法每步只花一次 NFE,同樣預算可以走兩倍的步數。(3) 但在這個例子裡,強 guidance 下 2M 反而比 2S 差(\(\omega=4\)、20 NFE:0.056 對 0.014),甚至在 6、10 NFE 時比 DDIM 還差;轉述者加的「雜訊預測版 2M」反而比資料預測的 2M 好。書說多步法在強 guidance 下「特別有用」的理由是同樣 NFE 可以走更小的步,這在這個一維例子裡沒有重現。我在 Node 裡把起點從 \(T=1\) 改成 0.7 和 0.5,排序都沒變,所以這不是起點雜訊太大造成的;確切原因這裡沒有追究,只能說是否成立取決於問題。(4) 未簡化係數的 \(\mathbf D^{\text{poly}}\) 和實用的 \(\mathbf D^{\text{sim}}\) 差不多,有時還比較差,這和「兩者只差 \(\mathcal O(h^3)\)」一致:係數簡化不是準確度的關鍵。
Demo B2M 的兩種係數轉述者補充
檢查書的兩個階數宣稱:\(\mathbf D^{\text{poly}}-\mathbf D^{\text{sim}}=\mathcal O(h^2)\),以及兩個狀態更新只差 \(\mathcal O(h^3)\)。沿 Demo A 的精確軌跡(\(\omega=1\),起點 \(x_T=0.3\)),取 \(\lambda_0\) 處的精確狀態,往回 \(h\) 取前一個錨點(也在精確軌跡上),再用兩種係數往前走一步 \(h\),和精確解比較。表格是 \(h\) 從 0.8 減半到 0.025 的結果。
瀏覽器實測:三個 \(\lambda_0\) 下,\(h\) 每減半,\(|\mathbf D^{\text{poly}}-\mathbf D^{\text{sim}}|\) 縮小的倍數趨近 4(\(\lambda_0=0\):3.6、3.8、3.9、4.0、4.0),兩個狀態更新的差趨近 8(6.5、7.5、7.8、7.9、8.0),正好是書說的 \(\mathcal O(h^2)\) 和 \(\mathcal O(h^3)\)。兩種係數的單步誤差也都按 8 倍縮小(單步 \(\mathcal O(h^3)\),對應全域二階),誰比較準則隨位置而變:\(\lambda_0=0\) 時 \(\mathbf D^{\text{poly}}\) 的誤差大約是 \(\mathbf D^{\text{sim}}\) 的一半,\(\lambda_0=2\) 時反過來 \(\mathbf D^{\text{sim}}\) 稍好。
06(選讀)ParaDiGMS:在時間上平行書 §9.6
從時間步進到時間平行的解法
前面幾節專注在時間步進的做法:從先驗時刻 \(T\) 演化到任意的 \(t\in[0,T]\) 來估計軌跡。令 \(\mathbf v_{\bm\phi^\times}(\mathbf x,t):=\mathbf f(\mathbf x,t)-\frac12g^2(t)\mathbf s_{\bm\phi^\times}(\mathbf x,t)\) 表示預訓練 diffusion model 的 empirical PF-ODE 漂移。從 \(T\) 到任意中間時刻 \(t\) 的精確演化是
$$\widetilde{\bm\Psi}_{T\to t}\big(\mathbf x(T)\big)=\mathbf x(T)+\int_T^t\mathbf v_{\bm\phi^\times}\big(\mathbf x(\tau),\tau\big)\,d\tau,\qquad\mathbf x(T)\sim p_{\text{prior}}.$$時間步進的格式用基於過去時刻的離散更新近似這個積分。這一節轉向時間平行的做法,以 ParaDiGMS(Shih et al. 2023)為例:它建立在古典的 Picard 迭代上,讓積分能在時間上平行進行。ParaDiGMS 背後的關鍵想法是用計算資源換更快的模擬。
從軌跡到 Picard 迭代:一個不動點更新
固定反向取樣的初始狀態 \(\mathbf x_T\sim p_{\text{prior}}\)。上面的積分式可以看成一個映射:吃進一整條候選軌跡、吐出一條更新過的。形式上,對任何路徑 \(\{\mathbf y(\tau)\}_{\tau\in[0,T]}\) 定義
$$\big(\mathcal L[\mathbf y(\cdot)]\big)(t)=\mathbf x_T+\int_T^t\mathbf v_{\bm\phi^\times}\big(\mathbf y(\tau),\tau\big)\,d\tau,\qquad t\in[0,T].$$也就是說,\(\mathcal L\) 固定初始狀態 \(\mathbf x_T\),用沿候選路徑計算的速度更新軌跡的其餘部分。滿足 \(\mathbf x^*(T)=\mathbf x_T\) 的 empirical PF-ODE 解軌跡 \(\mathbf x^*(\cdot)\),恰好就是這個映射的不動點:\(\mathbf x^*(t)=\mathcal L[\mathbf x^*(\cdot)](t)\)。所以不必一個時間步接一個時間步地建構軌跡,可以改成尋找一整條和這個積分方程一致的軌跡。
從一個滿足 \(\mathbf x^{(0)}(T)=\mathbf x_T\) 的初始猜測出發(例如常數路徑 \(\mathbf x^{(0)}(t)\equiv\mathbf x_T\)),Picard 迭代反覆套用這個映射:
每次迭代沿上一條軌跡計算速度,再用這些計算更新所有時間點的軌跡。
Picard 迭代為什麼會收斂(轉述者補充)
這是 Picard–Lindelöf 存在唯一性定理背後的論證。若 \(\mathbf v\) 對 \(\mathbf x\) 是 \(L\)-Lipschitz,兩條候選路徑經過 \(\mathcal L\) 之後在時刻 \(t\) 的差,最多是它們之前差的上確界乘上 \(L|T-t|\)。反覆套用 \(k\) 次,誤差界變成 \(\frac{(L|T-t|)^k}{k!}\),任何有限區間上最終都會收斂。但這個界也說明:離起點越遠(\(|T-t|\) 越大)、或漂移越陡(\(L\) 越大),需要的迭代次數越多。這就是 ParaDiGMS 要用短的滑動視窗、而不是一次對整條軌跡做 Picard 的原因之一。
在 \(T\) 到 0 的格點上做離散 Picard
為了把它變成實用的演算法,在 \([0,T]\) 上放一個均勻遞減的格點:選步數 \(M\)、令 \(\Delta t:=T/M\)、\(t_j:=T-j\Delta t\)(\(j=0,\dots,M\)),所以 \(t_0=T\)、\(t_M=0\)。記取樣的迭代值 \(\mathbf x^{(k)}_j:=\mathbf x^{(k)}(t_j)\)。因為格點在時間上反向走,從 \(T\) 到 \(t_j\) 的積分是負方向的。在分割 \(\{[t_{i+1},t_i]\}_{i=0}^{j-1}\) 上用左端點近似:
$$\int_T^{t_j}\mathbf v_{\bm\phi^\times}\big(\mathbf x^{(k)}(\tau),\tau\big)\,d\tau\approx-\Delta t\sum_{i=0}^{j-1}\mathbf v_{\bm\phi^\times}\big(\mathbf x^{(k)}_i,t_i\big),$$因為每一小段 \([t_{i+1},t_i]\) 上的積分等於 \(-\int_{t_i}^{t_{i+1}}\)。代入 Picard 迭代得到離散的 Picard 更新:
這個格式簡單又適合平行:每個漂移計算 \(\mathbf v_{\bm\phi^\times}(\mathbf x^{(k)}_i,t_i)\) 只依賴上一次迭代在同一個時間節點 \(t_i\) 的值,所以 \(i=0,\dots,j-1\) 的所有計算可以在格點上獨立地進行。積分再用累積和恢復,可以循序做,也可以用平行的 prefix sum(scan/滑動視窗)。
和 Euler 的關係(轉述者補充)
如果某一次迭代裡 \(\mathbf x^{(k)}_0,\dots,\mathbf x^{(k)}_{j-1}\) 已經等於循序 Euler 的值,那 \(\mathbf x^{(k+1)}_j=\mathbf x_T-\Delta t\sum_{i\lt j}\mathbf v(\mathbf x_i,t_i)\) 正是 Euler 走 \(j\) 步的結果。所以離散 Picard 的不動點就是循序 Euler 的軌跡,而且每次迭代至少讓「正確的前綴」多一個節點:最壞情況下 \(M\) 次迭代就精確等於 Euler,和循序一樣慢;好的情況下少得多。
滑動視窗與平行計算
離散 Picard 更新把每個 \(\mathbf x^{(k+1)}_j\) 寫成固定的初值 \(\mathbf x_T\) 減掉漂移的累積和。為了限制記憶體並利用平行硬體,把同一個想法局部地套在短的、滑動的索引區塊上比較方便。固定視窗長度 \(p\) 和左端索引 \(\ell\),視窗涵蓋 \(j=\ell,\dots,\ell+p\),\(t_\ell>t_{\ell+1}>\cdots>t_{\ell+p}\)。在第 \(k\) 次迭代:
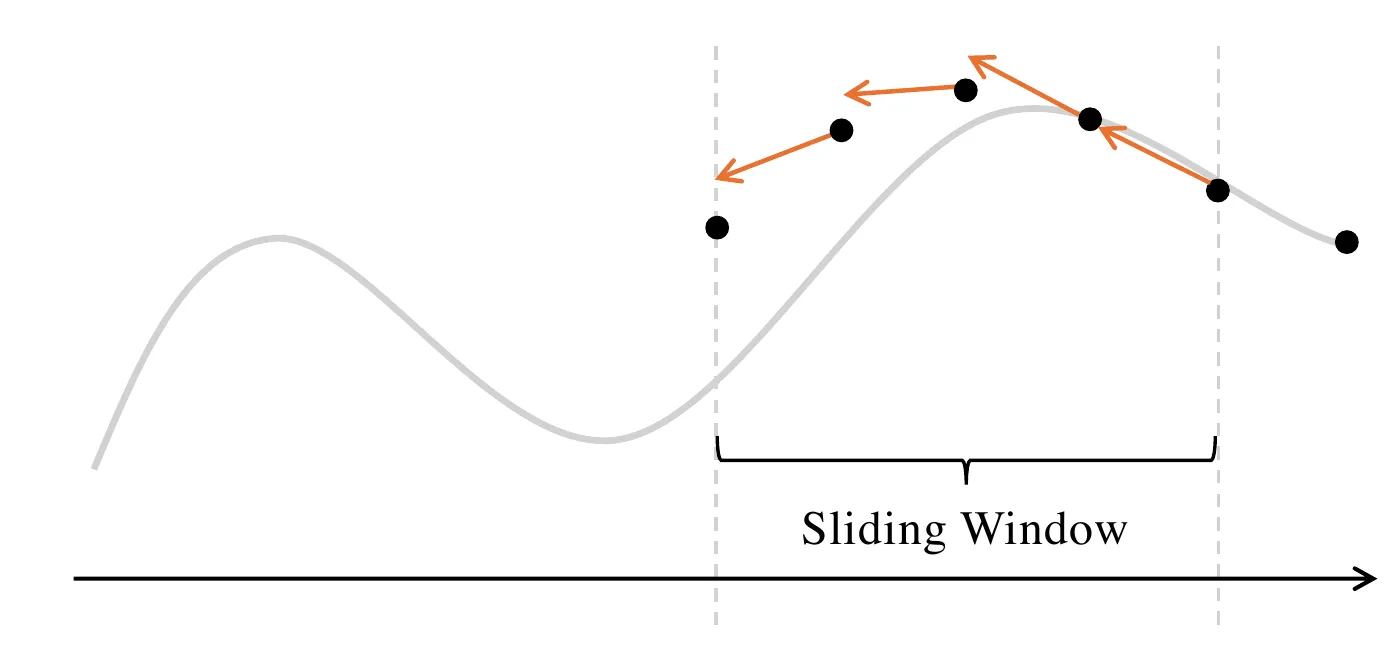
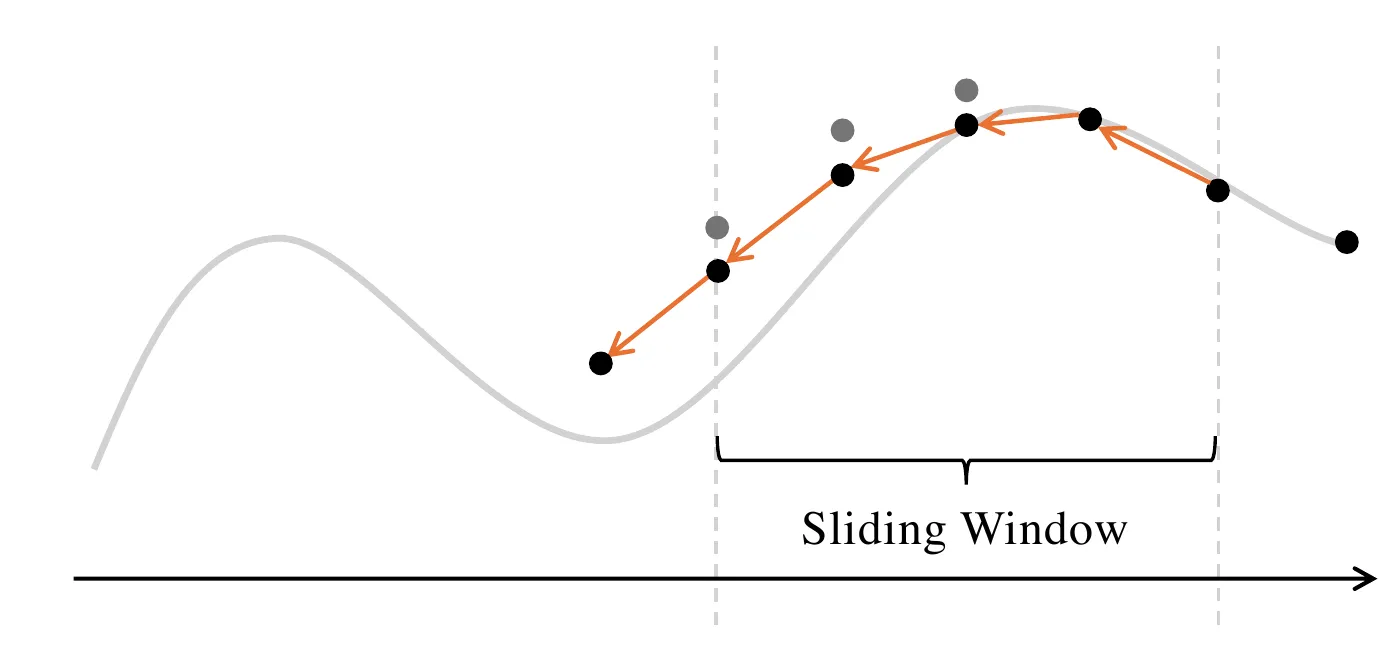
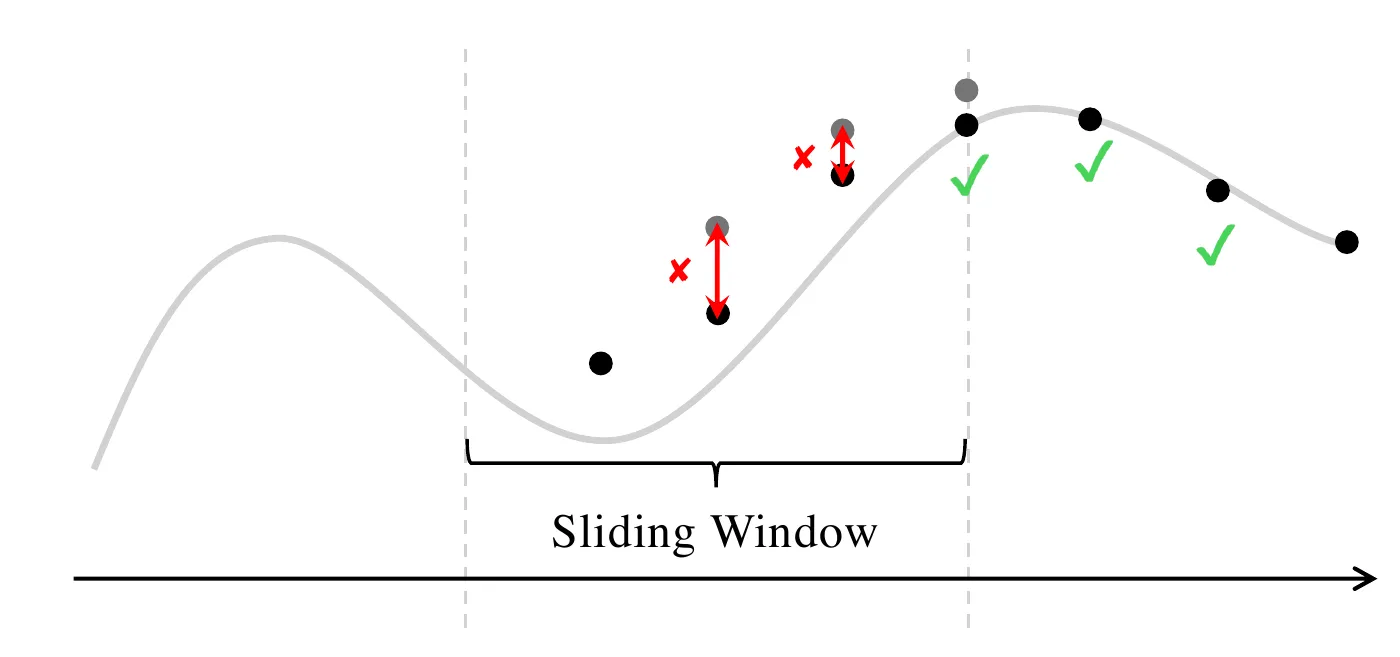
書中的三張圖(§9.6.2)。每張圖下方都有一條指向右的時間軸,灰色曲線是軌跡,兩條虛線之間的括號標著 Sliding Window。圖 1:視窗右端的黑點落在灰色曲線上,橘色箭頭從它開始一路往左串過視窗裡的四個黑點,這些點大多離開了灰色曲線,書的圖說是「在大小 \(p=4\) 的批次視窗上平行計算 \(\mathbf x^{(k)}_{\ell:\ell+p}\) 的漂移」。圖 2:灰點是舊的值,黑點是更新後的值,新的點比較貼近灰色曲線,橘色箭頭表示從視窗左端錨點累積上去;圖說是「用視窗內各點的累積漂移把值更新成 \(\mathbf x^{(k+1)}_{\ell:\ell+p}\)」。圖 3:視窗已經往左滑;右邊幾個點旁有綠色的勾(已收斂),視窗裡兩個點有紅色的叉,紅色箭頭標出新舊值的差;圖說是「依誤差 \(\|\mathbf x^{(k+1)}_i-\mathbf x^{(k)}_i\|^2\) 決定視窗往前滑多遠」。(這三張圖的時間軸箭頭指向右,取樣方向是從右往左。)圖片改編自 Shih et al. (2023)。
步驟 1:在視窗上平行計算漂移。只用上一次迭代的值,平行地計算 \(\mathbf v_{\bm\phi^\times}(\mathbf x^{(k)}_{\ell+i},t_{\ell+i})\),\(i=0,1,\dots,p-1\)。這是從左邊界 \(t_\ell\) 穿過視窗所需的 \(p\) 個局部增量。
步驟 2:以左端為錨的累積更新。以 \(j=\ell\) 為錨,累積子區間上的漂移:
$$\mathbf x^{(k+1)}_{\ell+j+1}=\mathbf x^{(k)}_\ell-\Delta t\sum_{i=0}^j\mathbf v_{\bm\phi^\times}\big(\mathbf x^{(k)}_{\ell+i},t_{\ell+i}\big),\qquad j=0,1,\dots,p-1.$$這是離散 Picard 更新的局部、加視窗版本,以目前的左邊界值 \(\mathbf x^{(k)}_\ell\) 當視窗的錨。負號反映時間遞減的方向。內層的和是視窗內漂移的 prefix sum,所以所有部分和都能在平行硬體上有效率地算出。
步驟 3:進度控制與視窗前進。用逐點的 Picard 變化量 \(\mathtt{error}_j:=\|\mathbf x^{(k+1)}_{\ell+j}-\mathbf x^{(k)}_{\ell+j}\|^2\)(\(j=1,\dots,p-1\))衡量局部收斂,和事先規定的容許值 \(\mathtt{tol}_{\ell+j}\) 比較。\(\mathtt{error}_j\) 衡量節點 \(\ell+j\) 的值在上一次 Picard 更新裡改變了多少:數值小,表示兩次相繼的近似在這裡一致,也就是不動點迭代在這個節點局部收斂了;數值大,表示這個節點還沒穩定,需要更多 Picard 平滑。步幅取成視窗裡第一個沒通過測試的索引(全部通過就取整個視窗長度 \(p\)):
$$\mathtt{stride}:=\min\Big(\{\,j\ge1:\ \mathtt{error}_j>\mathtt{tol}_{\ell+j}\,\}\cup\{p\}\Big),$$再把視窗滑動 \(\ell\leftarrow\ell+\mathtt{stride}\)。白話:接受從左邊界到(不含)第一個還沒收斂的節點;全部收斂就接受整個視窗,然後滑過那麼多個被接受的節點。每次最多前進視窗長度 \(p\),絕不跳過還沒達到容許值的節點。如果滑動會超出格點的終點 \(M\),就把視窗截短成 \(p\leftarrow\min\{p,M-\ell\}\) 繼續。
視窗往前移時會露出還沒有值的新時間節點。要在那裡開始 Picard 迭代,就直接複製視窗左邊界的值當初始猜測。這個「常數外插」便宜又穩定,之後的更新會修正它;需要的話也可以換成更準的猜測,例如從過去的點做線性或多項式外插。
- \(k\gets0\)、\(\ell\gets0\);抽 \(\mathbf x^{(0)}_0\sim p_{\text{prior}}\);\(\mathbf x^{(0)}_j\gets\mathbf x^{(0)}_0\),\(j=1,\dots,\min(p,M)\)(常數外插)
- 當 \(\ell\lt M\):
- \(J\gets\min(p,M-\ell)\)(目前的視窗長度)
- 步驟 1(平行):對 \(i=0,\dots,J-1\):\(\mathbf g_i\gets\mathbf v_{\bm\phi^\times}(\mathbf x^{(k)}_{\ell+i},t_{\ell+i})\)(用上一次迭代的值);prefix sum \(\mathbf S_j\gets\sum_{i=0}^j\mathbf g_i\)
- 步驟 2(累積更新):對 \(j=0,\dots,J-1\):\(\mathbf x^{(k+1)}_{\ell+j+1}\gets\mathbf x^{(k)}_\ell-\Delta t\,\mathbf S_j\)
- 步驟 3(進度控制與視窗前進):對 \(j=1,\dots,J-1\):\(\mathtt{error}_j\gets\|\mathbf x^{(k+1)}_{\ell+j}-\mathbf x^{(k)}_{\ell+j}\|^2\);\(\mathtt{stride}\gets\min\big(\{j\in\{1,\dots,J-1\}:\mathtt{error}_j>\mathtt{tol}_{\ell+j}\}\cup\{J\}\big)\)
- 初始化新節點:對 \(r=1,\dots,\min\{\mathtt{stride},M-\ell-J\}\):\(\mathbf x^{(k+1)}_{\ell+J+r}\gets\mathbf x^{(k+1)}_{\ell+J}\)(常數外插)
- \(\ell\gets\ell+\mathtt{stride}\);\(k\gets k+1\)
- 回傳 \(\{\mathbf x^{(k)}_j\}_{j=0}^M\)
和時間步進解法的關係
滑動視窗大小的選擇。先看最小的選擇 \(p=1\):沒有時間平行,方法化成它的循序基本更新;對左端點離散化,這就是一般的 Euler 步。更一般地,ParaDiGMS 規定的是不同時間點的計算怎麼平行,每一步用的數值更新可以另外選。例如把 Euler 更新換成 DDIM 或 DPM-Solver,就得到 ParaDDIM 或 ParaDPMSolver。增大 \(p\) 讓更多時間點暴露給平行計算,而不改變底層的時間格點或總步數 \(M\)。Picard 迭代反覆把這些狀態修正到和選定的基本解法一致,收斂由規定的局部容許值控制。
和高階解法(例如 DPM)的相容性。Picard 框架決定不同時間點的狀態怎麼平行地更新和計算,近似每一步的數值規則可以另外選。例如不用左端點規則,改用梯形規則:
$$\mathbf x^{(k+1)}_{\ell+j+1}=\mathbf x^{(k)}_\ell-\Delta t\Big[\tfrac12\mathbf v_{\bm\phi^\times}\big(\mathbf x^{(k)}_\ell,t_\ell\big)+\sum_{i=1}^j\mathbf v_{\bm\phi^\times}\big(\mathbf x^{(k)}_{\ell+i},t_{\ell+i}\big)+\tfrac12\mathbf v_{\bm\phi^\times}\big(\mathbf x^{(k)}_{\ell+j+1},t_{\ell+j+1}\big)\Big],\qquad j=0,\dots,p-1.$$\(j=0\) 時這就是熟悉的、用兩個端點漂移的單步梯形更新;\(j\) 更大時,同一個規則把梯形的貢獻累積過整個視窗。因為所有漂移都用上一次 Picard 迭代的值計算,它們仍然可以平行地算,內部的貢獻可以用 prefix sum 累加。更一般地,ParaDiGMS 可以用現有的循序取樣器(例如 DDIM 或 DPM-Solver)當基本離散化;那時 Picard 更新由對應的基本解法增量建構,而不是上面的梯形公式。精確的形式取決於選的解法,因為高階方法可能用中間階段或前幾步的模型計算。
對建立在某個循序解法上的 ParaDiGMS,精確的不動點收斂會還原對應的循序離散軌跡。在有限的停止容許值下,最終結果除了基本解法的離散化誤差之外,還多了一個剩餘的不動點迭代誤差。
Demo CPicard 滑動視窗轉述者補充
一維資料 \(0.5\,\mathcal N(-1,0.2^2)+0.5\,\mathcal N(1,0.2^2)\),DDPM 式 VP,精確的漂移;格點 \(M=100\)、\(t\) 均勻,從 1 到 0.002;基本解法是 Euler(左端點規則),完全照上面的演算法。按「下一輪」一次走一次 Picard 迭代(一輪 = 視窗內的漂移平行算一次),或按「跑完」。圖上:灰線是循序 Euler 的軌跡(不動點),藍點是目前的迭代值,淡色區域是目前的視窗。
瀏覽器實測(\(x_T=0.3\)、tol \(=10^{-6}\)):
| 視窗長度 \(p\) | 1 | 4 | 8 | 16 | 32 |
|---|---|---|---|---|---|
| Picard 回合數(循序的時間) | 100 | 33 | 19 | 12 | 9 |
| 漂移計算總數(總工作量) | 100 | 129 | 146 | 160 | 185 |
| 終點和循序 Euler 的差 | 0 | \(4.0\times10^{-5}\) | \(2.3\times10^{-5}\) | \(3.9\times10^{-5}\) | \(3.0\times10^{-6}\) |
Node 原型對 50 個起點的平均(回合數 / 漂移計算數 / 終點最大差):tol \(=10^{-4}\) 時 \(p=16\) 是 9.6 / 134 / 0.046;tol \(=10^{-6}\) 時 11.5 / 163 / 0.0043;tol \(=10^{-8}\) 時 13.9 / 194 / 0.00035。最大差取決於有沒有抽到 \(x_T\) 很接近 0、軌跡快要分岔的起點:在瀏覽器掃 \(-2\) 到 2、間隔 0.05 的 81 個起點,回合數和漂移計算數幾乎相同(9.6 / 135、11.5 / 163、13.9 / 194),最大差則是 0.0048、0.00041、\(4\times10^{-5}\),都出現在 \(x_T=-0.05\)。
(1) 用計算換時間。\(p=16\) 時只要 12 個循序回合(每回合裡的 16 個漂移可以同時算),是循序 Euler 的 1/8;代價是總計算從 100 次增加到 160 次。\(p\) 越大,回合越少、總計算越多。(2) \(p=1\) 就是循序 Euler:100 回合、終點完全相同,和書說的一致。(3) 容許值控制的是不動點誤差:tol 從 \(10^{-4}\) 降到 \(10^{-8}\),終點和循序 Euler 的最大差從 0.046 降到 0.00035,回合數只多了幾個。這個差是在 Euler 本身的離散化誤差之外另加的,和書最後一段說的一樣。按「下一輪」可以逐回合看視窗的位置和每回合接受的節點數(步幅)。
07第 9 章結語書 §9.7
這一章面對 diffusion model 最重大的實際限制之一:緩慢、反覆的取樣過程。我們探討了 training-free 的方法,透過為 empirical PF-ODE 設計更好的數值解法來加速生成:
- 從 DDIM 開始:一個一階的分解式指數積分器更新,解析保留已知的 diffusion 時程,同時固定神經預測。
- 接著研究 DEIS:它重用過去的模型計算、外插神經預測的變化,把這個想法延伸成高階多步更新。
- 最後檢視 DPM-Solver 家族:它引入 log-SNR 時間座標,從步內的模型計算建構高階更新。DPM-Solver++ 再在資料預測的表述下發展單步和多步的版本。
這些方法共同展現了一個原則:利用解析已知的 diffusion 結構,把數值近似集中在學到的模型預測上。它們的差別在預測和時間的參數化,以及高階資訊來自步內階段還是過去步驟的歷史。ParaDiGMS 提供一個互補的方向:透過不動點迭代和平行計算,重新組織跨時間的計算。這些解法的發展可以在許多實際情境裡,把取樣成本從幾百到幾千次模型計算降到只要幾十次。
但這些 training-free 方法本質上仍然是反覆的:它們數值地近似一條連續的生成軌跡,即使部分計算可以平行。這引出一個自然的問題:能不能只用一步或非常少的步數就得到高品質的生成?本書最後的 Part D 透過 training-based 的加速探討這個問題。第 10 章研究基於蒸餾的方法:讓一個快的學生生成器學會重現一個慢的預訓練老師的行為。第 11 章轉向直接從頭學習由 ODE flow 定義的少步生成器的方法。從「設計更好的數值解法」轉向「直接學生成解映射的快速近似」,目標是把 diffusion model 的品質和一步或少步生成的速度結合起來。