Normalizing flow 與 neural ODE:把密度的變數變換,從一步一步變成連續的流
第 5 章是理解 diffusion 的第三條路:flow 的觀點。起點是機率論裡最基本的變數變換公式:把簡單分佈經過一個可逆映射,就能精確算出新的密度。Normalizing flow 把很多個好算行列式的可逆層疊起來;當每層都變成很小的殘差更新、層數趨於無窮,就得到 neural ODE(連續的 normalizing flow),行列式的對數換成速度場散度的積分。這一頁走完這條路,並看到它和 B08、B09 的 PF-ODE 是同一種東西:都是「沿著一個速度場確定性地運送機率」。
讀完這頁你應該能夠
- 寫出密度的變數變換公式,用它推出 normalizing flow 的 log 概似與訓練目標,並說明為什麼要把很多「好算行列式」的層疊起來。
- 推導 planar flow 的行列式,以及 residual flow 的 log 行列式怎麼展開成 trace 的級數。
- 說明殘差層 \(\mathbf x_{k+1}=\mathbf x_k+\Delta t\,\mathbf v_{\bm\phi}\) 在層數趨於無窮時怎麼變成 neural ODE。
- 寫出並(用兩種方法)證明瞬時變數變換公式 \(\frac{d}{dt}\log p=-\nabla\cdot\mathbf v\),說明它和離散公式、連續方程、B09 的 PF-ODE 概似的關係。
- 說明 neural ODE 用最大概似訓練的代價,以及為什麼這引出了下一頁的 Flow Matching。
前置知識
- B09:PF-ODE、連續方程、用 PF-ODE 算概似(同一個公式,本頁會正式證明);B08:PF-ODE 的速度場 \(\mathbf f-\tfrac12g^2\nabla\log p_t\)。
- B06:Hutchinson 的 trace 估計。B01:最大概似估計。
- 行列式、Jacobian、矩陣的 log 與 trace、散度:CS236 補充課 A;連續方程:補充課 C。CS236 的 第 7 講、第 8 講 是 normalizing flow 的完整介紹。
「書 §」標出原文位置。灰框「轉述者補充」是書裡沒有的內容;藍框「推導」展開書中省略的步驟或附錄 D 的證明。本頁的 \(\mathbf f\) 是可逆映射(不是 B08 的 SDE 漂移),\(\mathbf v_{\bm\phi}\) 是速度場。
01第 5 章:變數變換的連續版本書 第 5 章開頭
章首引言:「萬物皆流。」(赫拉克利特)
變數變換公式是機率論的基石(Tabak & Vanden-Eijnden 2010;Tabak & Turner 2013),在現代生成建模裡有了新的生命。第 4 章看到,Fokker–Planck 方程描述擴散過程下機率密度怎麼演化,而同樣的邊際密度演化也可以透過對應的 PF-ODE 確定性地實現。這自然引出一個想法:直接從「確定性的機率運送」的角度研究生成建模。
密度的變數變換公式
給定一個可逆變換 \(\mathbf f\),\(\mathbf x=\mathbf f(\mathbf z)\)、\(\mathbf z\sim p_{\text{prior}}\) 的密度是
一維的推導(機率質量守恆)
設 \(f\) 遞增。\(x\) 落在 \([x,x+dx]\) 的機率,等於 \(z\) 落在對應區間 \([z,z+dz]\) 的機率:\(p(x)\,dx=p_{\text{prior}}(z)\,dz\),所以 \(p(x)=p_{\text{prior}}(z)\,\frac{dz}{dx}=p_{\text{prior}}(f^{-1}(x))\,(f^{-1})'(x)\)。\(f\) 遞減時區間方向反過來,取絕對值。多維時,一小塊體積經過映射會被放大 \(|\det\partial\mathbf f/\partial\mathbf z|\) 倍,密度就縮小同樣的倍數;\(|\det\partial\mathbf f^{-1}/\partial\mathbf x|=1/|\det\partial\mathbf f/\partial\mathbf z|\)。
這個看似簡單的公式,在 \(\mathbf f\) 好處理時,讓樣本和密度都能雙向運送,是 normalizing flow 的基礎(第 3 節)。但如果把這個變換放到連續時間來看,會發生什麼事?
這一章沿著這個想法,從 normalizing flow 走到 neural ODE,再走到 Flow Matching。和第 4 章的連結特別重要:在 Score SDE 裡,學到的 score 用來建構 PF-ODE 的速度場;Flow Matching 則直接學速度場。對同一條 diffusion 機率路徑,這是同一個確定性機率流的兩種觀點。這一章一個有用的心智圖像如下,兩者都依賴同一個條件化原則:
\(\nabla_{\mathbf x}\log p_t(\mathbf x\mid\mathbf x_0)\)
封閉形式
\(\nabla_{\mathbf x}\log p_t(\mathbf x)\)
算不出來
\(\mathbf v_t(\mathbf x\mid\mathbf z)\)
封閉形式
\(\mathbf v_t(\mathbf x)\)
算不出來
\(\frac{d\mathbf x(t)}{dt}=\mathbf v_t(\mathbf x(t))\),在 \(p_{\text{data}}\) 與 \(p_{\text{prior}}\) 之間運送。
Flow Matching 把這個原則推到一般的高斯 diffusion 設定之外。只要選定的條件機率路徑能有效率地取樣、它的條件速度能好處理地計算,它就能在更一般的、拿得到樣本的來源與目標分佈之間建構連續的運送。
為了幫助扎實理解這一章,書的附錄 B(B34)給了一個直覺、自成一體的概觀,介紹變數變換原理的不同形式:從普通的變數變換公式,到連續方程,再到有隨機動態時的 Fokker–Planck 方程。
書列出本章的學習目標有六項,這一章分成四頁:
- 透過「運送機率分佈」這個共同的想法,把 normalizing flow、neural ODE 和 Flow Matching 連起來:從離散的可逆變換到連續時間的速度場。(本頁)
- 認出和第 4 章 Score SDE 框架的關鍵類比:對同一條 diffusion 機率路徑,Score SDE 學的 score 決定 PF-ODE 的速度,Flow Matching 則可以直接學那個速度場;兩者都能透過好處理的條件目標學到算不出來的邊際目標。(B12)
- 理解連續方程是把 ODE 的速度場和它的機率分佈演化連起來的「密度層級規則」。(B12)
- 理解 Flow Matching 怎麼把這個條件化策略推廣到高斯 diffusion 路徑之外,在任何拿得到樣本的來源與目標分佈之間運送,同時保持靠好處理的條件路徑與速度做到的 simulation-free 訓練。(B12)
- 區分「指定的機率路徑 \(\{p_t\}_{t\in[0,1]}\)」和「用來實現它的特定速度場、耦合(coupling)與粒子軌跡」,並理解為什麼不同的流可以有相同的邊際分佈。(B12–B13)
- 理解建構好處理條件流的兩種互補方式:從條件機率路徑出發推出它的速度,或從條件 flow map 出發推出沿軌跡的速度。(B13)
書的建議:已經熟悉 normalizing flow 和 neural ODE 的讀者可以略讀 §5.1(本頁),從 §5.2.1(B12)開始。第一次讀時,專注在 Score SDE 和 Flow Matching 觀點的連結、連續方程,以及從條件速度到邊際速度的建構;詳細的路徑建構和選讀的理論性質可以之後再回來看。
02Flow-based model:normalizing flow 與 neural ODE書 §5.1
這一節介紹 flow-based model,包括 normalizing flow(NF;Rezende & Mohamed 2015)和 neural ODE(NODE;Chen et al. 2018)。NF 對簡單的基底分佈套用一串可逆變換,做到有彈性又好處理的機率密度估計。NODE 把這個框架延伸到連續時間:變換由一條 ODE 支配。把變換看成連續時間的動態,NODE 為 NF 的範式提供了平滑、可擴展的延伸。
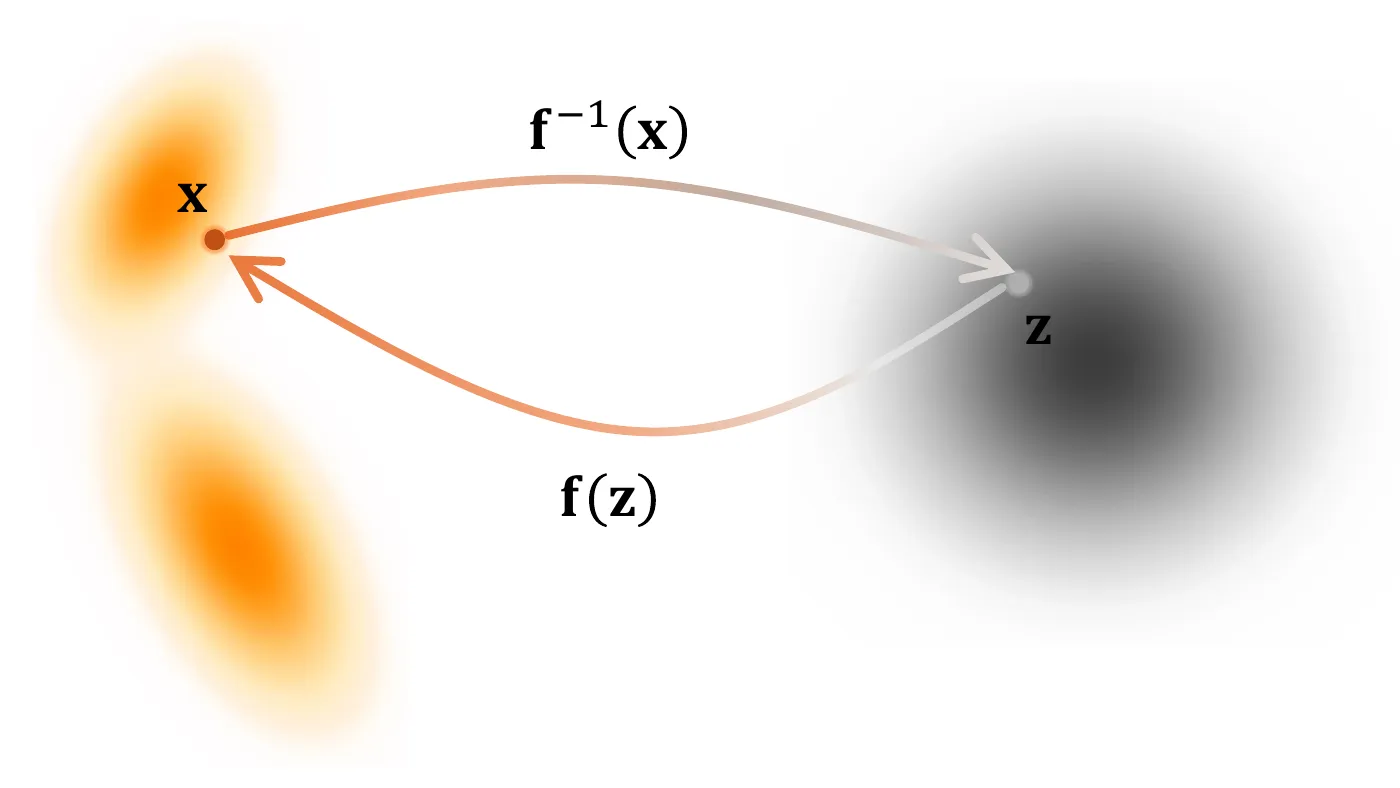
和 VAE 的 encoder–decoder 差在哪
B03 的 VAE 也有 encoder 和 decoder,但兩者是分開學的、\(\mathbf z\) 的維度通常比 \(\mathbf x\) 小,decoder 還帶雜訊,所以 \(\log p(\mathbf x)\) 只能用 ELBO 下界。NF 的 decoder 就是 encoder 的反函數、維度相同、沒有雜訊,所以 \(\log p(\mathbf x)\) 可以精確算出來。代價是架構必須可逆、而且行列式要好算。
03Normalizing flow書 §5.1.1
NF(Rezende & Mohamed 2015)把簡單的先驗 \(p_{\text{prior}}(\mathbf z)\)(例如標準高斯 \(\mathcal N(\mathbf 0,\mathbf I)\))經過一個可逆映射 \(\mathbf f_{\bm\phi}:\mathbb R^D\to\mathbb R^D\) 變換,來建模複雜的資料分佈 \(p_{\text{data}}(\mathbf x)\):\(\mathbf x=\mathbf f_{\bm\phi}(\mathbf z)\),\(\mathbf z\sim p_{\text{prior}}\)。這裡 \(\mathbf x\) 和 \(\mathbf z\) 的維度相同。由變數變換公式,模型的概似是
$$\log p_{\bm\phi}(\mathbf x)=\log p_{\text{prior}}(\mathbf z)+\log\left|\det\frac{\partial\mathbf f_{\bm\phi}^{-1}(\mathbf x)}{\partial\mathbf x}\right|.$$書的註腳:如果再限制映射是某個凸位勢的梯度 \(\mathbf f_{\bm\phi}=\nabla\psi_{\bm\phi}\)(\(\psi_{\bm\phi}\) 是凸函數),上式就化成 Monge–Ampère 關係式;這條偏微分方程刻畫了在平方成本下把一個分佈變成另一個分佈的最佳變換。詳見第 7 章(B18–B20)和 Huang et al. 的凸 potential flow。
訓練目標
參數 \(\bm\phi\) 用在資料上最大化概似來學:
$$\mathcal L_{\text{NF}}(\bm\phi)=\mathbb E_{\mathbf x\sim p_{\text{data}}}\big[\log p_{\bm\phi}(\mathbf x)\big].$$上面式子裡的 Jacobian 行列式可能很貴,一般是 \(\mathcal O(D^3)\)。
建構可逆變換
單一個複雜的可逆網路,算 Jacobian 行列式可能很貴;反過來,簡單的變換(例如線性的)有效率但表達力不足。為了平衡兩者,NF 用一串 \(L\) 個可訓練的可逆映射 \(\{\mathbf f_k\}_{k=0}^{L-1}\),每一個的 Jacobian 都好算:
$$\mathbf f_{\bm\phi}=\mathbf f_{L-1}\circ\mathbf f_{L-2}\circ\cdots\circ\mathbf f_0.$$每個 \(\mathbf f_k\) 都由神經網路參數化(為了記號簡潔,省略對 \(\bm\phi\) 的依賴)。樣本這樣變換:
$$\mathbf x_{k+1}=\mathbf f_k(\mathbf x_k),\qquad k=0,\dots,L-1,$$\(\mathbf z=\mathbf x_0\sim p_{\text{prior}}\),\(\mathbf x=\mathbf x_L\) 對應資料。得到的(log)密度是
從單層公式推到 \(L\) 層
連鎖律:\(\frac{\partial\mathbf f_{\bm\phi}}{\partial\mathbf x_0}=\frac{\partial\mathbf f_{L-1}}{\partial\mathbf x_{L-1}}\cdots\frac{\partial\mathbf f_0}{\partial\mathbf x_0}\),行列式把乘積拆開:\(\det(AB)=\det A\det B\)。再用 \(|\det\partial\mathbf f^{-1}/\partial\mathbf x|=|\det\partial\mathbf f/\partial\mathbf z|^{-1}\)。所以每多一層,就多加一項 \(-\log|\det\partial\mathbf f_k/\partial\mathbf x_k|\):只要每一層的行列式好算,整串都好算。
可逆流的例子
大量文獻致力於設計單層的 flow 構造,讓 Jacobian 好算。下面介紹兩種有代表性的:planar flow(Rezende & Mohamed 2015)和 residual flow(Chen et al. 2019;Behrmann et al. 2019),後者啟發了第 4 節的發展。
Planar flow 套用一個簡單的變換
$$\mathbf f(\mathbf z)=\mathbf z+\mathbf u\,h(\mathbf w^\top\mathbf z+b),$$\(\mathbf u,\mathbf w\in\mathbb R^D\)、\(b\in\mathbb R\),\(h(\cdot)\) 是激活函數。參數會被適當地限制或重新參數化以保證可逆。它的 Jacobian 行列式有簡單的形式
$$\left|\det\frac{\partial\mathbf f(\mathbf z)}{\partial\mathbf z}\right|=\big|1+h'(\mathbf w^\top\mathbf z+b)\,\mathbf w^\top\mathbf u\big|,$$讓變數變換的計算很有效率。
為什麼只要 \(\mathcal O(D)\):矩陣行列式引理
\(\frac{\partial\mathbf f}{\partial\mathbf z}=\mathbf I+h'(\mathbf w^\top\mathbf z+b)\,\mathbf u\mathbf w^\top\),是單位矩陣加上一個秩為 1 的矩陣。矩陣行列式引理:\(\det(\mathbf I+\mathbf a\mathbf b^\top)=1+\mathbf b^\top\mathbf a\)。取 \(\mathbf a=h'\mathbf u\)、\(\mathbf b=\mathbf w\) 就得到上式,只要一次內積。
可逆的條件(tanh 時):\(\mathbf w^\top\mathbf u\ge-1\) 就能保證 \(1+h'\mathbf w^\top\mathbf u\gt0\)(因為 \(0\lt h'\le1\));Rezende & Mohamed 用一個重新參數化把 \(\mathbf u\) 投影到滿足這個條件的區域。
Residual flow 把變換定義成
$$\mathbf f(\mathbf z)=\mathbf z+\mathbf v(\mathbf z),$$\(\mathbf v\) 是壓縮的(Lipschitz 常數小於 1)。這透過 Banach 不動點定理保證可逆。Jacobian 的 log 行列式化成 trace 的展開:
$$\log\left|\det\frac{\partial\mathbf f(\mathbf z)}{\partial\mathbf z}\right|=\log\Big(\det\frac{\partial\mathbf f(\mathbf z)}{\partial\mathbf z}\Big)=\operatorname{Tr}\Big(\log\frac{\partial\mathbf f(\mathbf z)}{\partial\mathbf z}\Big)=\operatorname{Tr}\Big(\log\Big(\mathbf I+\frac{\partial\mathbf v(\mathbf z)}{\partial\mathbf z}\Big)\Big)=\sum_{k=1}^\infty\frac{(-1)^{k+1}}k\operatorname{Tr}\Big(\Big(\frac{\partial\mathbf v(\mathbf z)}{\partial\mathbf z}\Big)^k\Big),$$可以用 trace 估計量(Hutchinson 1989,B06)有效率地計算。
每一個等號的理由
可逆。給定 \(\mathbf x\),要解 \(\mathbf z+\mathbf v(\mathbf z)=\mathbf x\),也就是找映射 \(\mathbf z\mapsto\mathbf x-\mathbf v(\mathbf z)\) 的不動點。\(\mathbf v\) 的 Lipschitz 常數 \(\lt1\),這個映射是壓縮映射,Banach 不動點定理保證不動點存在且唯一(反覆代入就會收斂)。
去掉絕對值。Jacobian \(\mathbf I+\partial\mathbf v/\partial\mathbf z\) 的特徵值都在以 1 為中心、半徑 \(\lt1\) 的圓裡,所以行列式(特徵值的乘積)是正的。
\(\log\det=\operatorname{Tr}\log\)。對可對角化的 \(\mathbf A\) 特徵值 \(\lambda_i\):\(\log\det\mathbf A=\sum_i\log\lambda_i=\operatorname{Tr}(\log\mathbf A)\)。
級數。矩陣版本的 \(\log(1+x)=x-\tfrac{x^2}2+\tfrac{x^3}3-\cdots\),在 \(\Vert\partial\mathbf v/\partial\mathbf z\Vert\lt1\) 時收斂。每一項的 trace 都可以用 Hutchinson 估計:\(\operatorname{Tr}(\mathbf J^k)=\mathbb E[\mathbf u^\top\mathbf J^k\mathbf u]\),只需要 \(k\) 次 vector-Jacobian product。實務上截斷級數(Residual Flows 用隨機截斷得到不偏估計)。
取樣與推論
從 NF 取樣很直接:抽 \(\mathbf x_0\sim p_{\text{prior}}\),算 \(\mathbf x=\mathbf f_{\bm\phi}(\mathbf x_0)\)。精確的概似由上面的 \(L\) 層公式得到。
「精確概似」要往哪個方向算
取樣要算 \(\mathbf f\)(\(\mathbf z\to\mathbf x\)),算概似要算 \(\mathbf f^{-1}\)(\(\mathbf x\to\mathbf z\))。不同的架構讓其中一個方向便宜、另一個方向貴:planar flow 往前算容易、反函數沒有封閉形式;residual flow 的反函數要靠不動點迭代。Demo B 選擇讓「\(\mathbf x\to\mathbf z\)」有封閉形式(訓練要算的方向),取樣時再用二分法數值求反函數。
Demo A一維的變數變換轉述者補充
先驗 \(z\sim\mathcal N(0,1)\),可逆映射 \(x=f(z)=\sinh\big((\operatorname{asinh}z+\varepsilon)/\delta\big)\)(一個常用的單調變換:\(\varepsilon\) 控制偏斜,\(\delta\) 控制尾巴的厚薄;\(\varepsilon=0,\delta=1\) 時 \(f\) 是恆等映射)。比較用變數變換公式算出的密度,和把 20,000 個 \(z\) 推過 \(f\) 得到的直方圖。
瀏覽器實測:在 \((\varepsilon,\delta)=(0.6,0.7)\)、\((0,1)\)、\((-1.5,2)\)、\((1.5,0.4)\) 四組設定下,用公式算出的密度積分都是 1.0000;直方圖和公式的最大差距在 0.014–0.038 之間,是 20,000 個樣本的抽樣誤差。注意 \(\delta\) 小時(例如 0.4)尾巴非常厚,樣本平均可以到 100 以上,但密度公式仍然精確:只要映射可逆、知道反函數和它的導數,就能算出任何點的密度。這就是 NF 能做精確概似的原因。
Demo B用最大概似訓練一個一維 normalizing flow轉述者補充
資料和 B08–B10 相同:\(0.6\,\mathcal N(1.2,0.25^2)+0.4\,\mathcal N(-1,0.2^2)\)。flow 由 \(K\) 個單調層組成,方向是 \(x\to z\)(概似要算的方向):每一層 \(y=e^{a}x+e^{c}\tanh(e^{d}x+b)\),導數 \(e^{a}+e^{c+d}\operatorname{sech}^2(e^dx+b)\gt0\),所以永遠可逆、log 行列式有封閉形式。它是一維的 planar 型層(\(\mathbf u\mathbf w^\top\) 那一項,限制成同號以保證可逆)再加上一個縮放。訓練目標就是 \(\mathcal L_{\text{NF}}\):\(\log p(x)=\log\mathcal N(z;0,1)+\sum_k\log y_k'\),手寫反向傳播、Adam、batch 256。取樣時從 \(z\sim\mathcal N(0,1)\) 用二分法反解 \(x\)。
瀏覽器實測(固定種子,2,000 步;1 層約 0.4 秒、8 層約 2 秒、16 層約 4 秒):
| 層數 \(K\) | 平均 \(\log p_{\bm\phi}\) | 和真值(\(-0.618\))的差 | 密度最大誤差 | 上團比例 |
|---|---|---|---|---|
| 1 | \(-1.229\) | 0.611 | 0.685 | 72.5% |
| 2 | \(-1.233\) | 0.615 | 0.687 | 72.9% |
| 4 | \(-0.721\) | 0.103 | 0.203 | 61.3% |
| 8 | \(-0.663\) | 0.045 | 0.185 | 60.5% |
| 16 | \(-0.646\) | 0.028 | 0.135 | 61.2% |
- 單層表達力不夠,疊起來才行:1–2 層學不出兩個分開的峰(差 0.61 nats,上團比例 72–73%);4 層起就抓到雙峰,16 層時平均 log 概似只比真值少 0.028 nats。這正是「每一層簡單、疊很多層」的設計理由。
- 學到的映射在做什麼:下圖的 \(z=f^{-1}(x)\) 在兩團各自那一段很陡(把窄的團拉寬成高斯的一部分),在兩團之間很平(把幾乎沒有資料的區域壓縮);斜率就是 \(|dz/dx|\),也就是變數變換公式裡的那個因子。
- 訓練不需要任何 ODE 或取樣:每一步只要對資料點算一次 \(f^{-1}\) 和 log 行列式。代價是架構必須讓這個方向便宜;取樣反而要數值反解(這裡用二分法)。
04Neural ODE書 §5.1.2
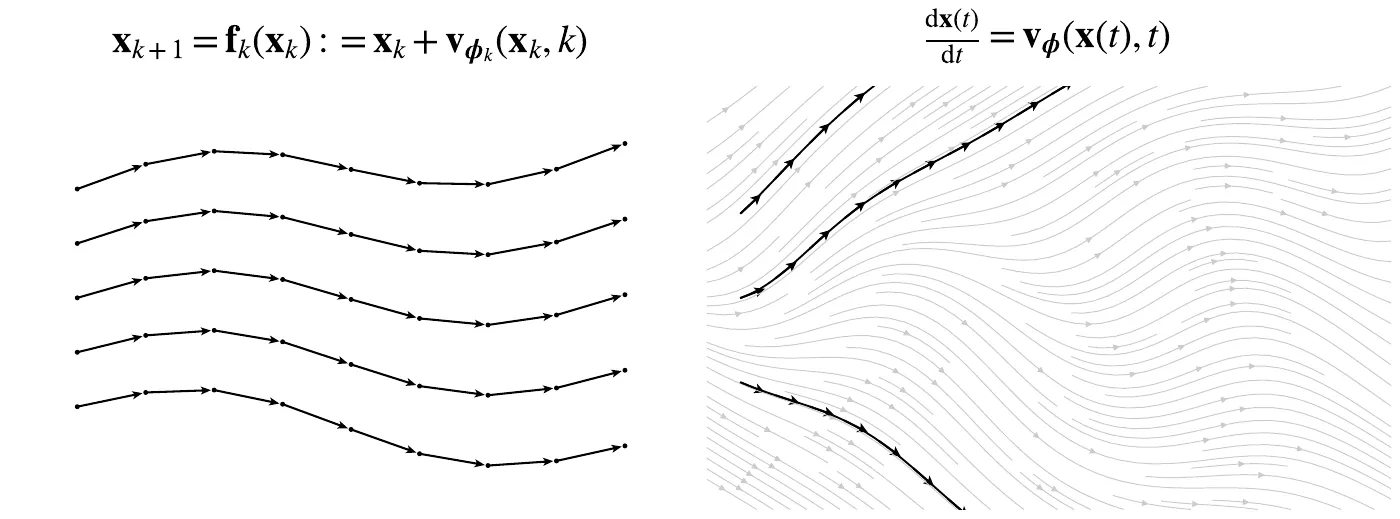
從離散時間 NF 到連續時間 NF(neural ODE)
離散的 NF 用 \(L\) 個可逆映射的合成運送樣本。為了得到有意義的「連續深度」極限,把每一層寫成一個小的殘差更新:
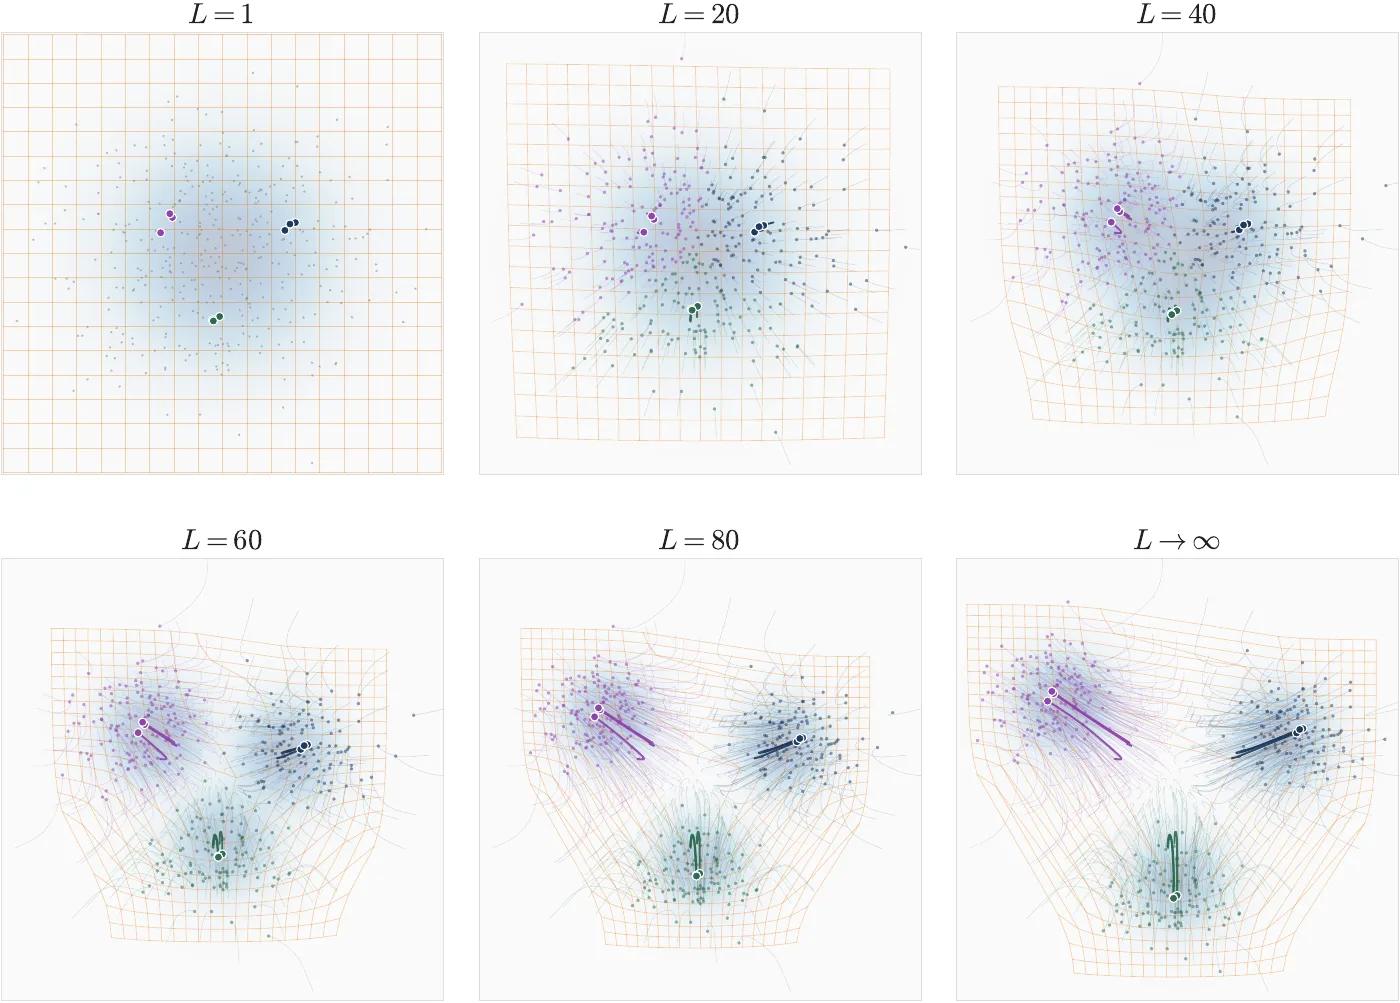
$$\mathbf x_{k+1}=\mathbf x_k+\Delta t\,\mathbf v_{\bm\phi}(\mathbf x_k,t_k),\qquad t_k=k\Delta t,\qquad\Delta t=\frac TL.$$\(\mathbf v_{\bm\phi}\) 指定每個點往哪個方向移動,\(\Delta t\) 控制一層的大小。這個極限的幾何意義畫在下圖:\(L\) 增加時,同樣的來源到目標的運送被切成更多個接近恆等映射的雙射,樣本軌跡被解析得更細,周圍參考格線的變形也越來越平滑。當 \(L\to\infty\)、\(\Delta t\to0\),離散的層編號變成連續的時間,得到 ODE
$$\frac{d\mathbf x(t)}{dt}=\mathbf v_{\bm\phi}(\mathbf x(t),t).$$這個連續深度的模型叫做 neural ODE,或連續的 normalizing flow(CNF)。
Neural ODE 的正式設定
neural ODE 透過下式定義一個連續的變換:
$$\frac{d\mathbf x(t)}{dt}=\mathbf v_{\bm\phi}(\mathbf x(t),t),\qquad t\in[0,T],$$\(\mathbf x(t)\in\mathbb R^D\) 是時間 \(t\) 的狀態(有時簡寫成 \(\mathbf x_t\)),\(\mathbf v_{\bm\phi}(\mathbf x(t),t)\) 是以 \(\bm\phi\) 為參數的神經網路。
NODE 的目標。從初始條件 \(\mathbf x(0)\sim p_{\text{prior}}\) 出發,ODE 讓狀態隨時間連續演化,誘導出一族邊際分佈 \(p_{\bm\phi}(\mathbf x_t,t)\)(和 PF-ODE 很像!)。書的註腳在這裡宣布翻轉的時間慣例:\(t=0\) 是先驗(來源),\(t=1\) 是資料(目標);先驗可以寫成 \(p_{\bm\phi}(\mathbf x(0),0)\)、\(p_{\text{prior}}(\mathbf x(0),0)\) 或簡寫成 \(p_{\text{prior}}(\mathbf z)\)。目標是學神經向量場 \(\mathbf v_{\bm\phi}\),直覺上它代表一個速度,沿著資料空間裡的連續軌跡運送點。學好這個速度,\(t=T\) 的終點分佈就和目標分佈 \(p_{\text{data}}(\cdot)\) 一致。這個連續變換把離散的 normalizing flow 和 neural ODE 統一在同一個框架下。
連續時間的變數變換公式
類比離散的變數變換公式,Chen et al. (2018) 推出了連續時間的版本。對依 neural ODE 演化的過程 \(\mathbf x(t)\)、它隨時間變化的密度 \(p_{\bm\phi}(\mathbf x(t),t)\),所謂的瞬時變數變換公式(Instantaneous Change-of-Variables Formula)是
$$\frac{d}{dt}\log p_{\bm\phi}(\mathbf x(t),t)=-\nabla_{\mathbf x}\cdot\mathbf v_{\bm\phi}(\mathbf x(t),t).$$這裡的導數是沿著 ODE 軌跡 \(\mathbf x(t)\) 取的。所以若 \(\mathbf x(0)\sim p_{\text{prior}}\)、ODE 把先驗從 \(t=0\) 運送到 \(t=T\),把這個恆等式積分就得到
這個式子讓我們能用數值積分計算概似,進而用最大概似訓練模型。乍看之下這個公式可能很陌生,但它和 Fokker–Planck 方程密切相關:可以把它理解成連續方程「沿著軌跡」的寫法,而連續方程就是 Fokker–Planck 方程在確定性、零擴散時的特例(書的附錄 B)。它也可以解讀成離散變數變換公式的連續時間極限。下面把結果整理成 Lemma:
證明(書的附錄 D.3,兩種方法)
方法一:變數變換公式。記 \(p_t(\mathbf z_t)=p(\mathbf z(t),t)\)。從 ODE 的離散化 \(\mathbf z_{t+\Delta t}=\mathbf z_t+\Delta t\,\mathbf F(\mathbf z_t,t)\) 出發,這是一個殘差映射,NF 的變數變換公式給出
$$\begin{aligned}\log p_{t+\Delta t}(\mathbf z_{t+\Delta t})&=\log p_t(\mathbf z_t)-\log\big|\det\big(\mathbf I+\Delta t\,\nabla_{\mathbf z}\mathbf F(\mathbf z_t,t)\big)\big|\\&=\log p_t(\mathbf z_t)-\operatorname{Tr}\big(\log(\mathbf I+\Delta t\,\nabla_{\mathbf z}\mathbf F(\mathbf z_t,t))\big)\\&=\log p_t(\mathbf z_t)-\Delta t\operatorname{Tr}\big(\nabla_{\mathbf z}\mathbf F(\mathbf z_t,t)\big)+\mathcal O(\Delta t^2),\end{aligned}$$用了 \(\log\det=\operatorname{Tr}\log\) 和小 \(\Delta t\) 的展開(就是 residual flow 級數的第一項)。除以 \(\Delta t\)、令 \(\Delta t\to0\),得到 log 密度的微分方程;\(\operatorname{Tr}(\nabla\mathbf F)=\nabla\cdot\mathbf F\)。
方法二:連續方程。連續方程本質上就是變數變換公式:\(\partial_tp=-\nabla\cdot(\mathbf Fp)\)。把散度展開:\(\partial_tp=-\big((\nabla\cdot\mathbf F)p+\mathbf F\cdot\nabla p\big)\)。沿著滿足 \(\frac{d\mathbf z}{dt}=\mathbf F\) 的軌跡,全導數是
$$\frac{d}{dt}p(\mathbf z(t),t)=\nabla p\cdot\frac{d\mathbf z}{dt}+\partial_tp=\nabla p\cdot\mathbf F-\big((\nabla\cdot\mathbf F)p+\mathbf F\cdot\nabla p\big)=-(\nabla\cdot\mathbf F)\,p.$$除以 \(p(\mathbf z(t),t)\) 就是結論。∎(這正是 B09 第 5 節推導框的那個論證。)
和離散時間公式的連結
NODE 的概似
$$\log p_{\bm\phi}(\mathbf x(T),T)=\log p_{\text{prior}}(\mathbf x(0),0)-\int_0^T\nabla_{\mathbf x}\cdot\mathbf v_{\bm\phi}(\mathbf x(t),t)\,dt$$可以看成離散 NF 公式
$$\log p_{\bm\phi}(\mathbf x_L)=\log p_{\text{prior}}(\mathbf x_0)-\sum_{k=0}^{L-1}\log\left|\det\frac{\partial\mathbf f_k}{\partial\mathbf x_k}\right|$$的連續時間類比:積分對應加總,trace 取代了 log 行列式(如 residual flow 的展開)。Lemma 的證明(方法一)進一步展示了這個平行關係。
和 B09 的 PF-ODE 概似:同一個公式,方向相反
B09 用 diffusion 時鐘,從資料 \(\mathbf x_0\)(\(t=0\))往前跑到先驗(\(t=T\)),所以 \(\log p(\mathbf x_0)=\log p_{\text{prior}}(\mathbf x(T))+\int_0^T\nabla\cdot\mathbf v\,dt\):從資料端看,沿途散度為正(往外攤開)的部分會讓資料端的密度「比先驗高」。這裡用翻轉的時鐘,從先驗(\(t=0\))往資料(\(t=T\))跑,同一個 Lemma 積分得 \(\log p(\mathbf x(T))=\log p_{\text{prior}}(\mathbf x(0))-\int_0^T\nabla\cdot\mathbf v\,dt\)。若把翻轉時鐘的速度寫成 \(\mathbf u(\mathbf x,\tau)=-\mathbf v(\mathbf x,T-\tau)\),散度也變號,兩個式子完全一致。Demo C 的速度場就是 B09 的 PF-ODE 換到翻轉時鐘。
訓練 NODE
根據上面的概似公式,NODE 學一個參數化的速度場 \(\mathbf v_{\bm\phi}\),讓終點分佈 \(p_{\bm\phi}(\cdot,T)\approx p_{\text{data}}\),軌跡從潛在變數 \(\mathbf x(0)\sim p_{\text{prior}}\) 經由 ODE 的流演化。訓練遵循 MLE 框架(B01):
$$\mathcal L_{\text{NODE}}(\bm\phi):=\mathbb E_{\mathbf x\sim p_{\text{data}}}\big[\log p_{\bm\phi}(\mathbf x,T)\big].$$精確計算 log 概似。要算資料點 \(\mathbf x\) 的 \(\log p_{\bm\phi}(\mathbf x,T)\),就積分變數變換公式:
$$\log p_{\bm\phi}(\mathbf x,T)=\log p_{\text{prior}}(\mathbf z(0))-\int_0^T\nabla_{\mathbf z}\cdot\mathbf v_{\bm\phi}(\mathbf z(t),t)\,dt,$$這裡 \(\mathbf z(t)\) 是把 ODE \(\frac{d\mathbf z(t)}{dt}=\mathbf v_{\bm\phi}(\mathbf z(t),t)\) 從 \(t=T\) 倒著解到 \(t=0\) 的解,\(\mathbf z(T)=\mathbf x\)。先驗項 \(\log p_{\text{prior}}(\mathbf z(0))\) 對標準分佈是好算的。這讓 neural ODE 能做精確的、基於概似的訓練和評估。
以梯度為基礎的最佳化。最大化 \(\mathcal L_{\text{NODE}}\) 需要對 ODE 求解器做反向傳播。伴隨敏感度方法(adjoint sensitivity method;Pontryagin;Chen et al. 2018)透過一條輔助的 ODE 計算梯度,記憶體只要 \(\mathcal O(1)\);但因為每一步訓練都要做數值積分,NODE 的訓練仍然很昂貴。
貴在哪裡
每一個 batch:對每個資料點倒著解一次 ODE(同時積分散度),算出 \(\log p\);再用 adjoint 方法解另一條同樣長的 ODE 得到梯度。ODE 的步數由求解器的誤差容許決定,訓練過程中速度場變得越來越複雜時,步數還會增加。再加上高維時散度要用 Hutchinson 估計(又多一層雜訊)。這就是下面那個問題的動機:能不能完全不解 ODE 就學到速度場?
用 NODE 推論
用訓練好的 \(\mathbf v_{\bm\phi^\times}\) 取樣:抽 \(\mathbf x(0)\sim p_{\text{prior}}\),用數值求解器往前積分:
$$\mathbf x(T)=\mathbf x(0)+\int_0^T\mathbf v_{\bm\phi^\times}(\mathbf x(t),t)\,dt.$$終點狀態 \(\mathbf x(T)\) 近似一個 \(p_{\text{data}}\) 的樣本。此外,對任何向量場 \(\mathbf F\),恆等式 \(\operatorname{Tr}\big(\frac{\partial\mathbf F}{\partial\mathbf z(t)}\big)=\nabla_{\mathbf z}\cdot\mathbf F\) 成立。所以散度可以用隨機 trace 估計量(例如 Hutchinson 1989)有效率地估計,不必明確建出整個 Jacobian,讓高維的概似計算實際得多。但因為 trace 是用隨機樣本估計的,得到的 log 概似數值是隨機的估計,而不是散度的精確計算。
看過上面那張圖裡很多小雙射怎麼趨近連續的運送流之後,書問了一個實際的問題:
這個問題自然地引出 Flow Matching:它透過一個 simulation-free 的回歸目標直接學速度場,並為 diffusion model 提供 flow 的觀點(B12)。
Demo C很多小殘差層 → 連續的流轉述者補充
拿一個已知的速度場:B09 的 PF-ODE(VP、資料是同一個兩高斯混合、精確 score),換到這一章的翻轉時鐘 \(\tau\in[0,1]\)(\(\tau=0\) 是 \(\mathcal N(0,1)\),\(\tau=1\) 是資料)。把它切成 \(L\) 個殘差層 \(x_{k+1}=x_k+\Delta\tau\,u(x_k,\tau_k)\),\(\Delta\tau=1/L\)。這 \(L\) 層本身就是一個離散的 NF,它的精確 log 密度是 \(\log\mathcal N(x_0)-\sum_k\log|1+\Delta\tau\,u'(x_k)|\)。對 2,000 個樣本比較三個量:這個離散 NF 的精確值、把 log 行列式換成一階的 \(\Delta\tau\,u'\)(散度的黎曼和)、以及真正的 \(\log p_{\text{data}}(x_L)\)。
瀏覽器實測(2,000 個樣本,和真正 \(\log p_{\text{data}}\) 的平均絕對差距):
| \(L\) | 5 | 10 | 20 | 50 | 200 | 1000 |
|---|---|---|---|---|---|---|
| 離散 NF 的精確 log 行列式 | 1.178 | 0.280 | 0.115 | 0.048 | 0.012 | 0.003 |
| 散度的黎曼和 | 1.043 | 0.396 | 0.185 | 0.068 | 0.017 | 0.004 |
| \(\min(1+\Delta\tau\,u')\) | 0.303 | 0.360 | 0.626 | 0.850 | 0.962 | 0.992 |
- 離散的層趨近連續的流:\(L\) 越大,\(L\) 層殘差 NF 的分佈越接近 ODE 運送出的分佈(也就是資料分佈),兩種算 log 密度的方法也一起收斂:\(\log|1+\Delta\tau\,u'|=\Delta\tau\,u'+\mathcal O(\Delta\tau^2)\),差別隨 \(L\) 消失。這就是 Lemma 證明的方法一,也就是書中那張 \(L=1,20,\dots,\infty\) 的圖。
- 每一層都接近恆等映射:\(L=1000\) 時每層的 \(1+\Delta\tau\,u'\) 都在 0.992 以上。\(L\) 小時這個值可以小很多(\(L=5\) 時 0.30),層在某些地方強烈壓縮;若再大一些,就可能小於 0、層不可逆。這個例子裡沒有發生,但這就是為什麼 residual flow 需要 Lipschitz 限制,而 ODE 的極限自動避開了這個問題。
- 軌跡:上圖的 30 條軌跡從 \(\mathcal N(0,1)\) 出發、互不交叉地分流到兩團,和書中 PF-ODE、CNF 的軌跡圖是同一個樣子。