把一個分佈搬成另一個:最佳運送、熵正則化與 Schrödinger bridge
第 5 章的 flow matching 學一個把來源分佈搬到目標分佈的速度場,但沒有問「怎麼搬最省」。這一章(書標為選讀)回答 diffusion 在什麼意義下是最佳運送。這一頁先把問題設好:靜態的最佳運送(Monge–Kantorovich)和它的動態版本(Benamou–Brenier);加上熵正則化的 OT,以及能用 Sinkhorn 演算法快速求解的理由;最後是 Schrödinger bridge:在所有連接兩端分佈的隨機過程裡,找最接近布朗運動的那一個。下一頁(B19)證明 EOT 和 SB 等價,再下一頁(B20)回答 diffusion 的 PF-ODE 是不是 OT。
讀完這頁你應該能夠
- 區分配對(coupling)、確定性的運送映射、動態的運送流和隨機的 Schrödinger bridge,並把它們對應到深度生成模型。
- 寫出 Monge–Kantorovich 問題、\(\mathcal W_2\) 距離、Monge 形式和 Benamou–Brenier 動態形式,並說明 McCann 位移插值。
- 說明為什麼要加熵正則化:唯一性、Sinkhorn 形式、計算量,以及 \(\varepsilon\) 兩個極限的行為。
- 寫出 SB 的 KL 形式和隨機控制形式,並說明為什麼 SB 需要一個參考過程。
- 說出 SB 解的 Schrödinger 系統、前向與反向 SB SDE,以及它們的漂移怎麼由時間反轉公式連起來。
前置知識
- B14:配對、確定性配對、直線路徑不一定是最佳運送;B12:連續方程、pushforward。
- B11:normalizing flow 的變數變換公式;B08:前向與反向 SDE、時間反轉。
- KL 散度與熵;布朗運動與布朗橋:CS236 補充課 E。
書把整個第 7 章標為選讀。「書 §」標出原文位置。灰框「轉述者補充」是書裡沒有的內容;藍框「推導」展開書中省略的步驟。
01第 7 章:diffusion 是不是最佳運送?書 第 7 章開頭
把一個分佈映射成另一個(生成是特例)是一個核心的挑戰。Flow matching 學一個隨時間變化的速度場,把質量從來源運到目標。這自然地連到運送理論:古典的最佳運送找兩個分佈之間成本最小的路徑;它的熵正則化版本 Schrödinger bridge 則在一個參考過程(例如布朗運動)之下,選出可能性最大的受控 diffusion。
這一章回顧最佳運送、熵最佳運送和 Schrödinger bridge 作為「分佈到分佈」問題的表述。這引出一個核心問題:diffusion model 在多大程度上實現了這樣的最佳運送?diffusion model 有兩種看法:作為由前向與反向 SDE 定義的隨機過程,以及由 PF-ODE 給出的確定性過程。隨機的觀點直接對應到熵最佳運送,PF-ODE 卻一般不對應任何已知的運送目標。這個落差留下一個開放問題:在什麼條件下,diffusion model 可以被看成在解一個最佳運送問題?
書對這一章的學習目標與閱讀建議(轉述)
書列出的目標:區分運送的配對、確定性的運送映射、動態的運送流和隨機的 Schrödinger bridge,並在概念上連到深度生成建模;理解古典 OT、熵 OT 和 Schrödinger bridge 問題各在最佳化什麼、彼此怎麼相關;解釋為什麼標準的 diffusion 前向/反向 SDE 一般不解一個指定兩端的 Schrödinger bridge 問題;解釋為什麼 diffusion 的 PF-ODE 定義了一個確定性的運送映射,卻一般不等於二次成本的最佳運送映射。閱讀建議:這一章對 diffusion model 的主線是選讀;想要精確回答「diffusion 在什麼意義下(如果有的話)是最佳運送」時再讀。後兩個目標在 B19、B20。
02分佈到分佈的翻譯書 §7.1
diffusion model 把終端分佈固定成標準高斯 \(p_{\text{prior}}\)。但許多應用需要分佈到分佈的翻譯:把一個來源分佈 \(p_{\text{src}}\) 轉成另一個目標 \(p_{\text{tgt}}\),例如把草圖變成逼真的照片,或在不同的藝術風格之間轉換。
現代的 diffusion 方法提供了幾種實際的做法。單端方法,例如 SDEdit(Meng et al. 2021),從 \(t=0\) 的來源影像出發,把它加雜訊到中間的某一步 \(t\),再用一個為目標領域預先訓練好的 diffusion model 反向去雜訊,得到符合目標分佈風格與內容的輸出。雙端方法,例如 Dual Diffusion Bridge(Su et al. 2022),透過一個共用的潛在分佈(通常是 \(t=1\) 的高斯)連接兩個領域:一條前向的 PF-ODE 把 \(p_{\text{src}}\) 的樣本運到這個潛在空間,一條在目標領域上訓練的反向 ODE 再把它們映回 \(p_{\text{tgt}}\)。除了這些取樣時的方法,第 5 章的 flow matching 框架提供以訓練為基礎的替代:直接學一個把質量從 \(p_{\text{src}}\) 連續地搬到 \(p_{\text{tgt}}\) 的 ODE 流。
關鍵是,在分佈之間轉換需要的不只是兩個分別訓練的模型,而是一個有原則的映射:它在兩端都對齊動態,而且以「最便宜」(成本最有效率)的方式做到。這一節不綜覽眾多基於 diffusion 的翻譯應用,而是轉向這個古典的分佈到分佈問題的數學基礎,特別是最佳運送(OT)和它的熵版本 Schrödinger bridge(SB),它們長期以來在理論界被當成(數學意義下)成本有效率的分佈轉換的典型表述。核心問題是:
這裡的成本 \(c(\mathbf x,\mathbf y)\) 是一個非負函數,給「把一單位質量從 \(\mathbf x\) 搬到 \(\mathbf y\)」一個懲罰。常見的選擇是平方距離 \(c(\mathbf x,\mathbf y)=\Vert\mathbf x-\mathbf y\Vert^2\)。這一章想探討的核心問題是:
為了回答,書先在 §7.2(本頁)釐清「最佳」是什麼意思:靜態的 Monge–Kantorovich 形式和動態的 Benamou–Brenier 形式(在連續方程的限制下最小化動能)的古典 OT,以及熵正則化的變體(熵 OT),它等價於 Schrödinger bridge 問題。在動態的觀點下,OT 誘導一個滿足連續方程的確定性流,SB 則誘導一個邊際依 Fokker–Planck 方程演化的受控 diffusion。§7.3(B19)給這些表述之間的高層對照。
接著分兩部分。第一,§7.4(B19)說明:標準 diffusion model 使用的固定前向加噪 SDE,本身並不是任意 \(p_{\text{src}}\)、\(p_{\text{tgt}}\) 之間的 Schrödinger bridge:前向過程是一個選定的參考 diffusion,前向或反向的 SDE 一般都不強制精確地匹配指定的目標端點。因此除非明確地用那些端點解 SB 問題,它不是熵 OT 意義下最佳的;但因為它只錨定一個起點,它是半橋(half-bridge)問題的最佳解。第二,§7.5(B20)回到生成的設定 \(p_{\text{src}}=p_{\text{prior}}\)(高斯)、\(p_{\text{tgt}}=p_{\text{data}}\)。PF-ODE 依建構定義了一個把 \(p_{\text{prior}}\) 運到 \(p_{\text{data}}\) 的確定性映射,但這個流一般不是某個指定成本(例如二次的 \(W_2\))的 OT 映射:它實現了眾多合法確定性配對中的一個,並不最小化 Benamou–Brenier 的作用量。接著討論 rectify flow(B14)能不能得到 OT 映射;一般而言沒有這樣的理論保證。所以 diffusion model 的 PF-ODE 映射和 OT 之間的精確刻畫,仍是一個困難、尚未解決的問題。
03最佳運送(OT)書 §7.2、§7.2.1
這一節介紹「把質量從 \(p_{\text{src}}\) 搬到 \(p_{\text{tgt}}\) 的最有效率或最佳的方式」的幾種概念,包括古典的最佳運送和它的熵正則化變體(等價於 Schrödinger bridge)。這個分類為之後和 diffusion model 的連結提供背景。
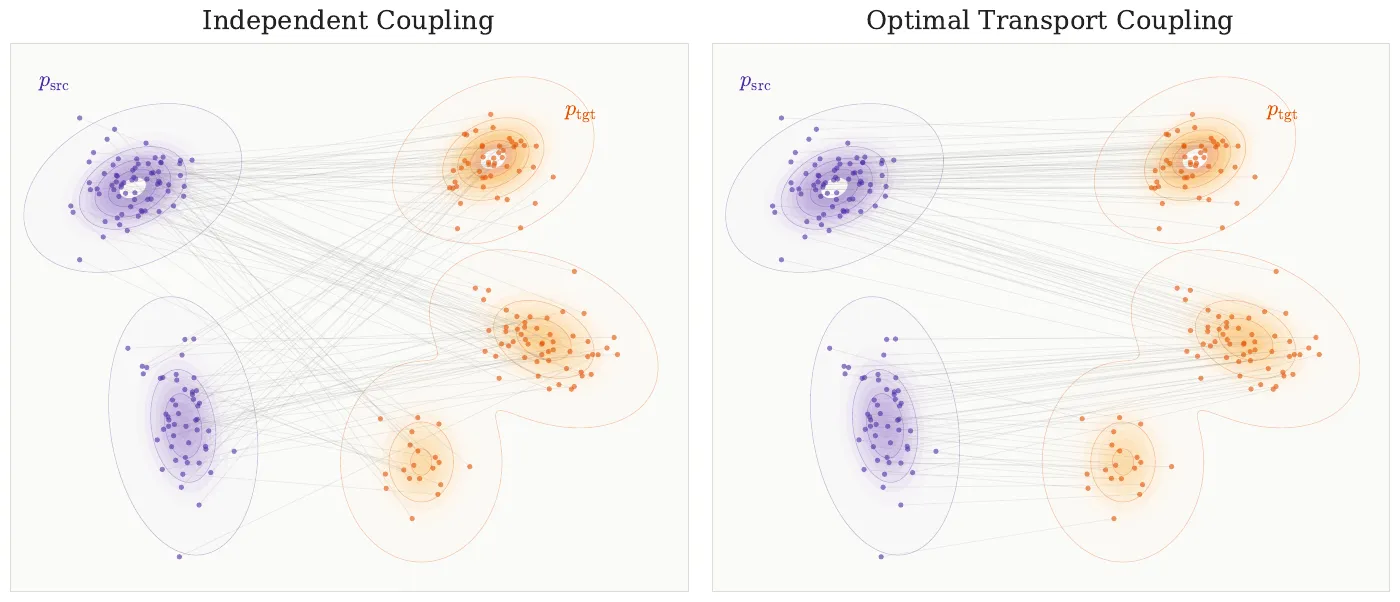
Monge–Kantorovich(靜態)形式
固定一個成本函數 \(c:\mathbb R^D\times\mathbb R^D\to\mathbb R\),它指定把機率質量從 \(\mathbf x\) 送到 \(\mathbf y\) 的費用。目標是以最便宜的方式把來源分佈 \(p_{\text{src}}\) 變成目標分佈 \(p_{\text{tgt}}\)。
要定義成本,首先必須知道哪些 \((\mathbf x,\mathbf y)\) 配在一起。這由配對(coupling)扮演:一個 \(\mathbb R^D\times\mathbb R^D\) 上、兩個邊際分別是 \(p_{\text{src}}\) 和 \(p_{\text{tgt}}\) 的聯合分佈 \(\gamma\)。也就是說,抽 \((\mathbf x,\mathbf y)\sim\gamma\) 表示把來源的 \(\mathbf x\) 和目標的 \(\mathbf y\) 配在一起。若 \(\gamma\) 對 Lebesgue 測度有密度 \(\gamma(\mathbf x,\mathbf y)\),邊際限制寫成
$$\int_{\mathbb R^D}\gamma(\mathbf x,\mathbf y)\,d\mathbf y=p_{\text{src}}(\mathbf x),\qquad\int_{\mathbb R^D}\gamma(\mathbf x,\mathbf y)\,d\mathbf x=p_{\text{tgt}}(\mathbf y).$$也就是:把 \(\mathbf y\) 積掉還原 \(\mathbf x\) 的來源密度,把 \(\mathbf x\) 積掉還原 \(\mathbf y\) 的目標密度。兩個標準的例子:
- 離散支撐。若 \(p_{\text{src}}\)、\(p_{\text{tgt}}\) 都支撐在有限多個點上,配對就是一個非負矩陣 \((\gamma_{ij})\),列和等於 \(p_{\text{src}}(i)\)、行和等於 \(p_{\text{tgt}}(j)\)。每個元素 \(\gamma_{ij}\) 是從 \(i\) 送到 \(j\) 的質量。
- 確定性映射。若存在一個可測映射 \(\mathbf T\) 使 \(\mathbf T_\#p_{\text{src}}=p_{\text{tgt}}\),則 \(\gamma=(\mathbf I,\mathbf T)_\#p_{\text{src}}\) 是一個確定性配對,把每個點 \(\mathbf x\) 直接送到 \(\mathbf T(\mathbf x)\)。
配對 \(\gamma\) 固定之後,運送成本就是這個計畫下的平均單位成本:\(\int c(\mathbf x,\mathbf y)\,d\gamma(\mathbf x,\mathbf y)=\mathbb E_{(\mathbf x,\mathbf y)\sim\gamma}[c(\mathbf x,\mathbf y)]\)。離散時化成 \(\sum_{i,j}c_{ij}\gamma_{ij}\),連續時是一個二重積分;以下只看連續的情形。最佳運送問題就是在所有合法的配對中,選期望成本最小的那一個:
可行集只強制邊際(質量守恆)限制:\(\Gamma(p_{\text{src}},p_{\text{tgt}})=\big\{\gamma\in\mathcal P(\mathbb R^D\times\mathbb R^D):\int\gamma(\mathbf x,\mathbf y)\,d\mathbf y=p_{\text{src}}(\mathbf x),\ \int\gamma(\mathbf x,\mathbf y)\,d\mathbf x=p_{\text{tgt}}(\mathbf y)\big\}\),\(\mathcal P(\mathbb R^D\times\mathbb R^D)\) 是 \(\mathbb R^D\times\mathbb R^D\) 上所有機率測度的集合。
特例:Wasserstein-2 距離
Wasserstein-2 距離是二次成本 \(c(\mathbf x,\mathbf y)=\Vert\mathbf x-\mathbf y\Vert^2\) 下的 Monge–Kantorovich 問題,衡量兩個機率分佈之間的距離:
$$\mathcal W_2^2(p_{\text{src}},p_{\text{tgt}}):=\inf_{\gamma\in\Gamma(p_{\text{src}},p_{\text{tgt}})}\mathbb E_{(\mathbf x,\mathbf y)\sim\gamma}\big[\Vert\mathbf x-\mathbf y\Vert^2\big].$$在 \(p_{\text{src}}\)、\(p_{\text{tgt}}\) 的適當假設下,Brenier 定理(書在 §7.5 陳述,B20)保證二次成本的最佳配對 \(\gamma\) 集中在一個確定性映射 \(\mathbf T:\mathbb R^D\to\mathbb R^D\) 的圖形上。(書的註腳:Brenier 定理談的是二次成本最佳運送映射的存在性和結構;特別是,若 \(p_{\text{src}}\) 不給維度不超過 \(D-1\) 的集合任何質量,則最佳運送映射 \(\mathbf T^*\) 唯一存在。)因此 Wasserstein-2 距離可以等價地寫成(書的註腳:\(\mathcal W_2\) 常用的三種形式,Monge 形式(基於運送映射)、Kantorovich 形式(基於配對)、Benamou–Brenier 動態形式,在適當的正則條件下等價)
這裡 \(\mathbf T_\#p_{\text{src}}=p_{\text{tgt}}\) 表示 \(\mathbf T\) 把 \(p_{\text{src}}\) 推成 \(p_{\text{tgt}}\),也就是 \(\mathbf x\sim p_{\text{src}}\) 時 \(\mathbf T(\mathbf x)\sim p_{\text{tgt}}\)。所以 Wasserstein-2 距離表示:在所有匹配給定邊際的配對或運送映射中,最小的期望平方運送成本。最佳運送映射 \(\mathbf T^*(\mathbf x)\) 叫做 Monge 映射,給出把 \(p_{\text{src}}\) 變成 \(p_{\text{tgt}}\) 最有效率的方式。
一維時的 Monge 映射:分位數對分位數
一維、二次成本時,最佳映射就是單調遞增的那一個:\(T^*=F_{\text{tgt}}^{-1}\circ F_{\text{src}}\),把來源的第 \(q\) 分位數送到目標的第 \(q\) 分位數。直覺:如果 \(x_1<x_2\) 卻配成 \(T(x_1)>T(x_2)\),交換兩者的目標會讓 \((x_1-y)^2+(x_2-y')^2\) 變小(交叉項 \(-2(x_1y+x_2y')\) 在單調時最負)。B13 Demo A 看過:一維的 ODE 軌跡不能交叉,所以任何一維的 ODE 流都給出這個單調映射;Demo B 用它當一維 OT 的精確解。高維就沒有這麼簡單了,B20 會看到 PF-ODE 一般不是 OT。
Benamou–Brenier(動態)形式
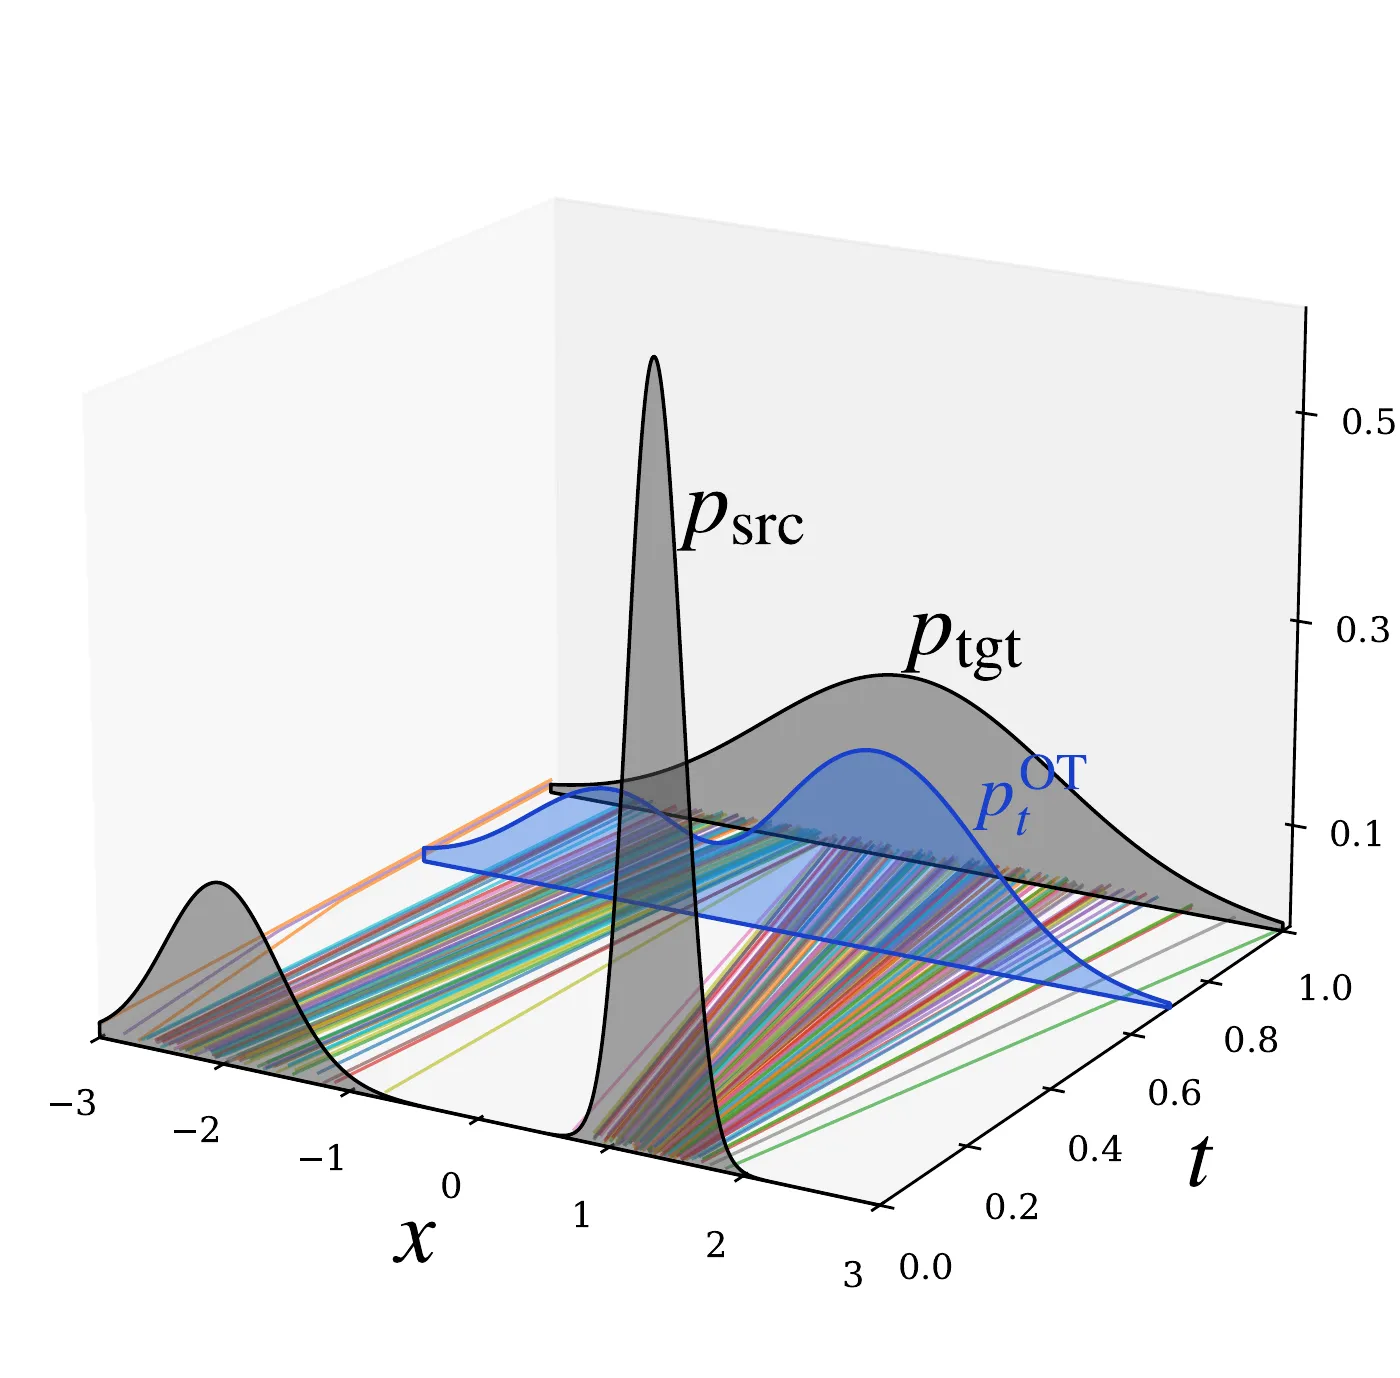
除了像 Monge–Kantorovich 形式那樣靜態地直接映射分佈,運送也可以建模成一個連續時間的流:\(p_0:=p_{\text{src}}\to p_t\to p_1:=p_{\text{tgt}}\),\(t\in[0,1]\)。Benamou & Brenier (2000) 提出的這個動態形式,找一個平滑的速度場 \(\mathbf v_t(\mathbf x)\) 描述 \(p_t(\mathbf x)\) 裡的質量怎麼隨時間演化。
Benamou–Brenier 形式(書的註腳:它描述怎麼透過在測度與速度的連續路徑上最小化動能,來計算 \(\mathcal W_2\) 距離)證明:對二次成本,靜態 OT 問題的最佳值等於下面這個動能最小化問題的最佳值:
每個 \(t\in[0,1]\) 的 \(p_t\) 是 \(\mathbb R^D\) 上的機率分佈。特別是,最佳運送流 \(p_t(\mathbf x)\) 遵循 McCann 位移插值:
$$\mathbf T_t^*(\mathbf x)=(1-t)\,\mathbf x+t\,\mathbf T^*(\mathbf x),$$\(\mathbf T^*\) 是把 \(p_{\text{src}}\) 運到 \(p_{\text{tgt}}\) 的 OT 映射。這個線性插值讓質量以等速沿直線移動:對每個 \(t\in[0,1]\),\(p_t=\mathbf T_{t\#}^*p_{\text{src}}\)。
為什麼動態的最小值不會比靜態的小(一半的證明,轉述者整理)
給定任何滿足連續方程的 \((p_t,\mathbf v_t)\),沿它的流跟著一個粒子 \(\mathbf x(t)\),\(\mathbf x(0)\sim p_{\text{src}}\)、\(\mathbf x(1)\sim p_{\text{tgt}}\)。\((\mathbf x(0),\mathbf x(1))\) 就是一個合法的配對。由 Cauchy–Schwarz(和 B16 一樣),
$$\Vert\mathbf x(1)-\mathbf x(0)\Vert^2=\Big\Vert\int_0^1\dot{\mathbf x}(t)\,dt\Big\Vert^2\le\int_0^1\Vert\dot{\mathbf x}(t)\Vert^2dt.$$取期望,右邊是動能 \(\int\!\!\int\Vert\mathbf v_t\Vert^2p_t\),左邊不小於 \(\mathcal W_2^2\)。所以每個動態候選的動能 \(\ge\mathcal W_2^2\)。另一半:McCann 插值等速直線走,Cauchy–Schwarz 取等號,動能恰好是 \(\mathbb E\Vert\mathbf T^*(\mathbf x)-\mathbf x\Vert^2=\mathcal W_2^2\),所以下界達到。這和 B14 Reflow 的成本論證是同一個不等式。
OT 映射 \(\mathbf T^*\) 滿足 Monge–Ampère 方程:
$$p_{\text{tgt}}\big(\nabla\psi(\mathbf x)\big)\,\det\big(\nabla^2\psi(\mathbf x)\big)=p_{\text{src}}(\mathbf x),$$其中由 Brenier 定理,對某個凸函數 \(\psi\),\(\mathbf T^*(\mathbf x)=\nabla\psi(\mathbf x)\)。但這個非線性偏微分方程通常沒辦法求出顯式解。注意這正是 normalizing flow 使用的變數變換關係(B11):flow 參數化一個雅可比行列式好算的可逆運送映射,但一般不強加「位勢的梯度」\(\mathbf T^*=\nabla\psi\) 這個結構;所以一個訓練好的 flow 可能和 Brenier/OT 映射差很多。
Monge–Ampère 就是變數變換
\(\mathbf T_\#p_{\text{src}}=p_{\text{tgt}}\) 用 B11 的變數變換寫:\(p_{\text{src}}(\mathbf x)=p_{\text{tgt}}(\mathbf T(\mathbf x))\,|\det\nabla\mathbf T(\mathbf x)|\)。代入 \(\mathbf T=\nabla\psi\):\(\nabla\mathbf T=\nabla^2\psi\) 是 Hessian;\(\psi\) 凸,所以 Hessian 半正定、行列式非負,絕對值可以拿掉。「OT」多出的資訊只有一句:\(\mathbf T\) 是一個凸函數的梯度。任何滿足變數變換的可逆映射都推得過去;在所有這些映射裡,只有梯度形式的那一個是二次成本最佳的。
04熵正則化的最佳運送(EOT)書 §7.2.2
為了具體地引出 EOT,考慮由樣本建成的經驗分佈。假設 \(p_{\text{src}}\) 支撐在點 \(\{\mathbf x^{(i)}\}_{i=1}^n\subset\mathbb R^D\) 上、權重 \(a_i\),\(p_{\text{tgt}}\) 支撐在 \(\{\mathbf y^{(j)}\}_{j=1}^n\) 上、權重 \(b_j\)。配對就是一個 \(n\times n\) 的非負矩陣 \(\gamma=(\gamma_{ij})\),列和等於 \(a\)、行和等於 \(b\);每個元素 \(\gamma_{ij}\) 是從 \(\mathbf x^{(i)}\) 運到 \(\mathbf y^{(j)}\) 的質量。(書的註腳:經驗(離散)測度是連續分佈有原則的替身。成本是 \(c(x,y)=d(x,y)^p\)(所以 OT 值等於 \(W_p^p\))且測度有有限的 \(p\) 階動差時,經驗測度在 \(W_p\) 下以定量的速率收斂到母體;見 Fournier & Guillin (2015) 和 Peyré & Cuturi (2019) 的綜述。)
為什麼要正則化?
這個離散設定下的古典 OT(在連續形式裡取計數測度)化成在所有可行配對上最小化 \(\sum_{i,j}C_{ij}\gamma_{ij}\),其中 \(C_{ij}=c(\mathbf x^{(i)},\mathbf y^{(j)})\) 是把一單位質量從 \(\mathbf x^{(i)}\) 搬到 \(\mathbf y^{(j)}\) 的成本,\(c:\mathbb R^D\times\mathbb R^D\to\mathbb R_{\ge0}\) 是指定的地面成本(例如 \(\Vert\mathbf x-\mathbf y\Vert_2^2\))。這會遇到兩個主要問題:
- 不唯一與不穩定。最小化解 \(\gamma^*\) 不一定唯一。例如兩個運送計畫達到同樣的最小成本時,求解器可能選任何一個。所以輸入 \((a,b,C)\) 的小改變(移動一個樣本、調整權重、稍微擾動成本)可能讓解突然跳動。
- 計算成本高。這是一個有 \(n^2\) 個變數、\(2n\) 條限制的線性規劃。實務的求解器(匈牙利演算法,Kuhn 1955、Munkres 1957;網路單純形法)通常是 \(\mathcal O(n^3)\),\(n\) 大時不可行。
為了克服這些瓶頸,EOT 的目標函數在古典 OT 問題上加一個正則化項,由參數 \(\varepsilon>0\) 控制:
參考測度 \(M\) 通常取成邊際的乘積 \(p_{\text{src}}\otimes p_{\text{tgt}}\)。KL 項和運送計畫 \(\gamma\) 的 Shannon 熵直接相關:\(\mathcal D_{\text{KL}}(\gamma\Vert p_{\text{src}}\otimes p_{\text{tgt}})=-\mathcal H(\gamma)+\text{常數}\),其中 \(\mathcal H(\gamma):=-\int\gamma(\mathbf x,\mathbf y)\log\gamma(\mathbf x,\mathbf y)\,d\mathbf x\,d\mathbf y\)。
為什麼差的是常數
第二、三項只依賴 \(\gamma\) 的邊際,而邊際在可行集裡是固定的 \(p\)、\(q\),所以是常數。
熵正則化為什麼有幫助?
- 把質量攤開。\(t\mapsto t\log t\) 是凸的,而且 \(t\) 大時增長很快,所以最小化 \(\int\gamma\log\gamma\) 懲罰尖銳的配對(某些 \(\gamma(\mathbf x,\mathbf y)\) 很大、大部分接近零)。在總質量 \(\int\gamma=1\) 固定下,它偏好 \(\gamma(\mathbf x,\mathbf y)\) 在 \(\mathbb R^D\times\mathbb R^D\) 上分佈得比較均勻的計畫。等價地,最大化 Shannon 熵提升「不確定性」(擴散程度)。
- 嚴格凸與唯一性。因為 \(\mathcal H\) 嚴格凹,目標對 \(\gamma\) 嚴格凸,得到一個唯一的最小化解 \(\gamma_\varepsilon^*\),而且連續地依賴 \((p_{\text{src}},p_{\text{tgt}},c)\)。
- Sinkhorn 形式與正值。在溫和的條件下(書的註腳:假設 \(c<\infty\) 對 \(p_{\text{src}}\otimes p_{\text{tgt}}\) 幾乎處處成立、邊際的核積分有限且為正;並為了簡單,只看 \(\gamma_\varepsilon^*\)、\(p_{\text{src}}\)、\(p_{\text{tgt}}\) 都有 Lebesgue 密度的情形),最佳解有 Schrödinger/Sinkhorn 形式 $$\gamma_\varepsilon^*(\mathbf x,\mathbf y)=u(\mathbf x)\,\exp\Big(-\frac{c(\mathbf x,\mathbf y)}\varepsilon\Big)\,v(\mathbf y)\,p_{\text{src}}(\mathbf x)\,p_{\text{tgt}}(\mathbf y),$$ 其中 \(u\)、\(v\) 是正的縮放函數(差一個整體的常數因子是唯一的)。實務上連續的形式用有限樣本近似,EOT 化成有限(抽樣)的 Sinkhorn 迭代。熵目標嚴格凸,縮放(Sinkhorn/IPFP)演算法能有效率地求解(Sinkhorn 1964;Cuturi 2013)。對每個邊際有 \(n\) 個支撐點的稠密問題(一個 \(n\times n\) 的核),每次 Sinkhorn 迭代花 \(\mathcal O(n^2)\) 時間和 \(\mathcal O(n^2)\) 記憶體,讓方法更可擴展、更實用(Altschuler et al. 2017)。
- \(\varepsilon\) 的極限。\(\varepsilon\to0\) 時,最佳計畫 \(\gamma_\varepsilon^*\) 越來越集中,趨近一個(可能是奇異的)古典 OT 配對(B19 會回到這個連結)。\(\varepsilon\) 增大時,\(\gamma_\varepsilon^*\) 逐漸攤開,趨近獨立配對 \(p_{\text{src}}\otimes p_{\text{tgt}}\)。
Sinkhorn 形式從哪來,以及 Sinkhorn 迭代在做什麼
對密度 \(\gamma\) 寫 Lagrangian,用 \(f(\mathbf x)\)、\(g(\mathbf y)\) 處理兩條邊際限制:
$$\int c\,\gamma+\varepsilon\int\gamma\log\frac{\gamma}{p\,q}-\int f(\mathbf x)\Big(\int\gamma\,d\mathbf y-p(\mathbf x)\Big)-\int g(\mathbf y)\Big(\int\gamma\,d\mathbf x-q(\mathbf y)\Big).$$對 \(\gamma(\mathbf x,\mathbf y)\) 逐點微分設為 0:\(c+\varepsilon\big(\log\frac{\gamma}{pq}+1\big)-f-g=0\),所以 \(\gamma=p\,q\,e^{(f-\varepsilon)/\varepsilon}\,e^{-c/\varepsilon}\,e^{g/\varepsilon}\),正是 \(u(\mathbf x)e^{-c/\varepsilon}v(\mathbf y)p\,q\) 的形式,\(u=e^{f/\varepsilon-1}\)、\(v=e^{g/\varepsilon}\)。\(u\)、\(v\) 由兩條邊際限制決定:\(u(\mathbf x)\int e^{-c/\varepsilon}v\,q\,d\mathbf y=1\)、\(v(\mathbf y)\int e^{-c/\varepsilon}u\,p\,d\mathbf x=1\)。Sinkhorn 迭代就是輪流用這兩條式子更新 \(u\) 和 \(v\):先調列讓列和對、再調行讓行和對,反覆進行。每一步是一次 \(n\times n\) 的矩陣–向量乘法。\(\varepsilon\) 很小時 \(e^{-c/\varepsilon}\) 會下溢,Demo A 改在對數空間做同樣的更新。
Demo A精確的 OT 與 Sinkhorn 的 EOT轉述者補充
仿照書中的圖:左邊 40 個來源點(兩團),右邊 40 個目標點(三團),每點權重 \(1/40\),成本 \(\Vert\mathbf x-\mathbf y\Vert^2\)。精確的 OT 用匈牙利演算法(\(\mathcal O(n^3)\);權重相等時最佳解是一個排列);EOT 用對數空間的 Sinkhorn。灰線的深淺是 \(40\gamma_{ij}\),也就是來源點 \(i\) 被送到目標點 \(j\) 的條件機率。下圖是 \(40\times40\) 的計畫矩陣(列:來源,行:目標;依團排序;深淺相對於最大的元素)。
先看三個極端。獨立配對(成本 30.875):每個來源點以相同機率送到 40 個目標點,畫面是一片交叉的灰霧,就是書中的左圖。精確 OT(成本 26.574):40 條線、互不交叉,上面那團主要去右上和右中,下面那團去右中和右下,就是書中的右圖。Sinkhorn 夾在兩者之間。瀏覽器實測:
| \(\varepsilon\) | 0.032 | 0.1 | 0.32 | 1 | 3.2 | 10 | 32 | 100 |
|---|---|---|---|---|---|---|---|---|
| 成本 | 26.585 | 26.623 | 26.750 | 27.056 | 27.710 | 29.250 | 30.312 | 30.695 |
| KL(γ‖p⊗q) | 2.544 | 1.928 | 1.250 | 0.707 | 0.358 | 0.077 | 0.009 | 0.001 |
這就是第 4 節最後一點「\(\varepsilon\) 的極限」:\(\varepsilon\to0\) 時成本趨近 OT 的 26.574,\(\varepsilon\) 大時趨近獨立配對的 30.875,KL 從接近排列的值降到 0。兩者在每個 \(\varepsilon\) 都是一個取捨:多花一點成本,換來更攤開(熵更大)的配對。所有 \(\varepsilon\) 下 Sinkhorn 的邊際誤差都不超過 \(4\times10^{-10}\)(最大的是 \(\varepsilon=0.032\),\(\varepsilon\ge0.1\) 時在 \(10^{-14}\) 以下)。計算量的對比也看得到:\(\varepsilon\ge1\) 時 Sinkhorn 幾毫秒就收斂,\(\varepsilon\) 很小時需要幾千次迭代(約 0.1 秒),這是 \(\varepsilon\to0\) 的實務代價。
05Schrödinger bridge(SB)書 §7.2.3
SB 的 KL 形式
Schrödinger 在 1930 年代提出的 Schrödinger bridge(SB)問題問的是:假設粒子依照某個簡單的參考動態移動,例如布朗運動。現在我們在兩個時刻觀察這些粒子:\(t=0\) 時分佈是 \(p_{\text{src}}\),\(t=1\) 時是 \(p_{\text{tgt}}\)。在所有連接這兩個分佈的隨機過程中,哪一個偏離參考動態最少?「偏離」用 KL 散度衡量,所以 SB 問題的解是「把布朗運動變形成滿足指定邊界條件的過程」最可能的方式。
精確地說,令 \(\mathbf x_{0:T}:=\{\mathbf x_t\}_{t\in[0,T]}\) 是過程的一條完整軌跡,\(P\) 表示軌跡的分佈(path law),也就是整條樣本路徑上的機率分佈。\(P\) 在時間 \(t\) 的邊際記作 \(p_t\)(或 \(P_t\)),描述單一時刻狀態的分佈:對可測集 \(A\subseteq\mathbb R^D\),\(p_t(A)=P(\mathbf x_t\in A)\)。換句話說,\(p_t\) 可以看成:從 \(P\) 抽很多完整軌跡,收集它們在時間 \(t\) 的狀態,得到的經驗分佈(一維時就是直方圖)。
考慮一個由 SDE 支配的參考 diffusion \(\{\mathbf x_t\}_{t\in[0,T]}\):
$$d\mathbf x_t=\mathbf f(\mathbf x_t,t)\,dt+g(t)\,d\mathbf w_t,$$\(\mathbf f:\mathbb R^D\times[0,T]\to\mathbb R^D\)、\(g:[0,T]\to\mathbb R\),\(\{\mathbf w_t\}\) 是標準布朗運動。令 \(R\) 是整條軌跡 \(\mathbf x_{0:T}\) 的分佈(聯合分佈),\(R_0\) 是參考過程的初始邊際;這個 \(R\) 是參考的軌跡分佈。SB 問題找一個在 KL 散度下最接近 \(R\)、同時匹配指定端點邊際的軌跡分佈 \(P\):
最佳解 \(P^*\) 依賴選定的參考過程 \(R\)。
SB 的隨機控制觀點
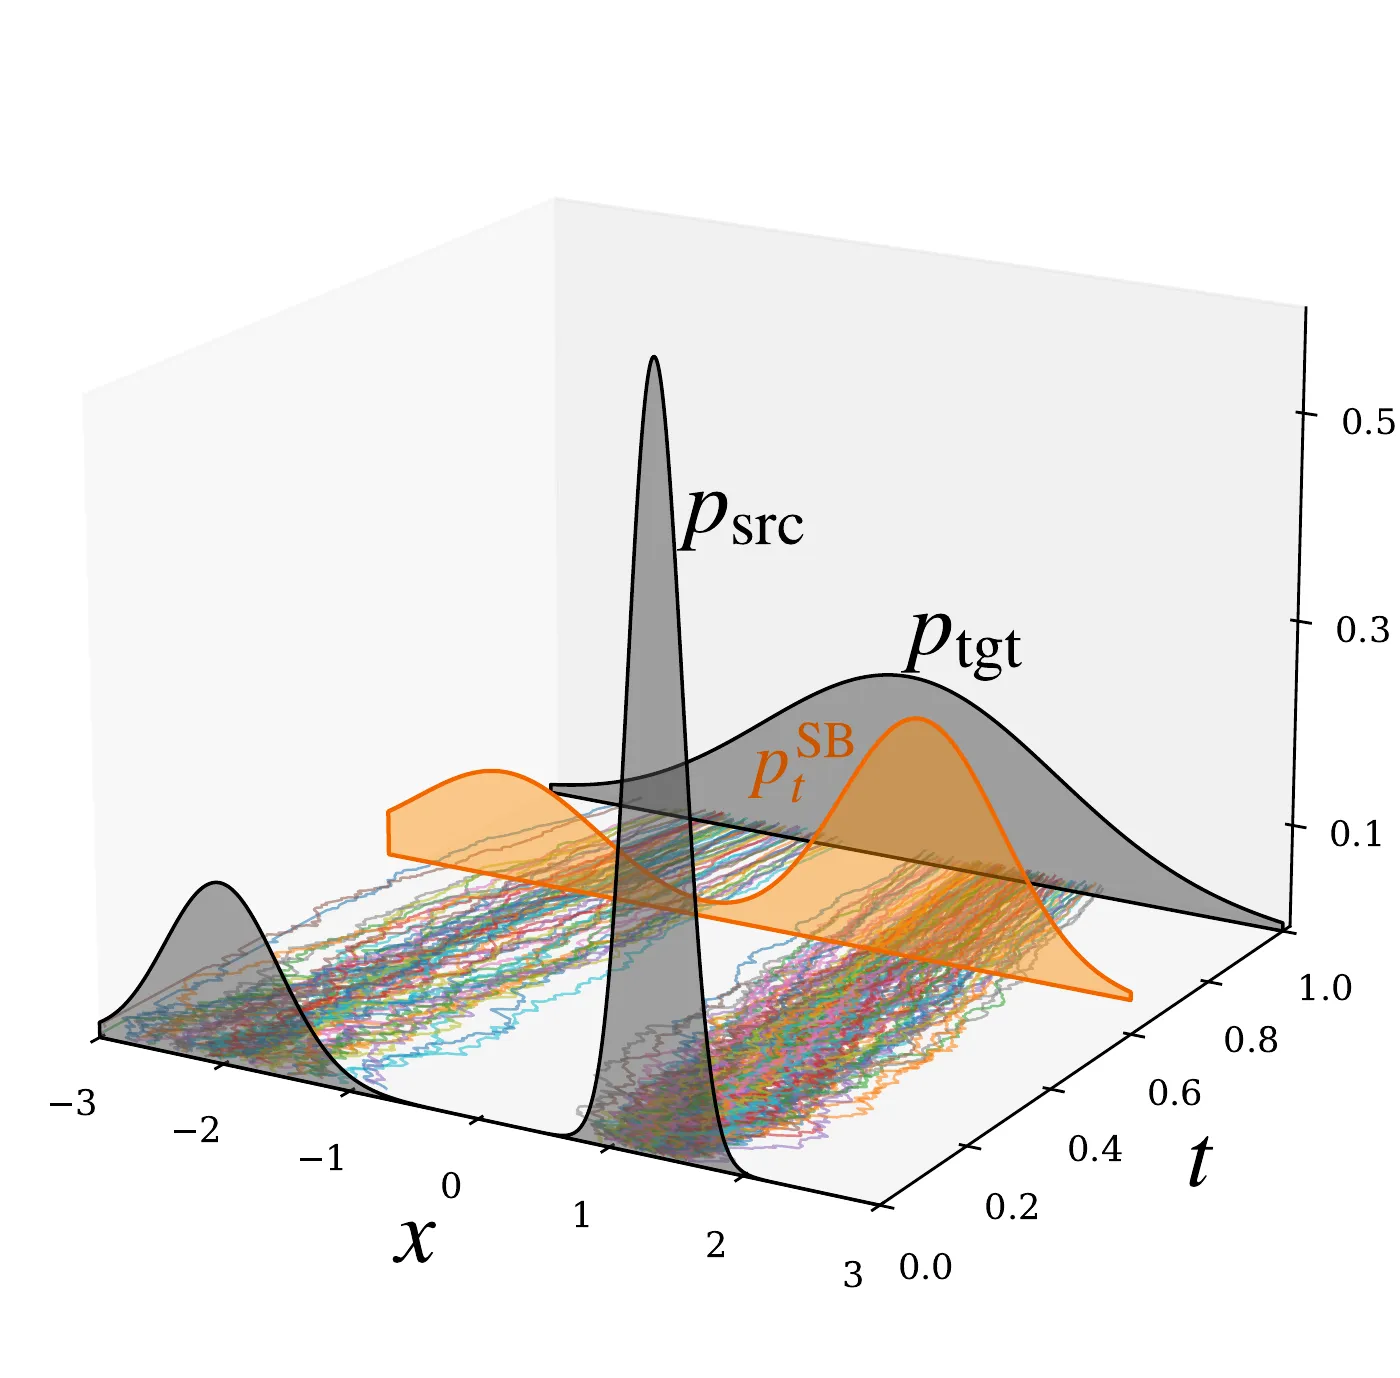
與其在任意的路徑分佈 \(P\) 上最佳化,比較好處理的做法是以參考動態為錨,允許它漂移:引入一個隨時間變化的漂移 \(\mathbf v_t(\mathbf x_t)\) 擾動參考過程,產生一族候選的軌跡分佈。得到的動態是一個受控 diffusion:
$$d\mathbf x_t=\big[\mathbf f(\mathbf x_t,t)+\mathbf v_t(\mathbf x_t)\big]dt+g(t)\,d\mathbf w_t,$$\(\mathbf v_t:\mathbb R^D\to\mathbb R^D\) 是之後要最佳化的漂移。在標準的可積條件下(例如 Novikov 條件),由 Girsanov 定理(書附錄 C,B35),受控分佈 \(P\) 和參考 \(R\) 之間的 KL 散度有動態(動能)形式:
$$\mathcal D_{\text{KL}}(P\Vert R)=\mathcal D_{\text{KL}}(p_{\text{src}}\Vert R_0)+\mathbb E_P\Big[\frac12\int_0^T\frac{\Vert\mathbf v_t(\mathbf x_t)\Vert^2}{g^2(t)}\,dt\Big]=\mathcal D_{\text{KL}}(p_{\text{src}}\Vert R_0)+\frac12\int_0^T\!\!\int_{\mathbb R^D}\frac{\Vert\mathbf v_t(\mathbf x)\Vert^2}{g^2(t)}\,p_t(\mathbf x)\,d\mathbf x\,dt,$$\(p_t\) 是受控過程中 \(\mathbf x_t\) 在時間 \(t\) 的邊際;第二個等號來自全期望定律。因為 SB 問題裡 \(P_0=p_{\text{src}}\) 固定,第一項對控制而言是常數,可以從最佳化中拿掉;特別是 \(R_0=p_{\text{src}}\) 時它等於 0。
Girsanov 那一行的直覺(正式推導在 B35)
在一小段時間 \(\Delta t\) 內,參考過程的一步是 \(\mathcal N(\mathbf x+\mathbf f\Delta t,\,g^2\Delta t\,\mathbf I)\),受控過程的一步是 \(\mathcal N(\mathbf x+(\mathbf f+\mathbf v)\Delta t,\,g^2\Delta t\,\mathbf I)\)。兩個變異數相同、平均差 \(\mathbf v\Delta t\) 的高斯,KL 是 \(\frac{\Vert\mathbf v\Delta t\Vert^2}{2g^2\Delta t}=\frac{\Vert\mathbf v\Vert^2}{2g^2}\Delta t\)。路徑的 KL 是每一步 KL 的總和(鏈式法則),加上起點分佈的 KL;讓 \(\Delta t\to0\),就是上式。所以「離參考多遠」等於「為了改變漂移花了多少能量」,以雜訊的強度 \(g^2\) 為單位:雜訊越大,同樣的漂移改變越便宜。
因此,SB 問題可以改寫成:在所有把過程從 \(t=0\) 的 \(p_{\text{src}}\) 推到 \(t=T\) 的 \(p_{\text{tgt}}\) 的合法漂移 \(\mathbf v_t\) 中,最小化期望的控制能量(Dai Pra 1991;Dai Pra & Pavon 1990;Pavon & Wakolbinger 1991;Chen et al. 2016)。因為初始邊際固定為 \(p_{\text{src}}\),可以取參考過程使 \(R_0=p_{\text{src}}\) 而不改變最佳解;這時 \(\mathcal D_{\text{KL}}(p_{\text{src}}\Vert R_0)=0\)。這導出隨機控制形式:
重要的是,端點分佈 \(p_{\text{src}}\)、\(p_{\text{tgt}}\) 是任意的;控制 \(\mathbf v_t\) 被選來「橋接」兩個邊際之間的參考動態,同時在 KL 散度下盡量貼近參考過程 \(R\)。
特殊的布朗運動參考
上式和 Benamou–Brenier 形式很像,特別是當參考過程 \(R^\varepsilon\)(\(\varepsilon>0\))取成布朗運動 \(d\mathbf x_t=\sqrt\varepsilon\,d\mathbf w_t\),也就是 \(\mathbf f\equiv\mathbf 0\)、\(g(t)\equiv\sqrt\varepsilon\) 時。這時 SB 問題找一個在 KL 散度下最接近布朗參考 \(R^\varepsilon\)、又匹配端點邊際的路徑分佈 \(P\):
$$\mathrm{SB}_\varepsilon(p_{\text{src}},p_{\text{tgt}}):=\min_P\ \mathcal D_{\text{KL}}(P\Vert R^\varepsilon)\qquad\text{s.t.}\qquad P_0=p_{\text{src}},\ P_T=p_{\text{tgt}}.$$等價的隨機控制形式是
$$\mathrm{SB}_\varepsilon(p_{\text{src}},p_{\text{tgt}})=\min_{\substack{\mathbf v_t\ \text{s.t.}\ d\mathbf x_t=\mathbf v_t(\mathbf x_t)dt+\sqrt\varepsilon\,d\mathbf w_t,\\ \mathbf x_0\sim p_{\text{src}},\ \mathbf x_T\sim p_{\text{tgt}}}}\ \frac1{2\varepsilon}\int_0^T\!\!\int_{\mathbb R^D}\Vert\mathbf v_t(\mathbf x)\Vert^2\,p_t(\mathbf x)\,d\mathbf x\,dt,$$\(p_t\) 是以漂移 \(\mathbf v_t\) 驅動的 diffusion \(d\mathbf x_t=\mathbf v_t(\mathbf x_t)dt+\sqrt\varepsilon\,d\mathbf w_t\) 在時間 \(t\) 的邊際。
書的註腳:這個相似可以說得精確。在一個等價的、時間對稱的流體力學形式中,若 \(\tilde{\mathbf v}_t\) 是滿足連續方程 \(\partial_t\rho_t+\nabla\cdot(\rho_t\tilde{\mathbf v}_t)=0\) 的「流速」(current velocity),則布朗參考的 SB 目標可以寫成一個 Benamou–Brenier 型的動能項(差一個慣例上的常數因子),加上一個 Fisher 資訊項:\(\int_0^T\!\int\big[\frac12\Vert\tilde{\mathbf v}_t(\mathbf x)\Vert^2+\frac{\varepsilon^2}8\Vert\nabla_{\mathbf x}\log\rho_t(\mathbf x)\Vert^2\big]\rho_t(\mathbf x)\,d\mathbf x\,dt\)。所以在布朗參考/二次成本的情形,熵 OT 可以看成 Fisher 資訊正則化的動態 OT;見 Chen et al. (2021) 的 Problem 4.6。
布朗參考的 SB 為什麼就是一個 EOT(預告 B19,轉述者整理)
路徑分佈可以拆成「端點的聯合分佈」乘「給定兩端之後的橋」:\(\mathcal D_{\text{KL}}(P\Vert R)=\mathcal D_{\text{KL}}(P_{0T}\Vert R_{0T})+\mathbb E_{P_{0T}}\big[\mathcal D_{\text{KL}}(P_{\cdot\mid0,T}\Vert R_{\cdot\mid0,T})\big]\)。第二項可以取 0:最佳解在給定兩端時就用參考的橋(布朗運動的話是布朗橋)。剩下的是對端點聯合分佈的問題。布朗參考從 \(R_0=p_{\text{src}}\) 出發時,\(R_{0T}(\mathbf x,\mathbf y)=p_{\text{src}}(\mathbf x)\,\mathcal N(\mathbf y;\mathbf x,\varepsilon T\mathbf I)\),所以
$$\mathcal D_{\text{KL}}(P_{0T}\Vert R_{0T})=\frac1{2\varepsilon T}\mathbb E_{P_{0T}}\Vert\mathbf x-\mathbf y\Vert^2+\mathcal D_{\text{KL}}(P_{0T}\Vert p_{\text{src}}\otimes p_{\text{tgt}})+\text{常數}.$$乘上 \(2\varepsilon T\):最小化它等於解成本 \(\Vert\mathbf x-\mathbf y\Vert^2\)、正則化係數 \(2\varepsilon T\) 的 EOT。Demo B 就是這樣算 SB 的:先用 Sinkhorn 解端點的 EOT,再在每一對端點之間畫布朗橋。B19 會正式處理 SB 和 EOT 的等價。
為什麼要指定一個參考分佈?
古典 OT 不需要參考的路徑分佈,因為指定的地面成本已經說明了把一個來源點配到一個目標點有多貴,最佳化直接透過這個成本比較合法的配對。但在 SB 問題裡,我們比較的是整條隨機軌跡,而不只是端點。因此需要一個參考路徑測度 \(R\),指定未受控的動態平常長什麼樣子;\(\mathcal D_{\text{KL}}(P\Vert R)\) 衡量一個合法的過程 \(P\) 為了滿足指定的端點分佈,必須偏離這個參考動態多少。
耦合偏微分方程的刻畫
描述 SB 解的一個方便方式是透過兩個時空位勢 \(\Psi(\mathbf x,t)\) 和 \(\widehat\Psi(\mathbf x,t)\)。令 \(p_t^{\text{SB}}\) 是最佳軌跡分佈 \(P^*\) 在時間 \(t\in[0,T]\) 的邊際,則有對稱的分解(Dai Pra 1991)
$$p_t^{\text{SB}}(\mathbf x)=\Psi(\mathbf x,t)\,\widehat\Psi(\mathbf x,t),$$其中 \(\Psi\) 和 \(\widehat\Psi\) 解(線性的)Schrödinger 系統(Caluya & Halder 2021;Chen et al. 2021;Chen et al. 2022):
兩條方程各是什麼(轉述者補充)
第二條是參考過程的 Fokker–Planck 方程(B09):\(\widehat\Psi\) 像一個「從起點往前傳播的密度」。第一條是參考過程的 Kolmogorov 反向方程:\(\Psi\) 像一個「從終點往回傳播的條件期望」,它的時間方向和擴散符號相反,所以要從 \(T\) 往回解才穩定。兩者都是線性的,難處在於耦合的邊界條件:兩端都只知道乘積 \(\Psi\widehat\Psi\),不知道各自是多少,得反覆調整。這和 Sinkhorn 輪流調 \(u\)、\(v\) 是同一件事,\(u\)、\(v\) 就是 \(t=0\)、\(t=T\) 的兩個位勢。
前向時間的 SB SDE。知道 \(\Psi\) 之後,最佳動態是被時空因子 \(\Psi\) 傾斜的參考 diffusion:
$$d\mathbf x_t=\big[\mathbf f(\mathbf x_t,t)+g^2(t)\,\nabla_{\mathbf x}\log\Psi(\mathbf x_t,t)\big]dt+g(t)\,d\mathbf w_t,\qquad\mathbf x_0\sim p_{\text{src}}.$$令 \(Q\) 是這個 SDE 的軌跡分佈(由分解式和 Schrödinger 系統,\(Q_0=p_{\text{src}}\)、\(Q_T=p_{\text{tgt}}\))。則 \(Q=P^*\),隨機控制問題的最小化解是(Chen et al. 2021 §4.6)\(\mathbf v_t^*(\mathbf x)=g^2(t)\nabla_{\mathbf x}\log\Psi(\mathbf x,t)\)。也就是說,漂移修正 \(g^2\nabla_{\mathbf x}\log\Psi\) 正是為了匹配端點邊際、對參考所需要的最小 KL 擾動。
反向時間的 SB SDE。同一個最佳路徑分佈也可以倒著生成。看出反向漂移形式的方便方法,是在概念上使用 diffusion 的標準時間反轉恆等式
$$\mathbf b^-(\mathbf x,t)=\mathbf b^+(\mathbf x,t)-g^2(t)\nabla_{\mathbf x}\log p_t^{\text{SB}}(\mathbf x),$$其中 \(\mathbf b^+=\mathbf f+g^2\nabla\log\Psi\)、\(p_t=\Psi\widehat\Psi\)。這給出 \(\mathbf b^-(\mathbf x,t)=\mathbf f(\mathbf x,t)-g^2(t)\nabla_{\mathbf x}\log\widehat\Psi(\mathbf x,t)\),所以反向時間的 SDE 是
$$d\mathbf x_t=\big[\mathbf f(\mathbf x_t,t)-g^2(t)\,\nabla_{\mathbf x}\log\widehat\Psi(\mathbf x_t,t)\big]dt+g(t)\,d\bar{\mathbf w}_t,\qquad\mathbf x_T\sim p_{\text{tgt}}.$$等價地,重新參數化時間 \(\mathbf y_\tau:=\mathbf x_{T-\tau}\),讓 \(\tau\) 從 0 增加到 \(T\),則 \(\mathbf y_\tau\) 從 \(\mathbf y_0\sim p_{\text{tgt}}\) 對 \(\tau\) 往前演化:
$$d\mathbf y_\tau=\big[-\mathbf f(\mathbf y_\tau,T-\tau)+g^2(T-\tau)\,\nabla_{\mathbf y}\log\widehat\Psi(\mathbf y_\tau,T-\tau)\big]d\tau+g(T-\tau)\,d\mathbf w_\tau.$$前向和反向兩種描述給出同一個最佳路徑分佈 \(P^*\),由 \(\nabla\log p_t^{\text{SB}}=\nabla\log\Psi+\nabla\log\widehat\Psi\)、\(\mathbf b^-=\mathbf b^+-g^2\nabla\log p_t^{\text{SB}}\) 連起來,所以它們在每個時刻的邊際都和 \(p_t^{\text{SB}}\) 一致。額外的漂移項 \(g^2\nabla\log\Psi\)(前向)和 \(-g^2\nabla\log\widehat\Psi\)(反向)扮演控制力的角色:引導參考 diffusion 匹配端點邊際,同時在相對熵意義下最貼近參考。
反向漂移的那一步代數
對照 B08 的 diffusion:那裡沒有控制(\(\Psi\equiv1\)),前向漂移就是 \(\mathbf f\),\(p_t=\widehat\Psi\),反向漂移是 \(\mathbf f-g^2\nabla\log p_t\),正是 Anderson 的反向 SDE。SB 的不同在於兩個方向各有一個位勢,前向也被控制了。
耦合偏微分方程做法的實務障礙。要用反向 SB SDE 建構生成過程,必須解 Schrödinger 系統得到反向的 Schrödinger 位勢 \(\widehat\Psi\)。但這些偏微分方程以難解著稱,連低維都很困難,讓它們很難直接用在生成建模。為了繞過這一點,幾項工作提出替代的策略:用 Score SDE 的技巧反覆解每一個半橋問題(\(p_{\text{tgt}}\leftarrow p_{\text{src}}\) 和 \(p_{\text{tgt}}\rightarrow p_{\text{src}}\);De Bortoli et al. 2021);最佳化代理的概似下界(Chen et al. 2022;Liu et al. 2023);或基於「對 \((\mathbf x_0,\mathbf x_T)\sim p_{\text{src}}\otimes p_{\text{tgt}}\) 的樣本對,後驗 \(\mathbf x_t\mid\mathbf x_0,\mathbf x_T\) 有解析解」設計 simulation-free 的訓練(Liu et al. 2023)。書不深入技術細節,而在 §7.4(B19)簡短討論 diffusion model 和 SB 的連結。
Demo BSB 的路徑與 OT 的直線轉述者補充
仿照書中的兩張 3D 圖,一維:\(p_{\text{src}}=0.25\,\mathcal N(-2,0.35^2)+0.75\,\mathcal N(1.3,0.15^2)\)、\(p_{\text{tgt}}=\mathcal N(1,0.9^2)\),各抽 200 個樣本,\(T=1\)。OT:一維的精確 OT 是把排序後的樣本一一配對(分位數對分位數),路徑是直線。SB(布朗參考 \(d\mathbf x=\sqrt\varepsilon\,d\mathbf w\)):用上面補充框的結論,先以 Sinkhorn 解正則化係數 \(2\varepsilon\) 的 EOT 得到端點配對,再在每一對之間抽一條布朗橋。上圖是 60 條路徑;下圖是時刻 \(t\) 的直方圖。
\(\varepsilon=0\)(OT):每條路徑是直線,而且路徑互不交叉:左邊小峰的樣本去目標的左尾,右邊大峰的樣本攤開到其餘部分。這對應書中 OT 圖的彩色直線束。\(\varepsilon=5\):路徑劇烈抖動,兩團的軌跡混在一起,像書中 SB 圖的那束隨機路徑。瀏覽器實測的端點配對成本 \(\mathbb E|x_1-x_0|^2\):
| \(\varepsilon\) | 0(OT) | 0.05 | 0.3 | 1 | 5 |
|---|---|---|---|---|---|
| 端點成本 | 1.049 | 1.091 | 1.219 | 1.521 | 2.635 |
| \(t=0.7\) 的變異數 | 1.133 | 1.118 | 1.071 | 1.145 | 1.676 |
\(\varepsilon=0\) 的成本 1.049 就是這 200 對樣本的精確 \(W_2^2\)。\(\varepsilon\) 越大,端點配對越接近獨立(獨立配對的期望成本約 3.18),因為參考的布朗運動本身就會把粒子帶到遠處,配對不必那麼「省」。中間時刻的分佈也不同:\(\varepsilon=5\) 時 \(t=0.7\) 的變異數 1.676,比 OT 的 1.133 寬得多,對應書中橘色的 \(p_t^{\text{SB}}\) 比藍色的 \(p_t^{\text{OT}}\) 更寬。兩端的分佈則永遠是 \(p_{\text{src}}\)、\(p_{\text{tgt}}\)。小 \(\varepsilon\) 的幾列變異數沒有單調趨勢,差距在 200 個樣本的抽樣雜訊範圍內。
06全域 pushforward 與局部動態:深度生成模型的 OT 類比書 §7.2.4
從最佳運送的觀點(靜態的 OT 問題),可以用深度生成模型學一個從簡單先驗到資料的運送(pushforward)映射,也就是 \(\mathbf G_{\bm\phi\#}p_{\text{prior}}\approx p_{\text{data}}\)。雖然 \(\mathbf G_{\bm\phi}\) 一般不等於最佳運送映射(除了一些在適當條件下加上 OT 目標的工作,例如 Genevay et al. 2018、Onken et al. 2021),Benamou–Brenier 形式提供一個互補的動態觀點:與其直接學一個全域的映射,它把運送描述成由一個隨時間變化的局部向量場產生的連續流,在 \(p_{\text{prior}}\) 和 \(p_{\text{data}}\) 之間描出一條平滑的路徑。這個動態形式和「靜態的 Schrödinger bridge 問題 vs. 它的隨機控制版本」的關係平行:在後者,最佳配對由一個受控 diffusion 過程實現。生成建模裡也有類似的類比:GAN 或 VAE 這類標準的深度生成模型學一個全域的 pushforward 映射,而 diffusion model 學一個驅動生成動態的、隨時間變化的局部向量場。
| 物件 | 確定性? | 描述什麼 | 最佳化什麼 | 生成模型的類比 |
|---|---|---|---|---|
| 配對 \(\gamma\) | 不一定 | 端點怎麼配 | OT:\(\mathbb E_\gamma c\);EOT:再加 \(\varepsilon\,\mathrm{KL}\) | (Reflow 改的就是它,B14) |
| 映射 \(\mathbf T\) | 是 | 每個點送到哪 | Monge:\(\mathbb E\Vert\mathbf T(\mathbf x)-\mathbf x\Vert^2\) | GAN、VAE 的生成器、NF |
| 流 \((p_t,\mathbf v_t)\) | 是 | 沿途怎麼走 | Benamou–Brenier:動能 | neural ODE、flow matching、PF-ODE |
| 受控 diffusion \(P\) | 否 | 沿途怎麼隨機地走 | SB:\(\mathrm{KL}(P\Vert R)\),即控制能量 | Score SDE 的反向 SDE |